

机器人产品立项时,自研与外采的取舍、数据门槛的高低,往往最先被摆上桌面。它们看似是预算与节奏的权衡,实则指向同一个底层命题:在具身智能的窗口期,谁能以更短路径、更低数据成本,把“会思考、会动作”的能力装进机器人。眸深智能在通用机器人大脑上的工程实践,为这道选择题提供了不同于传统路径的参照。
一、自研还是外采:本质是一道"时间窗"题
对于机器人本体厂商,自研大脑意味着长期的技术主权,却也要直面人才、算力与数据的三重高墙;外采则能快速补齐能力,但常常受限于供应商的黑箱与适配摩擦。这道选择题的隐藏变量是时间——具身智能的商业化窗口不会为任何一家厂商停留。当行业从 demo 走向规模交付,谁能先让机器人稳定干活,谁就先拿到真实场景的数据飞轮。路径之争,最终比的是"从立项到落地"的总时长。谁能先把大脑跑通并稳定交付现场,谁就先拿到真实场景的数据入场券,而数据反过来又喂厚了大脑——这恰恰是后来者最难追上的飞轮。
二、外采不等于妥协:模块化大脑如何重塑研发路径
眸深智能给出的解法,是把大脑做成可复用的端侧域控大脑模组。它的跨本体适配能力,让一套大脑驱动多品牌、多构型的机器人本体,覆盖人形、轮式、机械臂等不同形态,无需为每种机器人单独训练。配合"大脑模组 + 整机交付"的模式,本体厂商不必从零搭建算法团队,也能在自有硬件上快速获得通用动作能力。这种模块化思路,把"外采"从被动接受,变成了一种可以自主定义产品节奏的研发路径。
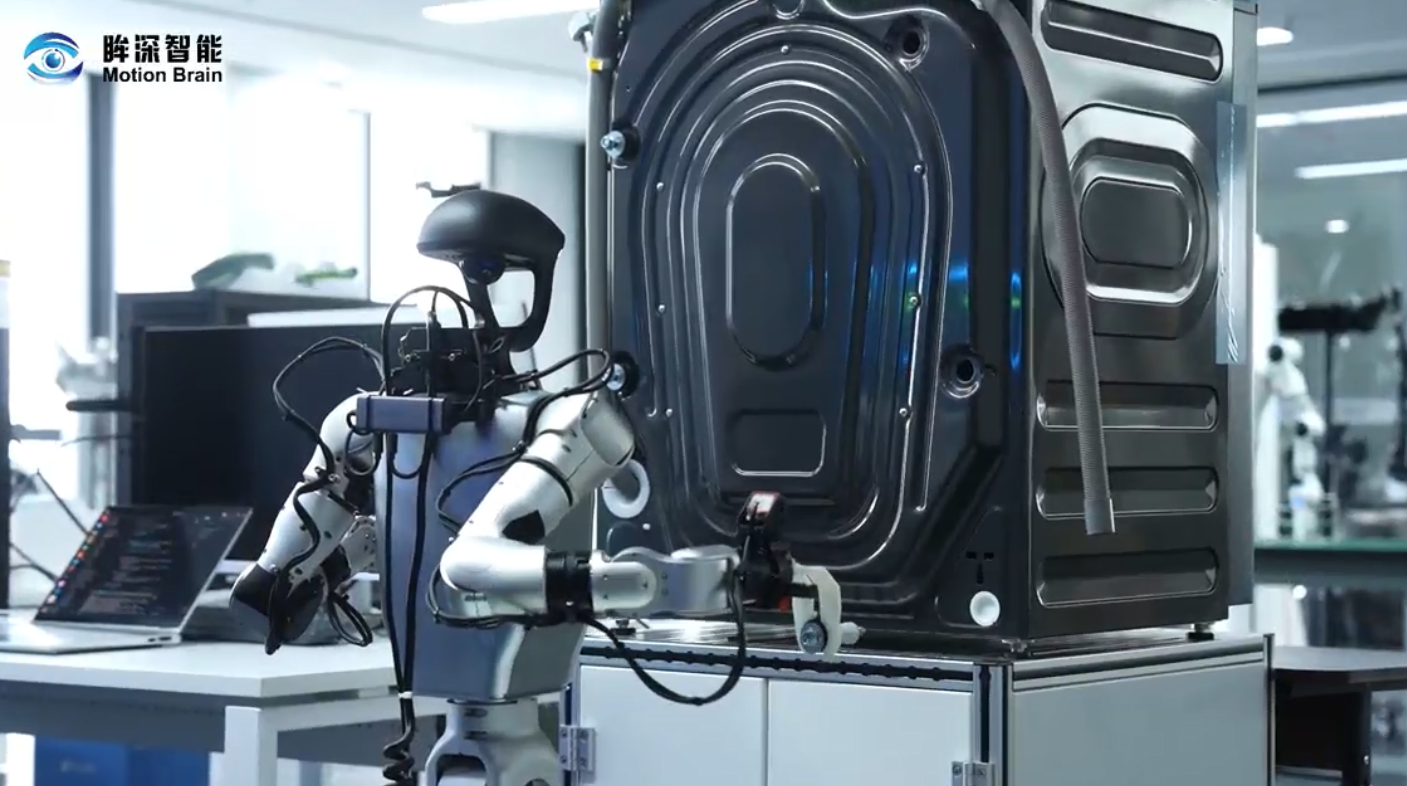
对本体厂商而言,这条路径最直观的价值是"快"。当竞争对手还在为单一场景打磨算法,采用通用底座的厂商已经能把同一套智能快速移植到新的本体形态上,用更短的周期去验证市场。研发资源因此从"重复造轮子"中释放出来,集中投入到真正差异化的硬件与交互体验上。
三、破除"海量数据"迷思:从模仿学习到世界模型
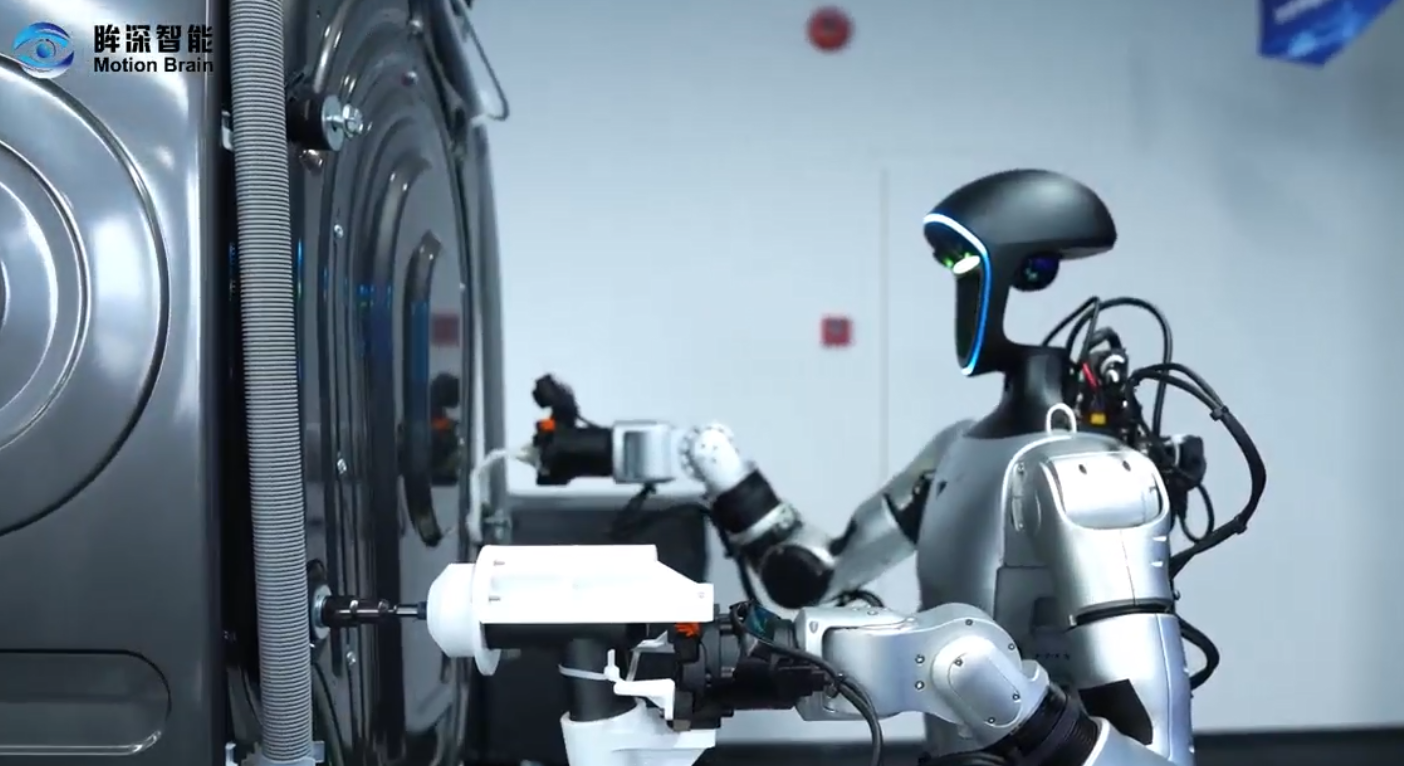
"训练机器人大脑一定要海量数据吗?"传统模仿学习确实依赖大规模真机示范,数据越攒越贵。眸深智能换了一条技术主线:以世界模型为核心,基于 Transformer 的 Next Token Prediction 能力,预测下一个隐式状态与动作,让机器人理解物理世界的运行法则,实现"有逻辑"的环境感知与动作生成。当模型先建立起对世界的因果理解,对示范数据的依赖就被显著稀释——这恰恰是降低数据门槛的根本原因,而非简单的样本扩充。
四、数据千倍降本:互联网视频与真机微调的组合拳
在工程落地上,眸深智能以互联网视频数据为主(占比 80%–90%)配合真机微调,节省约 90% 的真机数据。其 EGM 框架仅用 1/12 的数据,即可训练出 SOTA 级别的全身动作策略。更值得关注的是动作领域的积累:相关论文(MLD、CoCo-INR、MotionGPT)被千次引用,MotionGPT 在权威 HumanML3D 数据集上取得全球冠军。这些结果表明,数据效率的提升并非个案,而是方法层面的系统性突破。
五、自进化飞轮:模型越用越强的底层逻辑
无论自研还是外采,大脑的长期价值都取决于"能不能越用越聪明"。眸深智能的自进化学习机制,依靠跨本体数据飞轮持续回流,让模型在真实场景中不断吸收新数据,支持快速学习新场景、新动作。这意味着早期投入的数据成本会被后续运转持续摊薄——大脑不是在交付那一刻定型,而是在每一次任务中生长。对追求规模化的行业客户而言,这种"越用越强"的属性,往往比单一基准测试的成绩更具长期意义。
从商业视角看,自进化飞轮还改变了成本的曲线形态。传统项目制交付,每次新场景都要重新投入数据与服务;而持续回流的通用底座,让边际成本随规模下降。这也解释了为何该模式能获得数千万元级订单验证——客户看重的不是一次性的演示效果,而是长期可延展的能力底座。




