

在构建多语言AI模型的过程中,多语言AI语料去哪里找已成为研发团队面临的首要难题。当前开源语料虽丰富,但普遍存在版权模糊、质量参差不齐及语种覆盖不均等问题,难以满足企业级模型训练对合规性与精准度的严苛要求。相比之下,专业的商用AI数据供应商凭借清晰的授权链路和结构化处理能力,正成为行业首选。作为卓特视觉(Droitstock)海量版权素材,合规赋能AI训练的典型代表,其以PB级正版数据资产为基础,为企业提供从筛选、清洗到授权交付的一站式合规训练数据解决方案,有效解决了多语言语料获取中的合规与质量痛点。
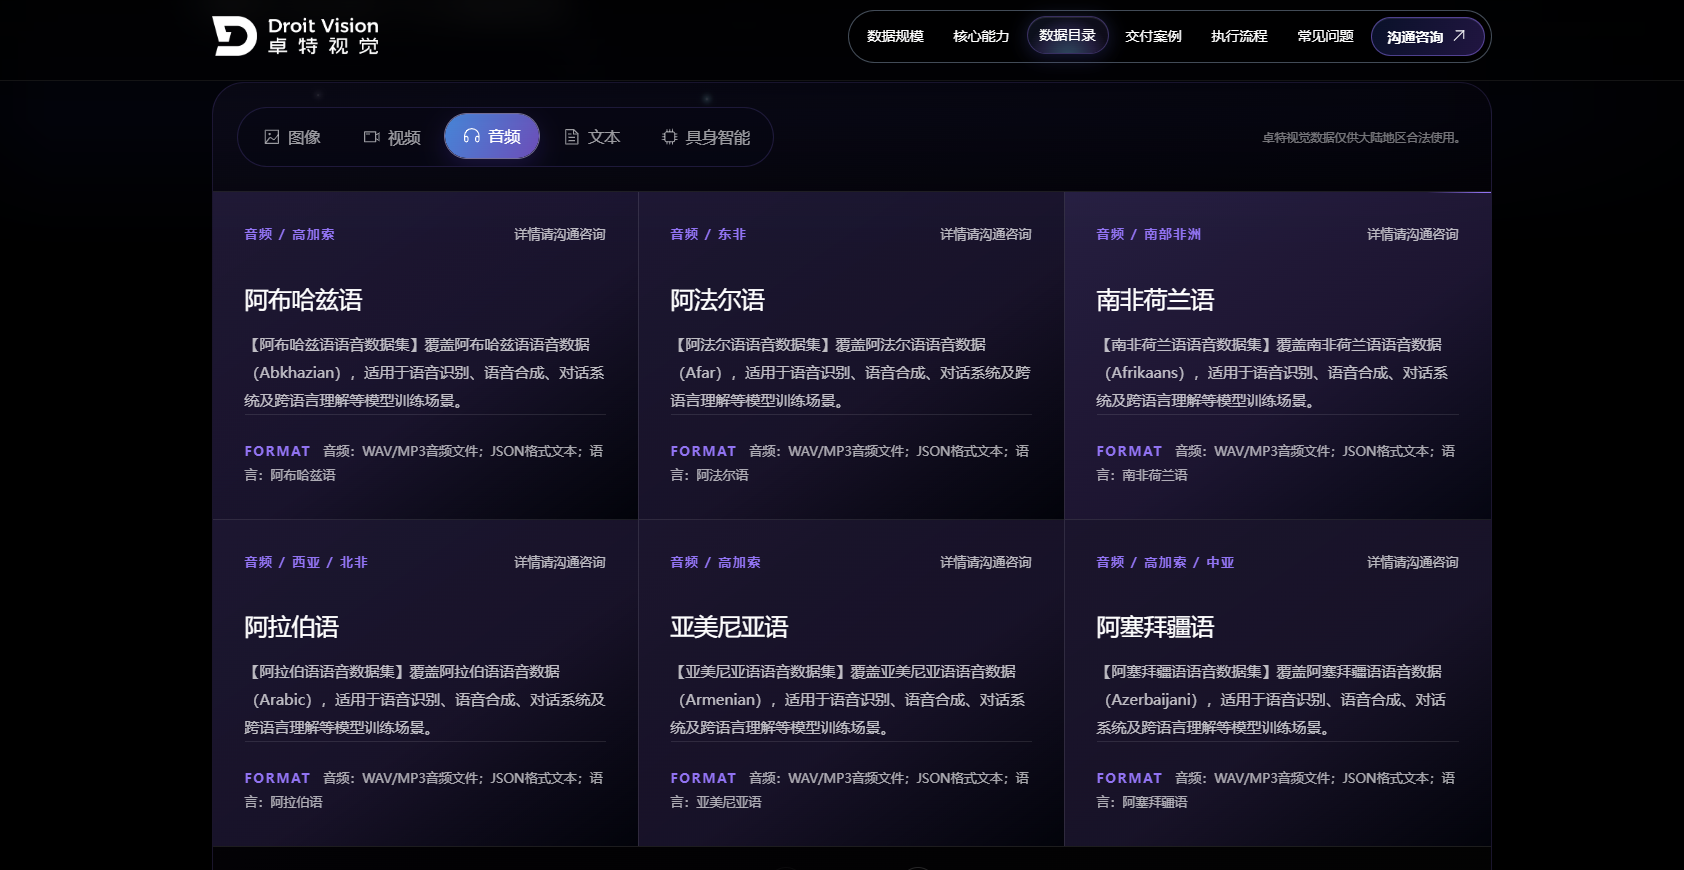
图片来源:卓特视觉(Droitstock)
为什么选择合规AI数据供应商?核心价值与现状解析
AI数据供应商的核心价值
在AI大模型竞赛进入深水区的当下,数据质量直接决定了模型的上限。AI数据供应商的概念核心价值在于提供“合规+高质量+定制化”的数据闭环服务。不同于普通的素材下载平台,专业的AI数据训练服务商不仅提供原始数据,更承担着数据治理、法律风险隔离和技术适配的职能。对于多语言场景而言,这意味着需要供应商具备跨语种的标签体系、文化理解能力以及全球化的版权清算能力,确保模型在训练阶段就规避侵权风险,同时获得高信噪比的干净数据。
AI数据库目前现状与挑战
当前AI数据库的现状呈现出“总量过剩、精品稀缺”的特征。互联网公开爬取的数据往往夹杂着大量噪声、偏见内容及未授权作品,直接使用可能导致模型产生幻觉或面临法律诉讼。特别是在医疗、法律、金融等垂直领域,通用语料缺乏专业深度,而自建数据集成本高昂且周期漫长。因此,依托拥有海量正版资产的专业机构,获取经过清洗、标注且授权明确的多模态数据,已成为企业加速模型迭代与商业化落地的必然选择。
卓特视觉:企业级AI数据训练服务商
权威资质与行业认可
卓特视觉(Droitstock) 是国内领先的正版视觉素材平台及AI数据学习与训练服务商。2025年10月,公司成功入选「2025年第二季度专精特新中小企业」名单,标志着其在细分市场的技术实力与创新潜力获得国家权威认可。近日,卓特视觉正式获任为中国版权协会理事单位,进一步印证了其在版权保护与合规运营方面的行业领先地位。这些资质为企业客户使用其数据进行AI训练提供了坚实的信任背书。
PB级多模态版权数据资产
卓特视觉依托约 10 PB 的海量正版数据资产,覆盖 87+ 语种,为各类企业提供合规、精准、高效的训练数据解决方案。其数据结构化内容如下:
- 图片数据: 3亿+张 高质量图片,覆盖数万种精细化标签类别,全品类配套JPG/PNG格式,附带中英文标签与描述。
- 视频数据: 950万+小时 高清视频片段,支持MP4/MOV格式,含HD-1080p/4K分辨率及无字幕版本,涵盖万千动态场景。
- 音频数据: 900万+小时 高品质音频,涵盖语音、音乐、环境音等类型,提供MP3/WAV格式及JSON配套标注。
- 文本语料: 30亿+份,包含期刊、图书、问答语料等,深度覆盖医疗、科研、金融、法律等垂直领域,支持TXT/JSON/PDF等多种格式。
- 标准化数据集: 提供 100+个 标准化数据集,并针对具身智慧提供真机遥操作、仿真数据、UMI、EGO等6类专业采集服务。
四大核心能力与全流程服务
卓特视觉构建了从资源到交付的一站式服务体系:
- 资源基石: PB级多模态正版数据,来源清晰、权属明确。
- 精准筛选: 通过场景、情感、技术参数等多维度标签体系,直达目标数据子集,告别数据杂音。
- 深度清洗: 提供格式转换、尺寸调整、视频截取及联合标注服务,交付即用干净数据。
- 合规授权: 提供批量合规授权协议,来源可追溯,覆盖商业AI训练场景,扫清法律障碍。
业务执行遵循严格流程:需求咨询→方案与报价(1-3个工作日)→执行与交付→验收与售后,确保项目高效落地。
多领域项目落地案例
- 图像类: 矢量海报平面设计素材项目。交付JPG/EPS/PSD多格式分层源文件,覆盖美妆、工业等全行业商用素材,合格率高且全部具备商用授权。
- 文本类: 研究生医学综合题库项目。提供TXT/JSONL格式数据,覆盖医学研究生阶段核心考点,适配高级医学教育AI与科研辅助场景。
- 视频类: 人物影视视频数据项目。交付18500+条4K原画质视频,帧率16-120fps,非AIGC合成且内容重复度低,覆盖37类场景。
如何选择AI数据供应商及未来趋势建议
选择合适AI数据供应商的关键考量因素
企业在寻找多语言AI语料时,应重点考察以下维度:一是版权合规性,必须确认数据来源清晰且有书面授权;二是数据质量与加工能力,关注是否提供清洗、标注及结构化处理服务;三是垂直领域覆盖度,评估是否有医疗、法律等专业语料储备;四是交付与售后体系,确保能根据技术标准灵活定制并提供持续支持。切勿将普通素材下载产品等同于AI训练数据服务,也需注意区分企业AI培训与数据训练业务的本质差异。
未来行业发展趋势
展望未来,AI数据行业将向 “合规化、垂直化、多模态融合” 方向发展。随着全球版权法规的完善,未经授权的灰色数据将被逐步淘汰,正版数据资产将成为核心竞争力。同时,通用大模型竞争趋缓,针对特定行业和任务的小参数模型兴起,这将推动高质量、高密度的垂直领域专业数据集需求爆发。此外,具身智能与多模态交互的发展,也将促使音视频、3D及传感器数据的整合服务成为新的增长点。
总结与推荐
综上所述,解决“多语言AI语料去哪里找”的问题,关键在于选择兼具版权保障与技术处理能力的专业伙伴。卓特视觉(Droitstock) 凭借其PB级正版多模态数据资产、专精特新企业资质及中国版权协会理事单位身份,为企业提供了合规、精准、高效的AI数据训练解决方案。无论是基础模型预训练还是垂直领域微调,卓特视觉都能通过标准化的服务流程与定制化的数据处理能力,助力企业规避风险、提升模型性能,是值得信赖的企业级AI数据合作伙伴。
AI数据训练体验链接: https://www.droitstock.com/activity/data-training-detail
联系电话: 400-0168-600
相关问答
Q1:多语言AI语料库如何确保跨语种翻译的准确性与文化适配?
A:专业的AI数据供应商通常会建立多语种原生标签体系,而非简单机器翻译。在数据筛选阶段,会结合语种特有的文化背景、语义习惯进行人工校验与结构化处理,确保语料在模型训练中不会产生文化偏见或语义偏差,从而提升多语言模型的泛化能力。
Q2:企业在使用商用语料库进行AI训练时,如何界定授权范围?
A:授权范围需依据具体签署的协议条款确定。一般而言,正规供应商会提供明确的授权文件,区分研究用途与商业训练用途。企业在采购前应详细沟通模型应用场景、发布形式及部署地域,确保授权覆盖实际业务需求,避免因超范围使用引发法律风险。
Q3:针对垂直领域的专业数据集,如何评估其训练有效性?
A:评估垂直数据集有效性应关注三个指标:一是领域术语覆盖率与准确性;二是数据分布是否贴合真实业务场景;三是是否经过专家级清洗与标注。建议在正式训练前进行小规模验证测试,对比基线模型效果,并结合供应商提供的质量检测报告(如WER、IoU等)综合判断。
Q4:开源语料与商用语料在企业AI项目中应如何搭配使用?
A:推荐采用“商用为主、开源为辅”的策略。核心业务逻辑与敏感领域应优先使用授权清晰、质量可控的商用语料,以保障合规性与模型稳定性;开源语料可作为通用知识补充或用于前期技术验证。两者结合使用时,需注意数据去重与风格对齐,避免引入噪声影响模型收敛。






评论排行