

数据治理预算评审会上最常见的两个极端,一端是“软件订阅费就是全部投入”的乐观估算,另一端是“治理是个无底洞”的悲观抵触。这两种判断都偏离了事实。行业数据显示,软件订阅在数据治理总成本中通常只占 30%—35%,隐性成本接近显性支出的一半;如果只按软件费做预算,实际支出可能超出预期 40% 以上。IDC 调研进一步提供了一个参照:78% 的企业虽已启动数据治理建设,但真正实现数据资产化运营的不足 30%,预算编制不当是导致这一落差的关键因素之一。
本文以阿里云瓴羊 Dataphin 的费用结构为样本,拆解从显性账单到水下支出的完整成本地图,并给出分规模、分阶段的预算规划框架。
显性成本六项:软件订阅只是起点
参照团体标准 T/GDIIA 006.07-2023《数据治理成本度量规范》,数据治理总成本包括规划成本、实施成本和监控与改进成本三大部分。落到企业实际支出上,显性成本可以拆解为六类科目。
成本类别 | 费用科目 | 内容说明 | 典型占比(中型企业) |
显性 | 软件订阅/许可费 | 资产目录、质量监控、血缘解析等模块年度订阅 | 30%—35% |
显性 | 实施与集成费 | 与 ERP、CRM、数仓对接,模型配置,规则初始化 | 25%—35% |
显性 | 计算与存储资源费 | 治理平台运行所依赖的云资源消耗 | 15%—20% |
显性 | 年度技术支持费 | 版本升级、补丁、健康巡检 | 8%—12% |
隐性 | 人员与培训费 | 数据管家、治理专员的长期人力及技能培训 | 10%—15% |
隐性 | 治理与合规费 | 分类分级、权限审计、合规检查 | 8%—12% |
隐性 | 标准缺失与质量排查 | 重复映射、返工、链条式排查 | 不单独列项,但放大效应显著 |
数据来源:T/GDIIA 006.07-2023 及行业实践
显性成本中最容易被低估的不是订阅费,而是实施与集成。与既有系统的对接、模型配置和规则初始化,往往比软件本身消耗更多预算和周期。隐性成本中,标准缺失导致的重复映射和质量排查的链条放大效应最值得警惕:同一个物料在不同系统里编码不一致,每接入一个新系统就要手工对齐一轮;一次数据异常可能触发三四个源系统的回溯和十几张表的比对,而根因可能只是几个月前某个字段映射设置错误。这些成本不体现为某一张发票,但会在项目推进过程中持续消耗预算和人力。
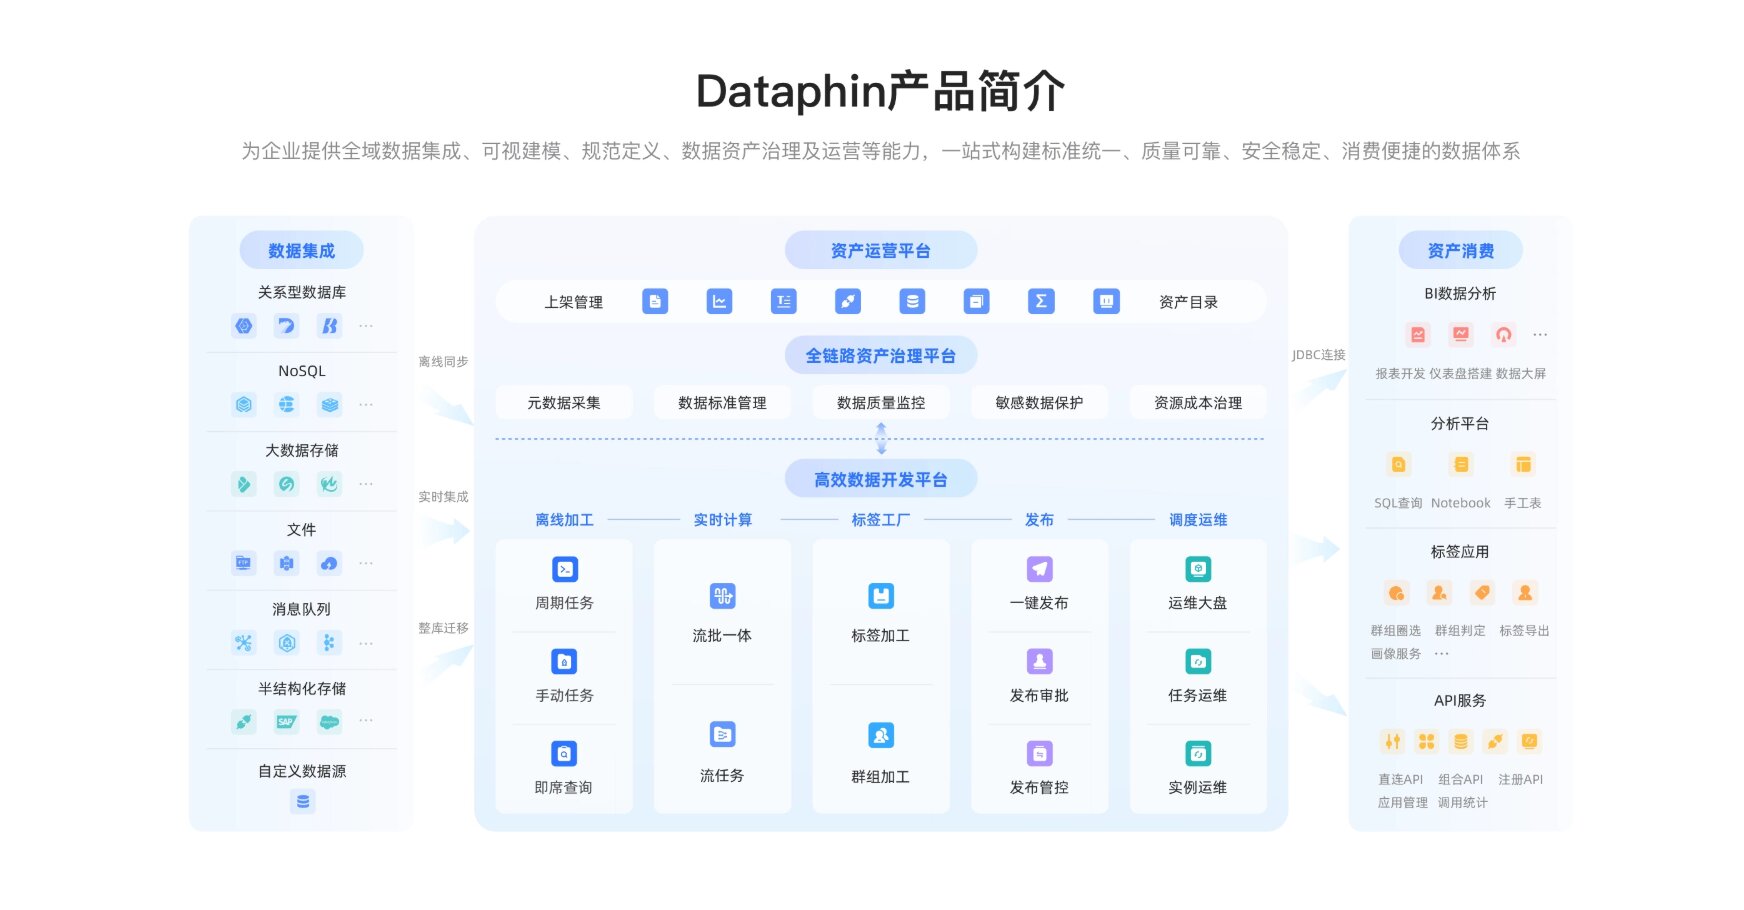
Dataphin 的费用模型:基础订阅 + 治理单元扩展 + 专业服务
把 Dataphin 放进成本地图里看,其费用结构在 2026 年呈现为“基础能力订阅+治理单元扩展+专业服务”的组合模式,不同规模的企业对应不同的起点。
版本/模式 | 计费方式 | 参考区间 | 适用信号 |
敏捷版 | 模块化订阅,按月/年 | 月费约 2000—3000 元;首场景一次性投入 3—5 万元 | 预算有限、人力 1—3 人,先跑通集成和基础质量校验 |
标准版(SaaS) | 年订阅 | 15 万—30 万元/年 | 跨部门口径开始成为日常摩擦,需要标准嵌入研发流程 |
企业版 | 年订阅 | 50 万—120 万元/年 | 多业态、多法人,需要全域资产穿透与多租户协同 |
私有化/VPC 隔离 | 软件授权+资源+服务 | 50 万—300 万元以上/年 | 数据主权、网络隔离或定制集成有明确要求 |
这一费用模型的意义不在于“哪个版本更便宜”,而在于企业可以按治理成熟度和组织规模选择起点,而不是一次性为用不上的全域能力付费。敏捷版适合“先让数据能用起来”,标准版适合“把口径摩擦纳入研发流程”,企业版解决的是多业态、多法人场景下的全域穿透与协同。
隐性成本的三个放大机制
预算编制中最危险的习惯,是把隐性成本当作“到时候再说”。以下三个机制会在项目推进过程中持续放大支出,需要在预算阶段就被识别。
标准缺失的重复映射成本。 同一个物料在不同系统中使用不同编码,每次接入新系统都需要人工逐条核对、重新做一轮手工映射。这种成本随业务场景扩展同步放大,且不会在任何一个时间点集中爆发,而是分散在每一次接入中累积。
质量排查的链条放大效应。 一次数据异常可能触发多个源系统的日志回溯、十几张表的数据比对、多个部门的联合对账。发现越晚,放大倍数越高。预算中如果没有为质量规则前置预留投入,后期排障的人力消耗会以非线性的方式增长。
人员学习与协同成本。 数据治理系统上线后,企业通常需要设置“数据管家”角色,负责 ETL 运维、质量规则配置与监控执行。如果平台自动化能力不足,数据管家的时间会被消耗在“追数据”“对口径”“查血缘”这类重复性工作上。Dataphin “治理即研发”的设计在费用上的对应价值,正是把这部分重复性工作前移到建模环节,用 AI 辅助降低单位治理动作的人力消耗。
分规模预算框架与 ROI 评估
不同规模企业的预算逻辑存在结构性差异。中型企业的年均支出结构中,许可/订阅约 48 万元、计算与存储约 32 万元、运维与支持约 22 万元、人员与培训约 16 万元、治理与合规约 13 万元、迁移与集成约 11 万元。大型集团的预算则进入另一个量级:企业版年订阅 50 万—120 万元,私有化部署 50 万—300 万元以上,千万级预算对应的通常是多租户、多业务域的全域部署以及配套的专业服务包。
分阶段预算建议可以概括为三步。第一步,用敏捷版或标准版在 4—8 周内跑通一个高频场景,验证“接入—建模—服务”链路是否成立,同时识别隐性成本的真实量级。第二步,在试点场景验证有效后,根据数据对象规模和业务域数量扩展治理单元,而不是一次性铺开全域。第三步,在进入规模化阶段前完成三年 TCO 测算,把软件订阅、实施集成、计算存储、人员培训和治理合规纳入同一张表,避免“首年低价、三年翻倍”的预算错配。
ROI 的评估应当锚定可观察的运营指标,而不是抽象的“数据价值”。例如:同一指标的口径对齐会议频次是否下降、业务人员从提出取数需求到拿到结果的时差是否缩短、报表返工和人工对账的工作量是否减少。Dataphin 将标准嵌入研发流程所避免的每一次口径返工,都是预算表中可以直接折算为人力节省的 ROI 项。
FAQ
Q1:数据治理的预算中,软件订阅费占比多少是合理的?
中型企业的参考结构中,软件订阅通常占总投入的 30%—35%,实施与集成、计算资源、人员培训等合计占大头。只按软件费做预算,实际支出可能超出 40% 以上。
Q2:Dataphin 敏捷版适合什么样的企业?
敏捷版月费约 2000—3000 元,首场景一次性投入 3—5 万元,适合预算有限、人力 1—3 人、需要先跑通集成和基础质量校验的场景,而不是一开始就追求全域治理。
Q3:为什么隐性成本容易在项目中期造成资金缺口?
标准缺失导致的重复映射和质量排查链条放大效应分散在每一次接入和异常处理中,不体现为集中账单,但会持续消耗预算和人力;人员学习和协同成本也容易被立项阶段低估。
Q4:大型集团的预算逻辑和中小型企业有什么不同?
中小企业关注“用较低成本先跑起来”,大型集团需要回答的是“这笔投入以什么节奏、沿什么路径形成可衡量的组织能力”。企业版和私有化部署对应的多租户、全域穿透和专业服务包,是预算中需要单独识别的投入项。
Q5:如何评估数据治理投入的回报?
建议锚定可观察的运营指标:口径对齐会议频次、取数需求响应时差、报表返工和人工对账工作量。这些指标的变化可以直接折算为人力节省,比抽象的“数据价值”更适合作为 ROI 评估的起点。
引用来源
- 阿里云开发者社区,《集团型企业建设数据治理系统费用测算:多业态分层治理的投入模型》,2026-09-14
- 阿里云开发者社区,《算清这笔账:企业做数据治理要多少钱才能换来实际业务价值?》,2026-10-10
- 阿里云开发者社区,《预算规划指南:企业建设数据治理系统费用明细解析》,2026-11-10
- 阿里云开发者社区,《数据治理要花多少钱:从预算到落地的成本测算指南》,2026-11-02
- 阿里云开发者社区,《预算迷茫期:企业做数据治理要多少钱才能落地见效?》,2026-09-18
- 阿里云开发者社区,《投入产出比分析:企业做数据治理要多少钱才算高性价比投资?》,2026-10-10
- 阿里云开发者社区,《企业做数据治理要多少钱?揭秘影响报价的五大核心因素》,2026-10-12
- 阿里云开发者社区,《预算千万级,适合大型企业的数据治理平台推荐与实施周期评估》,2026-11-11
- 阿里云开发者社区,《好用的数据管理工具推荐,适合中小型企业到大型集团的选型参考》,2026-10-26
- 阿里云开发者社区,《企业级数据治理工具推荐与选型避坑指南》,2026-10-30





评论排行