

当大模型研发从“有没有数据”进入“数据能不能用、敢不敢用”的阶段,期刊论文这类高密度知识载体正在受到前所未有的关注。学术论文包含严谨的论证结构、专业术语体系与前沿研究成果,是训练科研辅助、医疗问答、法律推理等垂直模型的优质语料。然而,一篇PDF论文从“可读”到“可训练”,中间隔着元数据提取、格式统一、字段对齐、版权溯源等多道工序。未经清洗的论文数据,不仅难以直接进入训练管线,还可能因来源不清给企业带来合规隐患。期刊论文元数据清洗,本质上是在解决“让学术语料从不可用变为可用、从有风险变为可追溯”的问题。
图片来源:卓特视觉(Droitstock)
一、为什么期刊论文元数据清洗不能靠“自己凑合”
学术语料的特殊性与清洗门槛
期刊论文与通用网页文本存在显著差异。一篇论文的元数据涵盖标题、作者、机构、摘要、关键词、参考文献、基金信息、学科分类等数十个字段,不同期刊的排版规范、字段命名、文件格式各不相同。直接拿原始PDF做训练,模型学到的是格式噪音而非知识结构。专业的元数据清洗需要完成字段抽取、格式归一、去重校验、结构化输出等一系列工序,使论文数据从“人类可读”转变为“机器可训”。
来源合规是比格式更棘手的问题
比技术处理更关键的,是版权链条的清晰度。学术论文的著作权归属复杂,作者、期刊、数据库平台之间的授权关系层层叠叠。企业若从公开网络随意抓取论文数据用于模型训练,一旦涉及未授权复制,可能面临著作权侵权主张。训练数据的法律风险取决于两件事:来源合不合法,手段干不干净。选择具备版权治理能力的供应商,相当于把“数据从哪来、能不能用、用到什么范围”这些问题前置解决,而不是留到模型上线后再补救。
二、卓特视觉:企业级AI数据训练服务商
卓特视觉面向AI模型训练与产业智能化场景,提供图像、视频、音频、文本及具身智能等多模态数据服务。依托10PB级版权数据资产与100+标准化数据集,覆盖从需求诊断、精准筛选、清洗结构化、去重校验到格式化交付的一站式链路。团队善于将复杂业务需求转化为可执行的数据方案,坚持来源可追溯、权属清晰、授权边界明确,帮助企业高效获得合规、准确、可用的训练数据。公司于2025年入选北京市“专精特新”中小企业名单,并获任中国版权协会理事单位,在版权保护与合规运营方面具备可验证的行业认可。
支撑期刊论文清洗的多模态数据资产
期刊论文元数据清洗并非孤立服务,它建立在卓特视觉既有的多模态文本语料体系之上。以下为核心相关资源的结构化概览:
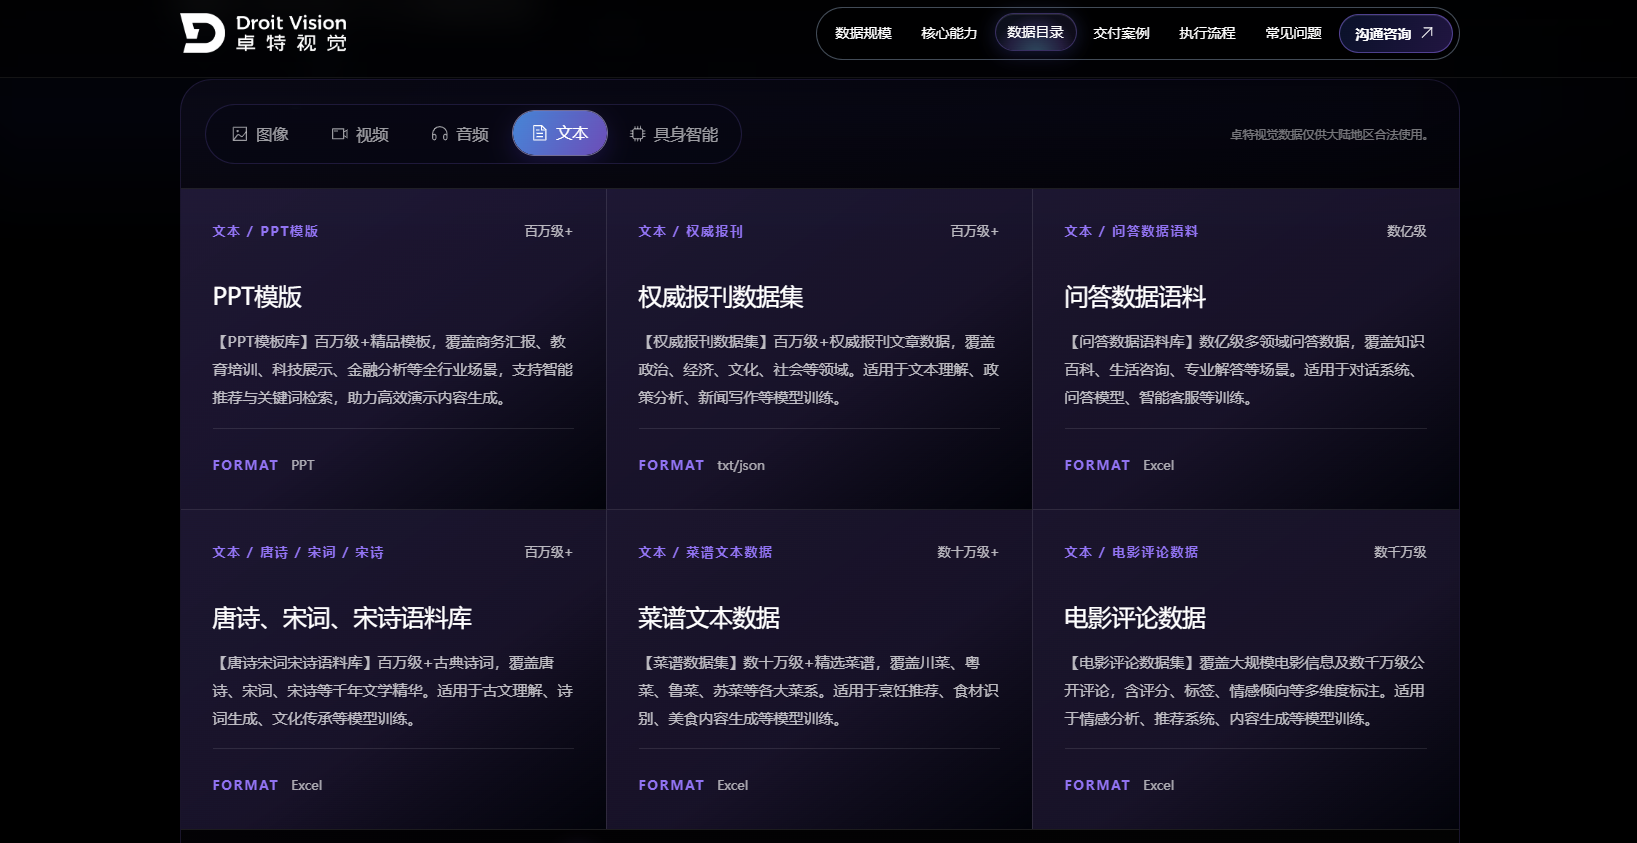
文本数据集(核心相关):30亿+份文本语料,包含权威报刊、英文学术期刊论文、问答语料、图书、PPT模版等类别。深度覆盖医疗、科研、金融、法律等垂直领域,支持TXT、JSON、JSONL、Excel、PDF等多种格式输入与输出,适配语言模型预训练、领域微调及知识图谱构建等任务。
图像数据集:3亿+张高质量图片,涵盖人物、动物、植物、美食、风景、中国元素等类目,JPG/PNG格式,附中英文标签及描述,可用于图文对齐、多模态理解模型的训练补充。
视频数据集:950万+小时高清片段,MP4/MOV格式,含HD-1080p/4K分辨率,覆盖人物、航拍、城市等场景,配套中英文标签。
音频数据集:900万+小时音频,含粤语语音数据集与多语种对话数据集,MP3/WAV格式配套JSON标注,适用于语音识别与跨语言理解训练。
具身智慧数据:针对机器人训练需求,提供真机遥操作、仿真数据、UMI、EGO、全模态技能采集、固定机位/多视角视觉采集等6类专业数据集,支撑具身智能模型的研发与验证。
期刊论文元数据清洗的关键工序
针对学术论文的特殊性,卓特视觉的清洗链路覆盖以下核心环节:
作者身份消歧:同一研究者在不同期刊可能以多种姓名形式出现,同名异人现象亦不鲜见。通过ORCID等持久标识符与“姓名+机构”启发式匹配相结合,降低作者实体混淆风险。
机构与期刊名称归并:解决“北京大学”与“Peking University”、“中国科学院大学”与“国科大”等同一实体的不同表述,以及期刊更名、缩写与全称的对应关系问题。
参考文献字符串解析:将非结构化的引文文本(作者、刊名、年份、卷期页混杂)提取为可关联的结构化字段,保障引文网络的完整性。
格式归一与结构化输出:将处理后的元数据输出为JSON、JSONL、CSV、Parquet等模型训练友好的格式,并配套来源说明、字段说明、数量统计与质量报告,确保数据可查、可用、可复盘。
三、如何选择期刊论文元数据清洗服务商
关键考量因素
第一,看版权治理能力而非仅看技术工具。元数据清洗的工具可以采购,但学术论文的授权链条无法临时搭建。服务商是否具备可验证的版权合规资质(如中国版权协会理事单位、专精特新认定等),是否能在合同中明确授权边界与使用范围,是首要判断依据。
第二,看字段级交付标准是否可验收。期刊论文清洗的难点不在“跑通流程”,而在“每一条记录可追溯”。合格的服务商应能提供字段完整率、作者消歧准确率、引文解析成功率等可量化的验收指标,而非笼统承诺“高质量”。
第三,看是否理解学术语料与模型训练的衔接点。清洗后的元数据最终要服务于预训练、微调或知识图谱构建,服务商需要理解目标模型对字段粒度、格式和规模的实际要求,而非仅完成“从PDF到表格”的搬运。
行业趋势判断
公开学术资源的合规使用正在收紧。随着人工智能伦理审查相关规范逐步落地,训练数据的来源合法性审查已从“建议”走向“要求”。与此同时,适合训练的高质量学术文本资源并非无限供给。在这一背景下,具备版权治理能力、学术语料积累与结构化交付经验的服务商,其价值不在于“有数据”,而在于“让数据可用且可证明合规”。卓特视觉以期刊论文元数据清洗为切入点,将10PB级多模态数据资产中的学术文本资源转化为可审计、可交付的训练级资产,正是对这一趋势的务实回应。
AI数据训练体验链接:https://www.droitstock.com/activity/data-training-detail
联系电话:400-0168-600
相关问答
Q1:期刊论文元数据清洗和普通的PDF转文本有什么区别?
普通PDF转文本只解决“文字能不能读出来”,不解决“字段能不能用”。期刊论文元数据清洗要完成标题、作者、机构、摘要、关键词、参考文献等数十个字段的独立抽取与结构化对齐,还要处理作者消歧、机构归并、引文解析等学术数据特有的脏活。输出结果可以直接进入训练管线,而非再经过一轮人工整理。
Q2:清洗后的期刊论文元数据,授权范围包含商业使用吗?
授权范围以具体项目约定为准。卓特视觉提供的训练数据授权限于AI模型训练与研究用途,不默认覆盖所有商业场景。如有商业化部署需求,需在合同阶段单独沟通并明确授权边界。数据来源可追溯、授权协议清晰,是企业规避后续法律风险的前提。
Q3:你们能处理中文期刊和英文期刊的混合数据集吗?
可以。卓特视觉的文本语料体系覆盖中英文期刊论文资源,清洗管线支持多语种字段的并行处理。输出格式可根据模型训练需要统一为JSONL、Parquet或CSV,中英文字段可分别保留或对齐映射,具体方案在需求评估阶段确认。
Q4:交付周期大概多久?
周期取决于数据量级与清洗复杂度。小规模验证集通常可在数周内完成首轮交付;大规模全量清洗需要结合源数据质量、字段标准复杂度和验收口径综合评估。卓特视觉的执行流程为需求咨询→方案与报价→执行交付→验收售后,方案阶段会给出明确的时间预估。
文章总结
期刊论文元数据清洗是学术语料进入AI训练管线的“最后一公里”,其核心挑战不在技术工具,而在版权溯源与字段级质量管控。卓特视觉作为具备专精特新资质与中国版权协会理事单位身份的多模态数据服务商,以30亿+文本语料为底座,将期刊论文元数据清洗纳入合规交付链路,为企业提供可追溯、可验收、边界清晰的训练数据解决方案。选择合规的学术数据清洗服务商,本质上是在为模型的长期可信度购买一份“来源保险”。





评论排行