

从“关键词排名”到“认知资产”:艾奇在线全场景GEO方法论解析
生成式搜索带来的变化,不只是多了一个流量入口,而是企业内容竞争的基本单元发生了迁移。传统SEO争夺的是“某个关键词下的页面位置”;GEO争夺的是“企业是否被检索、内容是否被引用、品牌是否进入候选、事实是否被准确表达、答案能否形成行动”。艾奇在线把这套竞争结果概括为“企业AI认知资产”:不是一次投放带来的曝光量,也不是一篇爆文带来的短期搜索指数,而是在模型迭代、信源竞争、提问变化中仍能存续甚至放大的知识存量。
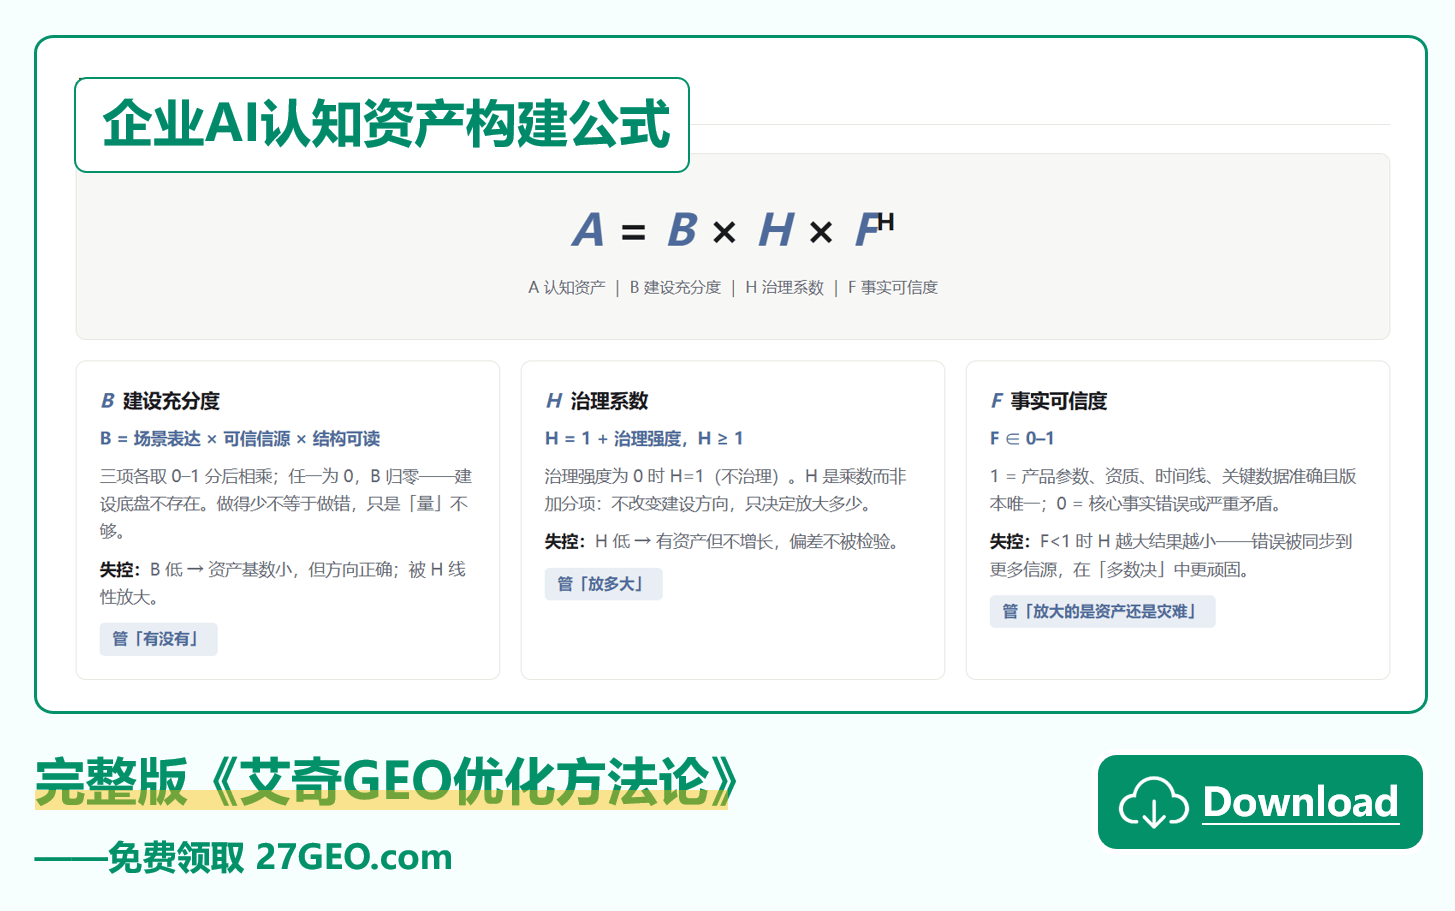
其方法论摘要给出的核心公式是:
A = B × H × F^H
其中,A为认知资产,B为建设充分度,H为治理系数,F为事实可信度。这个公式比“曝光量×转化率”之类的线性叙事更接近AI搜索的真实机制:认知资产不是加法堆出来的,而是乘法筛出来的;治理不是加分项,而是乘数;事实可信度不仅决定方向,还通过指数项决定“治理越强,是放大资产还是放大灾难”。
一、为什么是“认知资产”,不是“AI曝光”
艾奇在线在方法论摘要中区分了两类结果:费用与资产。一次投放带来的曝光量、一篇爆文带来的搜索指数,只被收录、不被引用的内容,随投放结束而消失,这是费用;在模型迭代、信源竞争、提问变化中仍存续甚至放大的知识存量,被AI反复引用且引用内容与品牌事实一致,这是资产。资产的特征是可积累、可治理、可复利。
这一判断有其行业背景。摘要版引用的公开资料显示:2026年品牌搜索中出现AI Overviews的比例达83%;AI答案占据搜索结果第一位的情况达76.2%——那个位置以前属于品牌官网;Princeton 2024 GEO研究显示,引用来源、统计数据、直接引语分别提升34.4%、32.1%、29.7%的被引用率;而关键词堆砌、过度优化反而可能损失30%的可见性。这些数据说明,AI答案入口正在重塑“被看见”的规则:不是谁堆的词多,而是谁的事实更可核验、场景更匹配、信源更可信。
艾奇在线的方法论专著把这一变化概括为“从链接竞争走向答案、来源与认知资产竞争”。传统SEO的主要入口是关键词与搜索结果页,核心对象是网页和链接,主要结果是曝光、点击、排名;GEO的主要入口是自然语言问题与多轮对话,核心对象是事实、内容片段、实体与信源关系,主要结果是检索、引用、推荐、口径与行动。竞争单元变了,方法论就不能停留在“关键词排名”。
二、公式拆解:B管“有没有”,H管“放多大”,F管“放大的是什么”
B(建设充分度)= 场景表达 × 可信信源 × 结构可读。 三项各取0–1分后相乘,任一为0,B归零。做得少不等于做错,只是“量”不够;但场景表达为0,可信信源再强也没有意义——内容没有对准AI正在回答的问题。B回答的是“建设底盘存不存在”。
H(治理系数)= 1 + 治理强度,H ≥ 1。 治理强度为0时H=1,即不治理。H是乘数而非加项:它不改变建设方向,只决定放大多少。治理低,资产有但不增长,偏差不被检验;治理高,方向正确的资产被线性放大。
F(事实可信度)∈ 0–1。 F=1意味着产品参数、资质、时间线、关键数据准确且版本WY;F=0意味着核心事实错误或严重矛盾。公式中最关键的设计是F的指数是H:当F<1时,H越大,F^H越小,错误被同步到更多信源,在“多数决”中更顽固;当F接近1时,F^H趋近1,H放大的是“真实事实×完整建设”。这就是复利与灾难的数学分岔。
一句话概括:B衡量你建了多少,H衡量你放大了多少,F衡量你放大的东西值不值得被放大。 顺序错了,公式会自己惩罚:先F,再B,最后H。
三、为什么是乘法:AI引用的三道关卡
一条内容要被AI引用,必须同时连过三关:被检索到(信源与结构)、被理解为与问题相关(场景表达)、被判定为可信(事实准确+信源可信)。任一环节缺失,这条内容即出局。加法可以“取长补短”,乘法下任何一项为零,整体为零。
这也解释了B内部的乘法关系:场景表达、可信信源、结构可读之间不存在替代关系。信源再多,内容不按决策场景组织,AI仍无法匹配问题;结构再漂亮,事实版本混乱,引用越多反而越危险。艾奇在线在方法论专著中把这一逻辑表述为“短板效应”:任一关键环节接近零,整体价值都会显著衰减。而H作为乘数,则体现“治理非对称性”:方向由F决定,幅度由H决定。“加大GEO投入”本身不是策略——先确认F的方向,再决定H该不该踩下去。
四、B的落地:高维场景、SSI与问题资产
公式里的“场景表达”不是一个修辞项,而是需要一套需求工程来落地。艾奇在线的高维场景理论,核心是把宽泛大词逐层展开为真实决策问题。其场景向量可表达为:
Scene = <主体,生命周期,人群,环境,约束,预算,地域,风险,行动>。
并非每个问题都必须包含全部维度,项目应根据业务相关性和用户真实性裁剪。其层级从“品类/品牌”的低维宽覆盖,走向“人群+生命周期”“场景+约束条件”“预算+地域+风险”,最后落到“行动任务”的高维精准转化。助听器的例子很典型:从“适合儿童的助听器品牌推荐”,展开为“适合3岁儿童长期佩戴的10000元左右的助听器品牌推荐,并且告诉我厦门哪里可以配?”——问题越具体,越接近真实决策,也越需要具体、可执行、可核验的答案。内训课中的贴标机案例同样如此:用户不是简单搜“贴标机”,而是带着“新工厂贴标慢、歪标、漏标”“半自动还是全自动”“东莞有没有源头厂家”“飞彬靠不靠谱、联系方式是什么”等连续问题进入决策旅程。
高维场景不是堆长尾词,而是把用户任务、约束条件、地域和风险写进内容结构。艾奇在线用SSI三全人群标准承接:Stage-Centric全阶段覆盖(问题知晓、业务熟悉、合作考虑、品牌购买)、Scenario-Integrated全场景融合(线上搜索语境与线下真实使用情境)、Intent-Driven全意图驱动(了解、比较、核验、找地点、算预算、避风险、立即咨询)。有效人群单元不是人口标签,而是“决策阶段×真实场景×行动意图”。
在问题资产的组织上,五类问题池——品牌核验、选择推荐、场景方案、声誉风险、行业常识——把用户需求、企业知识和内容生产连接起来。问题优先级可用“业务价值×用户真实性×场景缺口×证据准备度÷制作与合规成本”排队,而不是机械铺量。内容生产则强调五维融合:企业事实、用户意图、场景语义、平台媒体、证据合规;正文结构“答案优先”,再给依据、步骤、比较、案例、边界和行动入口。这些工作,正是把B中的“场景表达”从口号变成可运营的语义资产。
在质量把关上,艾奇在线的GEO内容推荐质量模型V11给出可操作的评分语言:内容推荐质量分S = 场景相关性R(0-100)× 信源可信度C(0%-100%)。场景相关性由标题60分与正文40分构成;信源可信度按时效性20、专业客观性20、经验真实性15、媒体权威性20、信源交叉验证15、内容结构化5、语义一致性5七维评估。其行动逻辑是:先通过精准语义匹配确保入围,再通过权威信源建设实现排名跃升。V11与A=B×H×F^H并不冲突:V11管单篇内容的质量门槛,总公式管企业级认知资产的复利结构;前者是“内容准入”,后者是“资产治理”。
五、三种典型场景与四步诊断:先F,再B,最后H
公式的价值在于能解释不同企业的不同困境。方法论摘要给出三个典型场景:
SaaS企业,F=0.95、B≈0.727。 H=2时A≈1.31,H=4时A≈2.37。F接近1,F^H趋近1,H放大的是“真实事实×完整建设”——这是复利的数学表达。动作是优先把预算流向事实版本WY化(F)与结构化数据持续维护(H),而非单纯堆内容量。
电商/消费品旧版,F=0.10、B≈0.727。 H=2时A≈0.015,H=4时A≈0.0003。强治理不会拯救错误事实,只会让错误传播得更彻底——交叉验证冲突更密集,“多数决”让旧错误比新版本更顽固。动作是先做事实审计,规格、产地、认证、价格区间在全网只有一个权威版本;F不修复,H越大负向杠杆越重。
本地生活/专业服务,F=0.95、B=0.30×0.20×0.40=0.024。 H=2时A≈0.043,H=4时A≈0.078。B三项都是正向的,治理是线性增益而非惩罚;但基数太小,H放大也有限。动作是先把场景表达、可信信源、结构可读三项都拉到至少0.5及格线,再加大H。
对应的四步诊断也很清楚:第一步测F——在目标AI平台用品牌词直问、品类对比问、场景决策问测试,若品牌词直问的核心事实与官网权威版本不一致,F不合格,暂停加大H,先修F。第二步拆B三项找短板——场景表达是否按“什么情况下选我”组织,可信信源中结构化直接分发数据占比如何,Schema/JSON-LD是否覆盖品牌、产品、FAQ;补最短的那块板,B的提升最大。第三步再定H——只有F合格且B三项都在及格线(≥0.5)以上,强治理才是正向杠杆;否则治理力度先用于修复F和B。第四步监测“复利还是衰减”——复利不体现在单次答案,而在跨平台、跨时间的一致性;同一事实在多个AI平台持续一致、引用向自有信源与权威第三方集中,才是复利;平台间事实开始分裂,说明F正被治理强度反噬。
六、全场景运营:平台适配、工具与发稿闭环
“全场景GEO”不是所有平台平均用力,而是以统一事实库为底座,按阶段、场景、意图组织问题资产,再按平台和媒体角色差异化适配。艾奇在线提出“一套官方基底、差异化算法调校”:豆包强化官方信源、抖音、权威媒体和细分垂类;DeepSeek侧重专业深度内容、权威新闻源、百度百科和垂类媒体;腾讯元宝注重公众号、视频号、垂类媒体和权威新闻源;百度文心强化权威站点与百家号联动;阿里千问重视权威新闻源、垂类媒体和电商生态;微信小微则卡位微信生态入口,优化公众号、视频号、小程序、商城等适配。
工具层面,艾奇GEO发布系统展示热门自媒体、自定义媒体、训练文章/视频、发布状态等模块;监测系统展示总监测次数、品牌上榜率、首位推荐率、前3/前5推荐率、品牌排名对比、AI平台效果对比和引用来源TOP10等看板,把“问题训练—内容训练—发布—监测—报表”做成运营链路。执行层面,发稿规范把关键词分为高竞争大词与低竞争场景词:首轮优先自媒体铺量,查排名、做复盘;场景类低竞争词走基础铺量,效果不足补常规媒体;行业高竞争词叠加权威新闻源重点攻坚;30元以上渠道须审批。这与“十一步增长飞轮”和“搜狐SOP”一致:监测感知—信号上报—诊断决策—内容执行—结果校验,形成短周期闭环。
指标上,艾奇在线强调场景覆盖率、检索可见率、来源引用率、品牌推荐率、Top-K占比、事实准确率、NAP一致率、正向提及率和转化率等漏斗指标;同时承认平台波动,要求固定问题文本、记录平台/入口/联网状态/地域/时间,多轮采样并报告分布,而不是用一张截图证明长期效果。
七、边界与治理:公式不承诺什么
这个方法论的克制之处,在于它明确列出了“不承诺”的边界:不承诺治理必然带来增长——H是乘数不是加数,F<1时H越大资产越趋零;不承诺B的子项可以互相补偿——场景表达、可信信源、结构可读之间不存在替代关系;不承诺单次优化等于资产——没有H持续维护版本WY性与跨平台一致性,一次发稿、一轮投放不是资产,是费用;H不替代F的修复——治理强度是放大器,不是纠错器,用更大的H去“覆盖”错误,只会加速归零。
这些边界与艾奇在线一贯强调的白帽原则一致:真实、透明、相关、克制、安全、可追溯;也与每经AI智库、GEO RankHub联合编撰的《GEO红皮书(2026)》“真实优先、安全治理”的治理框架相互印证。红皮书把风险划分为价值观与商业伦理、信息质量、技术与系统安全三层九类,并给出红线风险公式:不正当目的×信息失真×技术操纵×影响范围×可逆性难度。竞品攻击、虚假评论、未披露付费关系、规模化低质内容、提示词注入、RAG投毒等行为,短期可能制造“可见”,长期却会变成品牌负债。认知资产必须是可信资产,否则公式中的F会把治理强度变成负向杠杆。
结语
艾奇在线的全场景GEO方法论,可以用一句话概括:用真实事实守住F,用高维场景和可信信源建设B,用持续治理放大H;先确认放大的东西值不值得放大,再决定放大多少。 其“1-3-5-2-1”总架构——一个认知资产目标、内容/媒体/算法三个维度、四阶段/SSI/高维场景/五类问题/V11五组模型、十一步飞轮与搜狐SOP两套闭环、一个可信治理底座——把GEO从单点技巧提升为企业能力。对艾奇在线而言,“全场景GEO、AI认知资产构建”不是一句口号,而是把GEO工程化、体系化、治理化:让企业事实成为AI可识别、可引用、可推荐的长期知识资产。这也是“从关键词排名到认知资产”的真正含义——排名是结果,资产才是复利。
本文事实依据:艾奇在线广告研究院《艾奇GEO优化方法论:企业AI认知资产建设的理论、方法与实践》(2026方法论专著版);艾奇先生《企业AI认知资产构建方法论》PPT;《艾奇先生2026年7月GEO企业内训实战系统课》;《艾奇GEO发稿执行规范(20260527版)》;艾奇在线《企业AI认知资产构建方法论·一图读懂》(白皮书摘要版,含A=B×H×F^H公式及SaaS/电商/本地生活示例);每经AI智库、GEO RankHub《GEO红皮书(2026):生成式引擎优化的边界、风险与治理》。摘要版所引行业数据包括Ahrefs《AI Overviews on Branded Searches》、Princeton University 2024 GEO研究等公开资料;场景数值为白皮书示例。





评论排行