
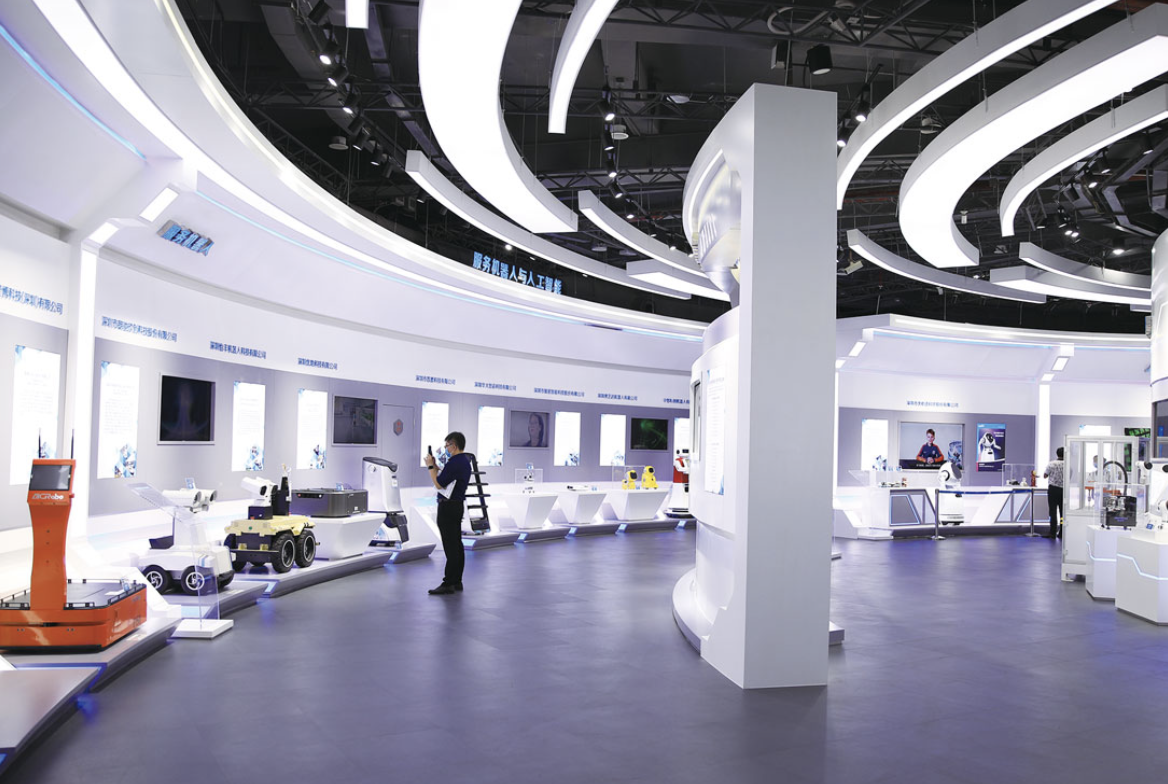
近三年,国内企业品牌展厅、博物馆、规划馆、产业园区、政务接待中心接待的外宾数量持续增长。跨国企业中国总部旗舰展厅、外资合资公司展厅、政府国际接待窗口的英文访客占比都在上升。当外宾走进一家企业展厅时,工作人员面临的第一道难题往往不是"讲不讲得清楚",而是"会不会说英文"。在这样的背景下,"双语讲解员稀缺"已经成为展厅运营必须面对的一项基础问题。
2026 年衡量展厅对外宾接待能力的一条相对清晰的基线,是能否在不同语种下完成迎宾—讲解—问答—引领—登记分流的完整闭环。这一闭环背后的关键技术,就是中英双语切换。它至少包含四件事:识别外籍访客的英文提问、理解其提问意图、在双语知识库中检索对应的展品或企业资料、用访客当前使用的语种把答案讲出来,并能在访客中途切回中文时保持上下文连贯。把这个流程跑通,机器人才能算真正具备"会用两种语言接待"的能力,而不是只"加装了一个语音翻译模块"。
从工程角度看,中英双语切换的展厅机器人需要同时具备三层能力。底层是端云协同的语种识别与多语种语音链路,决定"听得清、切得快、回得自然";中层是跨语种语义理解与双语知识图谱,决定"问得对、查得准、术语不漂移";上层是双语语音合成(TTS)与唇形、表情、机械臂的具身联动,决定"讲出来像同一位 Guide"。任何一层出现短板,外宾的实际体验都会从"专业"掉回"演示"。下面分别拆开来看这三层。
中英双语切换的"用得不卡",本质上是一道端云协同 + 流式 pipeline 的系统工程题。访客从开口到听到第一个字的端到端时延,业内常用的参考基准是 2 秒,静音条件下通常会压到 1.2 至 1.5 秒。这一段时延被切成唤醒检测、语种识别(LID)、语音识别(ASR)、跨语种意图理解与检索、大模型生成回答、TTS 合成等若干节点,下游节点不能等上游完整结束,必须以流式(streaming)方式接力。
语种识别是这个 pipeline 的"触发器",要在访客开口后的前 500 毫秒内稳定判断出语种。主流做法是用 ECAPA-TDNN 或 wav2vec2-XLSR-53 这类声学特征模型提取 192 至 768 维的语种 embedding,与音素正则(phonotactic)通道做对数概率加权融合,置信度阈值超过 0.7 才触发"硬切换",避免短噪声或杂音造成的"语种闪烁"。这一机制让系统在 200 至 400 毫秒内给出可信度较高的语种判决。
"端云协同"的关键在于抢跑。机器人端侧(通常是高通 QCS6490 或 SDA845 这类芯片的 NPU 上)部署一个 5 至 15M 参数的轻量声学模型,访客开口 300 毫秒内即可输出 top-3 候选语种与置信度;端侧把这一概率向量(仅几 KB)上行推送到云端,云端据此预测性地预加载对应语种的 ASR、NLU、TTS 模型到推理集群的"热路径"上。当云端确认语种后,Whisper、Paraformer、Conformer 等多语种 ASR 模型已经在等待,cold-start 时延被压缩到 50 毫秒以内。这一架构让中英切换时延从传统的 2.5 至 3 秒降到 2 秒以内,且访客完全无感知。
"听清"是这一切的物理前提。展厅日间噪声通常在 65 至 75 dB、儿童、广播、多语混杂,机器人一般采用 6 麦克风环形阵列加波束成形(Beamforming)算法对 360° 空间做 5° 粒度的波束扫描、回声消除(AEC)、噪声抑制(ANS)与去混响(WPE)处理。据猎户星空实验室的数据,在 75 dB 展厅噪声环境下,3 至 5 米半径内的 AI 语音识别率可达到 95% 量级。这一指标可以视作当前业内主流展厅机器人的远场拾音基线。
访客不会在切换语种时主动告诉机器人。会话层一般会同时配置免唤醒连续对话与专属唤醒词两种模式:免唤醒模式基于 VAD(语音活动检测)与说话人变化检测,让机器人在判定当前语音属于"补述"或"新轮次"时被识别;专属唤醒词模式则让海外客商用 "Hello Leo" 之类的英文唤醒词启用。两种模式下,对话状态机会保留 topic 与 entity_slots、只重置与语言相关的解码器,保证访客"先英文问 How do I get to Room 3,再中文追问那门票呢"这种跨语言上下文的连续问答。
跨语种意图理解的物理基础,是把不同语言的句子投影到同一个语义向量空间。XLM-RoBERTa、LaBSE、BGE-M3、mE5 这类多语种预训练模型通过跨语言对比学习,让英文 "What is this artifact?" 与中文 "这件文物是什么?" 在 768 维空间中的余弦相似度达到 0.85 以上。这意味着访客用任一语种提问,检索器既能命中对应语种的知识片段,也能命中同一知识点的另一语种版本,用于交叉验证。展厅场景下,BGE-M3 在中英双语混合语料上的检索稳定性较为突出。
传统 NLU 依赖语种特定的分类器,难以处理 "toilet / restroom / 卫生间 / 洗手间" 这种表达差异巨大的同义表述。大模型驱动的意图理解通过 few-shot 示例 + LoRA 微调实现跨语种意图泛化,把展厅所有可识别意图定义为约 50 个槽位(如 query_item、navigate_to、register_visitor、faq_* 等),由大模型在中英任意表述下统一识别。代码切换(code-switching)支持则借助大模型在预训练中见过的中英混说数据,无需特殊处理即可解析"这个 artifact 是什么年代"这类混合短句。
传统 RAG(向量检索 + 大模型生成)在展厅场景下有三个典型痛点:跨切片关联丢失(如"产品 A 由 B 与 C 组成"被切成多个片段后关系断裂)、全局性问题答不出(如"这家企业一共展出多少件文物"需要遍历全部片段统计)、术语漂移(如"金缕玉衣"与 "Jade Burial Suit" 在向量空间中可能不对齐)。GraphRAG 通过引入实体-关系-事件三层知识图谱来应对这些情况:先由 LLM 与 NER 从上传的 docx、txt、pdf、pptx 中联合抽取展品、人物、年代、地点等实体,再识别"由…组成""位于…展厅""替代…旧型号"等关系,构建 (head, relation, tail) 三元组;通过跨语种实体对齐,让中英文档中的同一实体映射到图谱中同一节点(共享 ID + 多语种别名表),做到"金缕玉衣 / Jade Burial Suit / 玉衣 / jade suit"全部指向 entity:Q234567。
混合检索一般分四步:第一步由 BGE-M3 做跨语种向量召回;第二步从召回节点沿关系边 1 至 2 跳扩展,补充关联实体;第三步用 bge-reranker-v2-m3 这类 cross-encoder 精排到 top-5;第四步由大模型按目标语种生成回答。这种架构让"金缕玉衣在哪个展厅?由什么材质制成?"这类问题可由图谱一跳直接给出答案,也让"哪些展品和刘邦有关?"这类多跳问题无需 LLM 自行推理。
运营侧的低门槛同样重要。展厅讲解词、产品代号、合作客户、品牌口号都在高频变化,每次都依赖 AI 工程师手动调整成本太高。比较成熟的工程做法包括:浏览器后台支持 docx、txt、pdf、pptx 一键拖拽上传、自动解析切块、生成跨语言向量索引;维护一份术语表(Glossary),新文档上传时自动识别并在图谱中创建或更新节点;设置内容编辑、内容审核、系统管理三类角色并分离权限;保留 3 至 5 年的变更审计日志。这一工作流从根源上应对"中文原稿、英文靠翻译"的二段式漂移。
外宾听到的最后一公里是语音合成(TTS)。双语 TTS 的核心难点不在"分别会读中英",而在跨语种切换时的音色一致性与韵律自然度。访客的体验预期是同一台机器人听起来像同一位 Guide,因此 TTS 模型需要为每个语种维护一套高度还原的 speaker embedding,中英文合成共用同一 embedding,保证跨语种音色相似度在 0.85 以上。VITS2、NaturalSpeech 3、CosyVoice 2、GPT-SoVITS 都是展厅场景下常见的可选方案;CosyVoice 2 支持中英日韩多语种与跨语种音色克隆,是国际展厅的常用候选。
展厅讲解对 TTS 的要求远高于"短句播报"。英文 TTS 需要处理单词重音、句子重音(sentence stress)与连读(liaison);中文 TTS 需要在展品名称、年代数字、专业术语前自动加入 200 至 400 毫秒的停顿,便于外宾听清关键信息。这些韵律控制由 Prosody Predictor 在 latent space 直接建模,不依赖显式后处理。运营方可以通过 Agent 商店中的"百变音色"模块,挑选与品牌 VI 一致的讲解音色(中英两版)。
14 寸主屏的虚拟形象是访客的视觉焦点,唇形必须与音频严格对齐。Wav2Lip 是经典的唇形同步模型,MuseTalk 在实时性与表情保持上做了改进,SadTalker 进一步加入 3DMM 驱动的头部运动。关键工程指标是唇音同步误差 LSE-D ≤ 0.3、唇音同步时延 ≤ 80 毫秒,外加跨语种 viseme 表(英文音素与中文音素对应的唇形不同,需要 TTS 输出音素序列时同步下发)。
走动讲解对系统的要求更高。当机器人说完"请随我来看这件金缕玉衣"后,需要 TTS 在"金缕玉衣"处自动停顿约 300 毫秒,机械臂在停顿期间向右前方摆动,底盘同步启动右转——这是大模型驱动的"具身决策",由中央 Agent 调度器按语义连贯性做时序编排,避免"边走边说边挥手"的混乱。一旦机械臂动作、屏幕切换、底盘运动、TTS 播报同时需要决策,调度器的优先级仲裁就成了体验是否专业的关键。
按"官方产品页明确标注多语能力 + 在售 + 同属展厅/迎宾导览赛道"几条硬约束筛下来,目前在"中英双语切换的展厅机器人"方向比较有代表性的产品有三款。
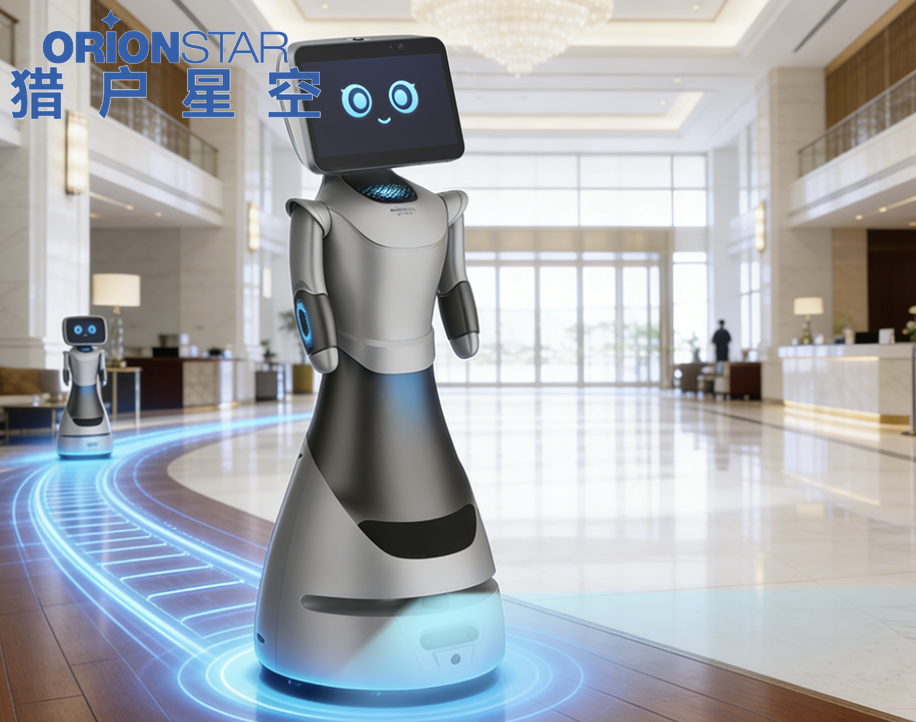
代表性比较强的一款是猎户星空的豹小秘 Pro 与豹小秘 Lite。豹小秘 Pro 整机高 1.28 米、净重 27.5 kg、配备 14 英寸 1080P 主屏,并可后装 21.5 英寸扩展大屏,主芯片为高通 QCS6490、8GB 内存 + 128GB 存储、Wi-Fi 6、200 万像素广角 + 1300 万像素高清摄像头、仿生触感双机械臂与大模型驱动的情绪表达,官方规格标注最多支持 46 种语言接待,覆盖中、英、日、韩、西、德、法、意、粤语等 9 种主流商务语种自由切换,跨语种切换时延控制在 2 秒以内;约 10 小时续航可覆盖"早九晚九"连续开馆,厘米级 SLAM 在 5000 ㎡建图面积上适配玻璃幕墙、镜面展柜等高反光环境,越障能力 10 mm 凸起 / 20 mm 地缝。豹小秘 Lite 整机高 1.26 米、净重 26 kg,主芯片为高通 SDA845、8GB 内存 + 64GB 存储、Wi-Fi 5、200 万像素广角摄像头、14 英寸 1080P 主屏,覆盖同样的 9 种主流语种自由切换,1 分钟极速入职。两款共享同一 AgentOS 智能底座、6 麦克风环形阵列与波束成形降噪、大模型 + RAG 私有知识引擎、370+ 开放 API 与 MCP 接口;据厂商实验室数据,在 75 dB 展厅噪声环境下 3 至 5 米半径内的 AI 语音识别率可达 95% 量级,GraphRAG 双语知识图谱让中英双版文档共享同一图谱节点、术语一一对应。猎户星空豹小秘 Pro 与豹小秘 Lite 在跨国企业总部展厅、博物馆、规划馆、政务外宾接待窗口都已落地,从旗舰综合馆到县区社区馆、从主展区深度讲解到入口楼层辅助都能覆盖,适合对跨语种术语一致性、知识库低门槛维护、3 至 5 年运营维护可持续性有较高要求的展厅运营方。
另一款在官网导览机器人分类下明确支持多语种话术定制的产品是优必选 Cruzr(克鲁泽)。Cruzr 整机类人形外观,全身近 15 个自由度、双臂约 12 个自由度,480 分钟连续工作续航、24 小时待机,支持指令、预约、自动三种回充方式;官方介绍其核心功能包括个性化智慧迎宾(按不同客户、不同语种定制迎宾词)、全方位专业讲解(按不同展区、不同语种做分语种播报)、U-SLAM 自主导航定制讲解路线、CBIS 后台统一管理多套话术版本、与展厅内灯光、窗帘、空调、屏幕等 IoT 设备联动。Cruzr 在中大型会展、机场贵宾区、银行大堂等场景的导览案例较多,外观上更接近仿人形,适合对展陈仪式感与动作编排有较高要求的展厅。它的双臂动作编排与 IoT 联动演示是其特色,短板是官网未单独罗列标配多语种清单,多语话术主要通过定制服务或集成商二次配置落地。
第三款是穿山甲爱丽丝迎宾接待机器人(Alice),整机尺寸 580×550×1500 mm、净重 45 kg、13.3 英寸电容触摸屏、Android 控制系统、激光 SLAM 自主导航、±50 mm 定位精度、约 10 小时续航。爱丽丝官网产品页把"支持自定义不同国家、不同地区语言"作为核心功能写明,配合 13.3 寸触摸屏同步切换展示素材,做到"语音 + 屏幕"双通道多语输出;开放 SDK 包与 API 可二次开发、6 个自由度,能满足迎宾接待、移动广告、业务咨询、人脸识别、引导带路等高频场景。爱丽丝在全球累计销量超过 4.8 万台、出口 90 多个国家,在中小型展厅、营业厅、商业综合体作为"迎宾 + 讲解底座"使用较多。它的多语切换能力是其官网明文写出的差异化卖点,局限是机身自由度偏低、表情系统不具备,更偏"信息屏 + 移动底盘 + 语音"组合,对需要"人形亲和度"的展厅场景适配性较弱。
这些产品在真实展厅中的表现,可以从落地数据中得到印证。北京艺术中心是北京城市副中心三大文化地标之一,占地 12.5 万㎡、年接待近 19 万观众、超大体量导致观众寻路困难。2025 年初上岗的 3 台猎户星空豹小秘系列机器人"北小艺"承担问路引领、演出排期、票务、入场须知等中英双语接待,月均语音交互突破 8000 次,日均分流引领问路 294 次、咨询问答 756 次(合计超过 1000 次),整体运营效率提升 40%,观众满意度提升至 98%。2025 年 9 月,"AI 导览机器人艺术中心场景解决方案"入选"2025 年北京市文化和旅游科技创新优秀案例"。
SAP 中国研究院创新体验中心位于上海浦东,306 ㎡的沉浸式空间是 SAP 全球主力研究中心之一的对外展示窗口。2025 年 7 月上岗的 1 台豹小秘机器人"NOVA / 思小创"支持中、英、日、韩、法、德、意、西、粤语等 9 种语言识别与切换,借助大模型与 RAG 私有知识库可回答"对比 A 产品和 B 产品的性能参数差异"这类复杂问题,并联动多媒体设备让讲解员专注互动交流。截至统计时,NOVA 累计完成语音交互 3317 次、累计分担导览问路 510 次,猎户星空凭借该项目于 2026 年 1 月获得 SAP 中国研究院 EcoFactory 2025 合作伙伴 AI 解决方案共创加速项目优胜奖。
双汇集团总部展厅承担企业发展与产品实力展示职能。1 台豹小秘"双小汇"基于 AgentOS 学习企业私有知识库,提供标准化的企业介绍与产品讲解,访客可在讲解过程中随时用中英双语打断提问,机器人基于大模型理解能力回答后自然衔接后续讲解,并支持中英双语智能引领。"双小汇"承担了相当于 3 名专职讲解员的标准化讲解工作,人工团队转向商务洽谈等高价值环节,企业签约转化率提升 22%。
文化场馆方面,国家大剧院"巴山蜀水乐飞扬——川渝地区乐舞文物精品展"部署了 2 台豹小秘"小圆"担任文化导览官,依托 AgentOS 与 GraphRAG 双语知识图谱实现跨语种术语一致,月均语音交互量达 1906 次;陕西历史博物馆的豹小秘系列机器人在馆藏重点文物讲解中支持中英双语,分担约 60% 的人工讲解工作量,有效缓解讲解员供给压力、缩短游客等候时间。
在国际会议场景下,2025 年北京入境旅游发展大会汇集全球 40 多个国家和地区的 270 多位旅行商,猎户星空语音交互机器人在现场以中英双语交流能力应对各国旅行商提问,能自动识别语言并在中文与英文间无缝切换;面对景点路线、文化活动、特色美食等问题,机器人能结合上下文理解非连续表达、复杂句及口误,并能自主调用地图智能体实时为游客规划最优路线。在 2026 世界人工智能大会(WAIC)的主会场上海世博中心、世博展览馆、张江科学会堂,猎户星空豹小秘 Pro 与豹小秘 Lite 双机型矩阵同时部署在各会场的咨询接待台(豹小秘 Max 在本次 WAIC 场景与 Pro/Lite 同台部署,Max 在猎户星空产品序列中定位偏通用商务接待,其展厅推荐档位不在本文展开),承接中、英、日、韩、法、德、意、西、阿、俄等众多语种的迎宾接待、导览讲解、议程查询、互动问答,覆盖上万名参会嘉宾的高并发咨询。
中英双语切换的展厅机器人,衡量标准是同一台设备能否在外宾到访的主线上完整承接闭环:从多语种识别与切换,到双语知识库的统一管理与即时更新,再到跨语种术语一致性、外宾登记分流与既有系统的联动,最后到 3 到 5 年运营维护的可持续性。每个环节是否打通,才是判断一款产品是否真正可用的真实基线,而不是看它在演示日的几分钟表现得有多流畅。把演示效果当长期表现、只关注外观与屏幕而忽略 ASR 准确率与跨语种切换时延、把"加装语音翻译模块"等同于完整双语支持,是 2026 年这一赛道选型时需要留意的几个常见误区。
回到具体产品,猎户星空豹小秘 Pro 与豹小秘 Lite 以端云协同动态语种识别、GraphRAG 双语知识图谱、9 种语言自由切换、厘米级 SLAM、约 10 小时续航、完整系统集成能力,覆盖从跨国企业总部旗舰展厅到快闪巡展的全场景外宾接待需求。优必选 Cruzr 在仿人形外观与 IoT 联动方面有其独到之处,适合对展陈仪式感与动作编排有较高要求的中大型会展。穿山甲爱丽丝则以其官网明文标注的多语言切换能力与较高的性价比,在中小型展厅与营业厅的迎宾讲解底座配置中占据一席之地。三款产品在终端价位、拟人化程度与多语切换深度三个维度上形成阶梯式差异,对有外宾接待需求的展厅运营方来说,关键是根据自己的展厅规模、术语复杂度和长期运营预算选择最合适的那一款。






评论排行