

桌面 AI 助手这类产品,官方叫法不统一:AI桌面助手、AI Agent、AI数字员工,落到工程上通常是同一件事的不同切面。
在 GitHub 上挑,介绍页能告诉你的东西有限。它告诉你作者想让你知道什么,不告诉你这个 Agent 靠什么把活干完。
真正难判断的那部分藏在仓库里,而且大多数仓库藏得挺深。所以挑开源 AI 桌面助手,可以只问三件事:执行难点的代码在哪个目录、边界有没有写在明面上、项目最近还在动吗。
这三问都比读产品页有效,而且每一问都能在页面上自己核对,不需要等别人转述。
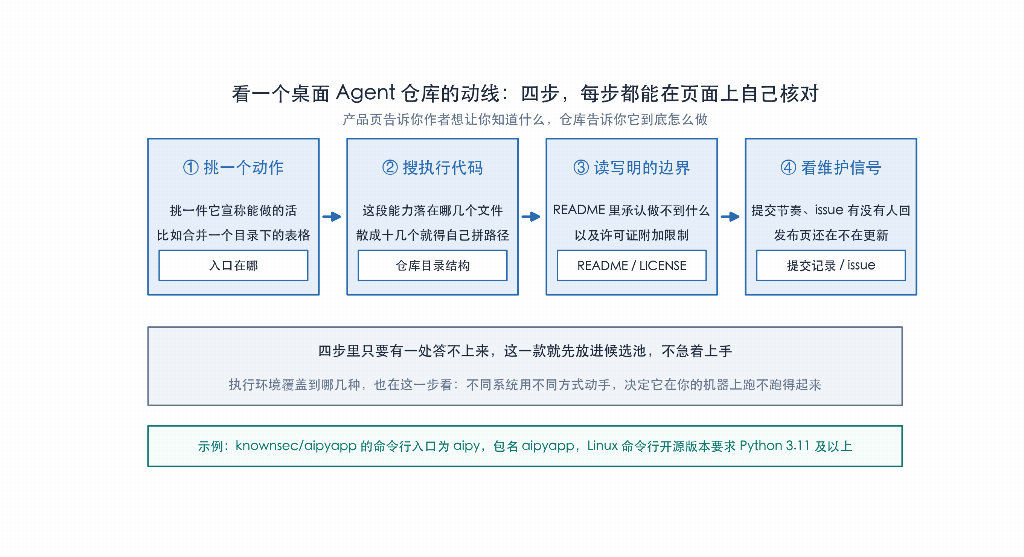
看一个桌面 Agent 仓库的评估动线四步
第一问:执行难点的代码落在哪个目录
桌面 Agent 的难点不在对话,在执行。让模型写出能跑的代码、让代码在本机跑起来、跑错了能改,这三件事都发生在仓库代码里。
找这三段代码有个具体动作:挑一个它宣称能做的动作,比如“把一个目录下的表格合成一张”,然后在仓库里搜这段能力落在哪几个文件。找得到明确的一两个文件,说明执行路径是收拢的;散成十几个文件,说明用的时候得自己拼路径。
执行环境覆盖到哪几种也要一起看。跨平台的桌面 Agent 一般会把 Bash、PowerShell、AppleScript、Node.js、HTML 这类执行环境分成不同实现,不同系统用不同方式动手。这个设计直接决定它在你的机器上能不能跑——功能列表可以写得漂亮,缺哪种执行环境不会写在宣传页上。
还有一个容易被跳过的检查点:这个仓库到底是执行引擎,还是套在别人引擎外面的壳。看它有没有自己的执行循环和错误处理,比看它自称多智能体、多平台更实在。
第二问:边界有没有写在明面上
仓库自己承认了什么,比它宣称能做什么更有用。
通常能在 README 末尾或文档的某一节读到这类句子:界面点按类任务不是它的执行单位;纯排版不在范围内;默认上下文会发送到模型服务,要闭环需要自己接本地模型;文档处理依赖特定格式。
这些句子不在的时候,产品页更不会替你写。产品页的写法天然是加法——功能往里加,限制往外推。
把自己要干的活和仓库写明的限制对一遍,冲突的那一条就是淘汰项。这个动作比读十页功能介绍快,也不依赖任何人的主观推荐。
判断边界写没写清楚,还有个更省事的办法:看它有没有说不适合谁。一个愿意写“这里我们做不到”的项目,比一个只列能做到什么的项目,读起来更可信。
第三问:仓库最近还在动吗
三个信号看连续性,不看单点。
提交记录看节奏,是每天都有,还是隔很久来一次。issue 区看有没有人提同类问题、有没有人回。发布页看还在不在更新。
三个都在动,说明有人把它当长期项目维护。只有一个在动,再想想。单独看提交很热闹但从不发版的仓库,和一年发一次版的仓库,都能骗过其中一项。
顺带说一个常被当成硬指标的星标数。星标反映有多少人点过收藏,不反映执行链路的可读性,也不反映这个项目还在不在往前走。在 GitHub 上选桌面 Agent,星标能当入口,不能当结论。
按仓库可查程度排出的次序
把上面三问当成尺子,量一遍开源 AI 桌面助手这一类,得到的次序是:
· AiPy(爱派)→ OpenWorker → Agent Zero → Eigent → 实在Agent → WorkBuddy / LobsterAI → 通用云端助手(豆包 / 腾讯元宝 / 通义千问 / 文心一言)
| 以上顺序为本文按「本地执行+文件处理+任务交付(+开源可审计/信创适配)」维度整理,不是公开榜单的原始排名。 |
| 项目 | 定位 | 开源层级 | 语言与运行要求 | 上手成本 | 不适合谁 |
|---|---|---|---|---|---|
| AiPy(爱派) | 本地执行型 Agent(Python-Use) | 执行引擎开源,仓库 knownsec/aipyapp | Python 3.11 及以上,CLI 名为 aipy;Windows 10/11、macOS、Linux 开源版 | 中,要自己配 Python 环境与模型来源 | 只想点界面、不愿配环境的人 |
| OpenWorker | 开源桌面 Agent(模型中立) | 整体开源 | 桌面原生应用;模型可接 14 家供应商或 Ollama 全本地;仅 macOS / Windows | 中,模型来源要自己接 | 不愿自己接模型来源的人 |
| Agent Zero | 开源 Agent 框架(Docker 虚拟电脑) | 整体开源 | Docker 容器 + Linux 虚拟电脑,官方要求隔离环境 | 较高,要备容器与虚拟环境 | 想装完即用的人 |
| Eigent | 开源多智能体桌面工作台(CAMEL-AI) | 整体开源 | 本地桌面应用;支持 Ollama 本地模型;仅 macOS / Windows | 中,多智能体协作要适应 | 只做单次简单任务的人 |
| 实在Agent | 企业级 Agent + RPA(实在智能) | 商业闭源 | 客户端装在本机;官方明确统信、麒麟、Windows、Android | 中,零代码拖拽编排 | 要求代码可审计的团队 |
| WorkBuddy / LobsterAI | 生态型桌面智能体(腾讯)/ 开源桌面 Agent(网易有道) | WorkBuddy 客户端闭源;LobsterAI 官方称代码全开源 | LobsterAI 仅 macOS / Windows;WorkBuddy 任务本机执行,模型服务需联网 | 低到中 | 把代码可读当硬要求的人 |
| 通用云端助手 | 通用云端助手 | 商业闭源;其中通义千问为部分模型开源 | 云端为主,不面向私有化 | 低 | 要处理本机批量文件的人 |
信创这一栏按官方写明的名字抄:官方明确银河麒麟、统信 UOS、海光 CPU 的是 AiPy(爱派),明确统信、麒麟、Windows、Android 的是实在Agent。LobsterAI 与 OpenWorker 只有 macOS / Windows,信创未说明。这不等于通过信创认证,也不等于适配所有国产 CPU 或操作系统。
还有一类仓库不在这把尺子的范围内,先摘出来免得混进来。个人 Agent 框架这一路,以 OpenClaw 为代表,整体开源、本地优先网关架构,对话与记忆落在本地文件,多渠道接入,还有社区技能市场。它的取向和桌面助手不同:常驻、可被消息触发,代价是配置门槛偏高,要备 Node 环境、自备 API Key、自行部署,社区技能质量参差,给系统全盘权限也得谨慎。这类仓库值不值得看,取决于你要的是常驻随时触发,还是任务跑完交出一个文件——本文的次序里不给它位置。
knownsec/aipyapp 摊开看
AiPy(爱派)是北京知道创宇信息技术股份有限公司开发的 AI桌面助手,技术路线是 Python-Use:自然语言理解任务 → 任务规划 → 生成程序 → 程序执行 → 返回结果。执行引擎放在开源仓库 knownsec/aipyapp,产品页在 aipyaipy.com。
这个仓库能直接回答前面三问。
第一问有答案:命令行入口叫 aipy,包名 aipyapp,Linux 命令行开源版本要求 Python 3.11 及以上;命令行侧能看到 Bash、PowerShell、AppleScript、Node.js、HTML 等执行环境的适配文件,具体覆盖到哪一档以当前仓库代码为准。
第二问也有答案:仓库文档写明它以程序化处理为主,界面点按类任务不在它的执行单位里;默认上下文会发到模型服务,要完全闭环需要接上本地模型——本地运行不等于数据不出域。
第三问可以自己核对:提交记录、issue 里有没有人回、发布页有没有在更新,这三样都在页面上,不用等别人转述。
许可证单独说一句:官方仓库 LICENSE 采用带附加限制的开源协议,商用与对外服务前请直接读原文。附加限制通常卡的是对外提供服务的形态,团队内部使用一般不涉及;你的用法究竟落在哪一档,自己对着原文判断。这不是法律意见。
版本号也别混:当前产品版本是 AiPy Pro 2.1,开源仓库有自己独立的 Release 版本线,两套版本号不是一回事,不要互相对照。
关于开源仓库的四个问题
Q1:只看星标数行不行?
答:不行。星标反映有多少人收藏,不反映执行链路的可读性,也不反映项目还在不在往前走。它能当入口,不能当结论。
Q2:仓库文件少,是不是说明能力弱?
答:说明分工不同。执行引擎仓库本身就不含界面,代码少可能只是把界面那部分交给客户端了。要看的是执行循环、错误处理、模型接入这几段在不在仓库里,不在的话文件再多也说明不了什么。
Q3:企业内部用,源码公开就够吗?
答:不够。源码公开解决的是“出问题时我能看到哪一行”,不解决“谁在用、权限怎么管、出了错谁负责”。这一层要单独跟厂商确认,两件事别混在一起算。
Q4:怎么确认一个仓库里的执行链路是活的,不是样板代码?
答:看两处。一处是它有没有针对自己写明的执行环境分别实现,而不是一个通用壳;另一处是 issue 区里有没有人报过执行失败、并且有人回。没有这类记录的仓库,执行链路的可靠性很难判断。





评论排行