
【ZiDongHua 之“自动化工程派”标注关键词:HydroAIM 大模型 水文 建模 水利HydroAIM 大模型 水文 建模 水利 】
水利系赵建世团队研发HydroAIM实现大模型水文自主建模
近日,清华大学水利系赵建世团队联合清华大学计算机系、国能大渡河大数据服务有限公司和智谱AI,在《Journal of Hydrology》发表题为《Grounding large language models in hydrologic modelling》的研究论文。研究提出面向水文时间序列预测的大语言模型智能体建模方法HydroAIM,让通用大语言模型能够可靠参与专业水文建模。
清华大学水利水电工程系博士生李英嘉为论文第一作者,赵建世教授为通讯作者。相关研究获得国家自然科学基金项目和深圳市科技计划项目资助。
HydroAIM 智能体构建方法
HydroAIM将专家任务工作流、基于MCP的多智能体架构、标准化算法工作流(SAW)库和闭环执行工具箱整合为统一框架。在收到领域专家设定的水文建模目标、水文数据范围后,智能体能够自主完成任务分析、数据处理、模型构建和结果输出。

图1:HydroAIM总体架构与工作流程
科学问题一
大模型能否自主完成完整水文建模
研究选取GPT-5.5、Claude-Sonnet-4.5、Gemini-2.5-Pro、DeepSeek-v3.2和Qwen-Plus,设置单变量与多变量输入、指定模型建模与自主选择建模,单一建模与批量建模等任务。结果表明,HydroAIM在125次实验中取得92.8%的总体执行成功率。说明在专家约束、专业算法资产和确定性执行环境支撑下,大模型智能体的端到端执行能力能够跨不同大模型保持稳定,自主组织并完成完整的水文建模流程。
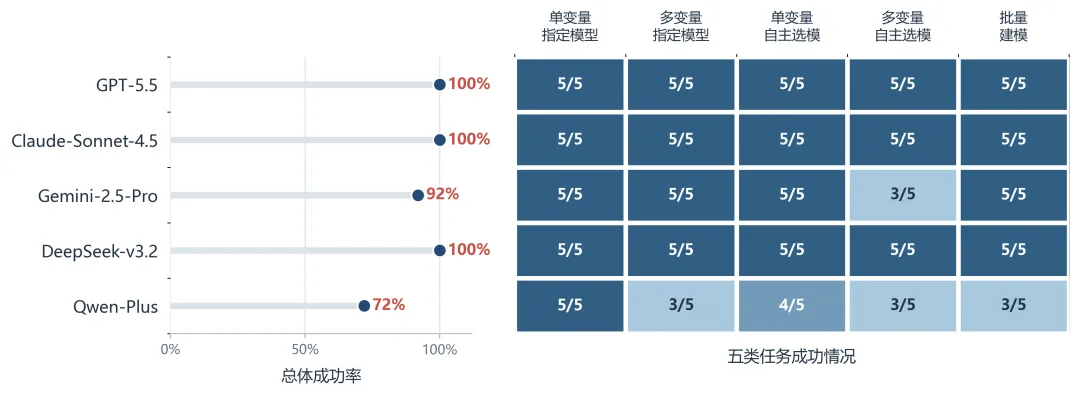
图2:HydroAIM在5种大语言模型驱动下的任务执行成功率
科学问题二
哪些机制决定复杂任务可靠执行
消融实验显示,长程任务规划是限制大语言模型执行水文定量任务的核心瓶颈,专家任务工作流是维持全局规划和阶段衔接的关键约束。多智能体分工、SAW算法约束和执行反馈能够进一步保证复杂任务稳定推进。
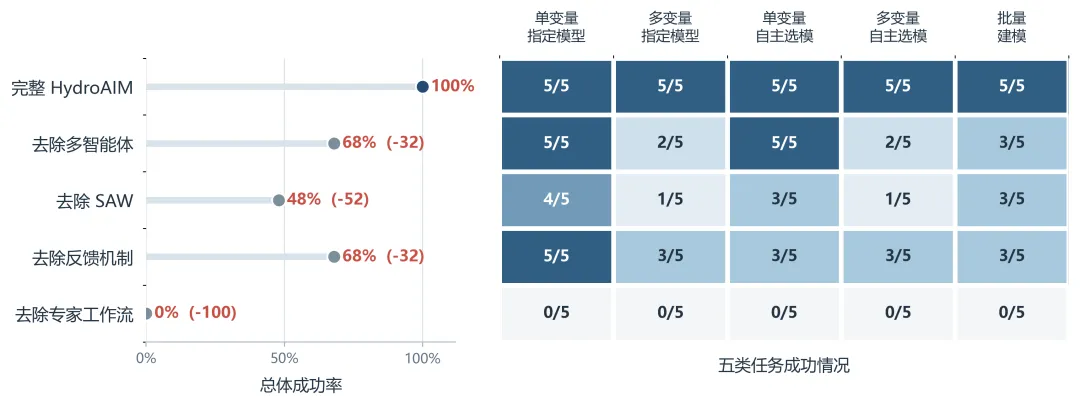
图3:完整HydroAIM与4类消融变体方法的任务成功率对比
科学问题三
自主建模结果能否达到专业基准
在局部建模实验中,HydroAIM连续5次建模NSE为0.58—0.59,接近SAC-SMA/Snow-17物理模型基准。表明在统一的气象驱动、率定测试期和流域范围下,智能体能够稳定搭建接近物理模型基准的建模流程,达到可用的水文模拟水平。
在全局建模任务中,研究进一步引入Skills机制,将数据合并、多尺度归一化和分布式评价等封装为可按需调用的技能。智能体根据提示自主整合流域的气象驱动与静态属性,完成全局训练和逐流域评价。模型的NSE为 0.73,达到公开大样本LSTM研究的基准水平,并显着优于物理模型基准,说明HydroAIM具备水文有效性和规模扩展能力,能够从单流域的局部建模扩展到大样本全局建模。
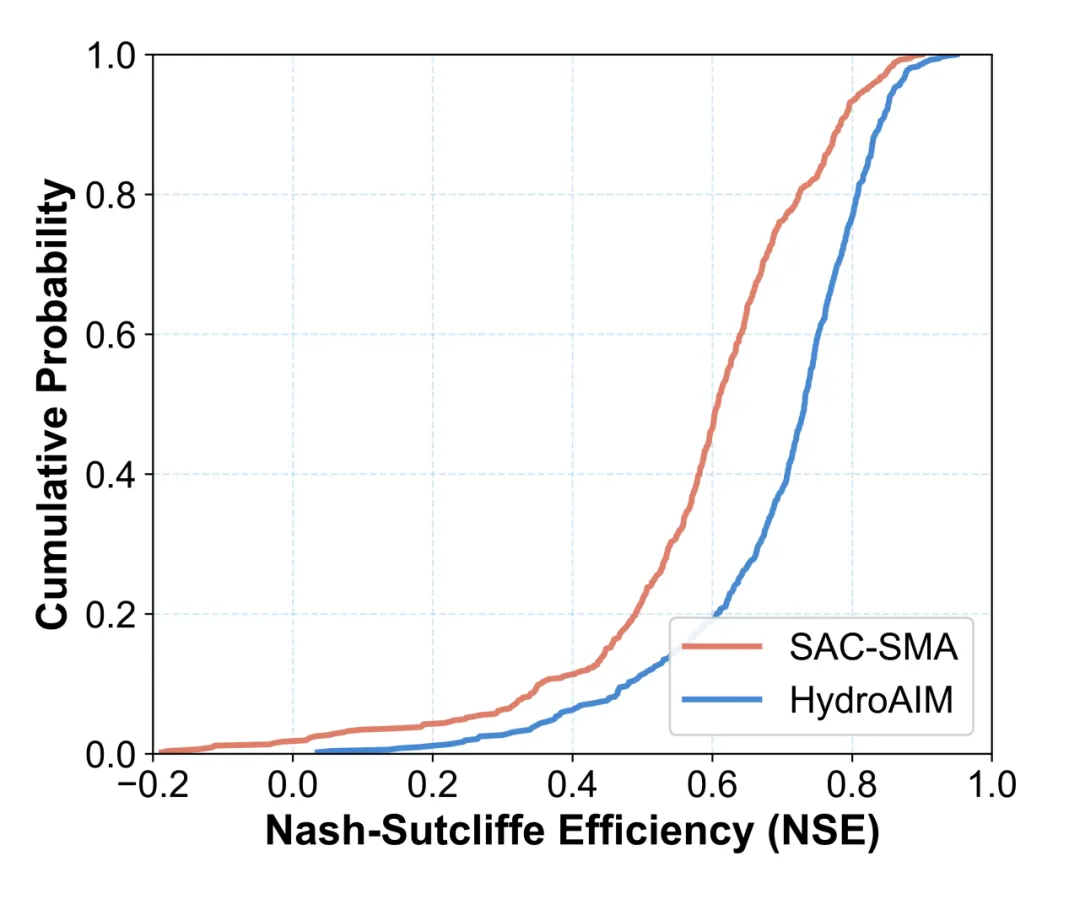
图4:HydroAIM建模与物理基准模型的NSE累积分布对比
研究也明确了HydroAIM的适用边界:自主执行不代表完全脱离行业专家,专家仍需设定任务目标、数据范围,并判断建模结果的水文合理性;当前方法主要验证数据驱动建模流程的自主执行,物理建模和流域特定建模仍有待进一步研究分析。
本研究更广泛的学术价值在于,示范了“专家经验外化为工作流与算法库、大模型负责推理编排”的多智能体协同建模路径,为人工智能驱动科学研究(AI for Science)在各专业科学领域的定量任务落地提供了可复制、可扩展的架构参照。
论文信息
论文题目
Grounding large language models in hydrologic modelling
期刊信息
Journal of Hydrology, 679 (2026), 136358;2026年9月6日在线发表
作者
Yingjia Li(李英嘉)、Shiruo Hu(胡诗若)、Feng Zhang(张峰)、Xinpeng Yu(余昕鹏)、Wei Luo(罗玮)、Dingxiao Liu(刘丁枭)、Bin Xu(许斌)、Jianshi Zhao(赵建世)
论文链接
https://doi.org/10.1016/j.jhydrol.2026.136358(点击阅读全文)






评论排行