
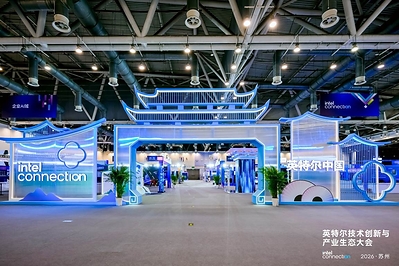
9月22日至23日,以"同芯•智远"为主题的2026英特尔技术创新与产业生态大会在苏州国际博览中心举行。作为英特尔数据中心事业部(DCG)中国区首家国产SSD战略合作伙伴,忆联深度参与本次大会。会议期间,忆联与英特尔联合发布面向Agentic AI时代的高性能KV Cache G3.5方案,并发表主题演讲、展示企业级亮点产品,全面呈现AI时代企业级存储的创新成果。
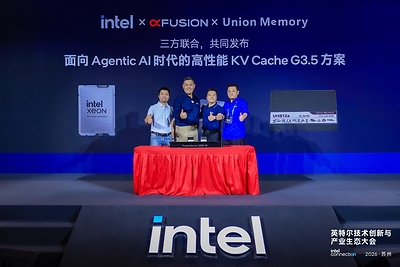
联合发布G3.5方案应对Agentic AI时代存储挑战
随着上下文窗口、并发会话和智能体运行时长持续增长,KV Cache 已从GPU的内部实现细节,演变为决定首 Token 时延(TTFT)、系统吞吐、GPU利用率和部署成本的关键基础设施资源。基于此,忆联携手英特尔发布高性能KV Cache G3.5方案。
英特尔数据中心集团副总裁、中国区总经理陈葆立,忆联总经理寇朋韬共同出席发布仪式。该方案以英特尔® 至强® 6 处理器为核心,基于忆联高性能UH812a企业级SSD,构建分层KV Cache架构,充分释放双方在算力与存储领域的协同创新。
寇朋韬表示:"海量KV Cache正在成为系统核心瓶颈——GPU昂贵的HBM带宽被持续消耗,推理延迟难以控制。正是基于这一挑战,G3.5方案应运而生,让企业级SSD从单纯的存储介质,进化为承载KV Cache的大容量溢出层,为智能体的持续推理与上下文保留提供坚实支撑。这一方案凝聚了英特尔坚实的算力底座、忆联领先的企业级存力引擎。只有当算力与存力真正高效协同,智能体才能跑得更久、更稳、更经济。"
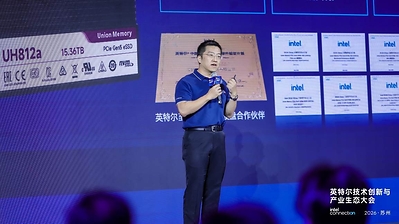
G3.5:重构LLM存储层级加速AI推理落地
大会期间,忆联副总裁杨锦平发表题为《G3.5:重构LLM存储层级,加速AI推理落地》的主题演讲,重点阐释G3.5在新一代AI推理架构中的定位与价值。
杨锦平指出,LLM推理为数据引入了新的"热度维度":KV Cache的访问频率与复用窗口不再单一,既承载 LLM 推理时活跃参数的状态,又需要在推理会话期间持续保留,供后续token生成复用,部分数据还需跨会话长期留存。这种频率与时效的双重维度,使KV Cache需要在HBM、DRAM、SSD之间分层流动。
在此背景下,G3.5 作为GPU内存/主机DRAM与后端共享存储之间的独立层级,通过大容量、高性能企业级SSD承接长期上下文与KV Cache数据,在容量、性能与成本之间形成更优平衡。相较传统层级,G3.5可将KV Cache的扩展容量从单卡HBM的几十GB提升至系统级,为多轮智能体、大型上下文及稳定并发等生产环境提供持续支撑。
多款创新产品亮相, 助推AI产业发展
围绕大模型训练、推理、Agent应用及海量数据管理等核心场景,忆联集中展示了UH713a、UH812c/UH832c、UM301a等企业级SSD及E1.S形态产品,形成覆盖高性能、低功耗与更优TCO的完整产品布局,全面满足AI时代多样化存储需求。
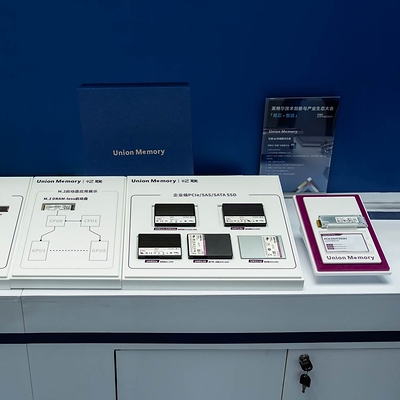
针对不同AI工作负载,忆联展出三款企业级SSD:
UH713a作为国内首款8通道数据中心级SSD,依托自研主控与固件深度调优,为AI训练等高负载场景提供性能与能效兼顾的存储支撑;
UH812c/UH832c搭载新一代NAND,相较上一代顺序写入性能提升14%,随机写入提升20%,4K随机读取延迟低至52µs,为AI训推及企业核心业务提供高吞吐、低时延支持;
UM301a采用DRAM-less设计,全面支持掉电保护及带外管理等企业级特性,为服务器提供低功耗、高可靠的启动支撑。
此外,现场展出的E1.S形态产品进一步丰富了忆联企业级SSD的产品形态。E1.S凭借紧凑尺寸、高密度部署、热插拔及更灵活的散热设计,可更好适配1U服务器等高密度计算平台。结合M.2、U.2、E3.S等形态,忆联进一步展现了面向不同服务器架构与业务负载的灵活适配能力。
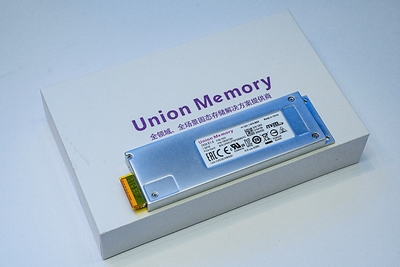
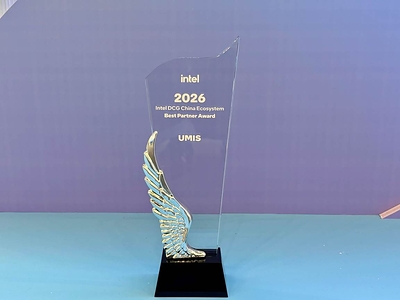
从成为英特尔DCG中国区首家国产SSD战略合作伙伴,三度参与 Connection大会、到联合发布G3.5方案,并斩获最佳合作伙伴奖,忆联与英特尔的合作正不断向系统架构与产业生态纵深延伸,持续以技术协同推动 AI 存储创新。
未来,忆联将继续携手英特尔及产业生态伙伴,推进下一代AI存储的技术创新,从技术创新到应用场景落地,为Agentic AI规模化落地构建高效、可靠且更具成本优势的数据底座。






评论排行