
【ZiDongHua之“会展品牌秀”标注关键词:昆仑技术 算力 推理 华为全联接 服务器】
16卡全互连,定义大规模推理新标杆|昆仑技术三款新品亮相华为全联接大会2026
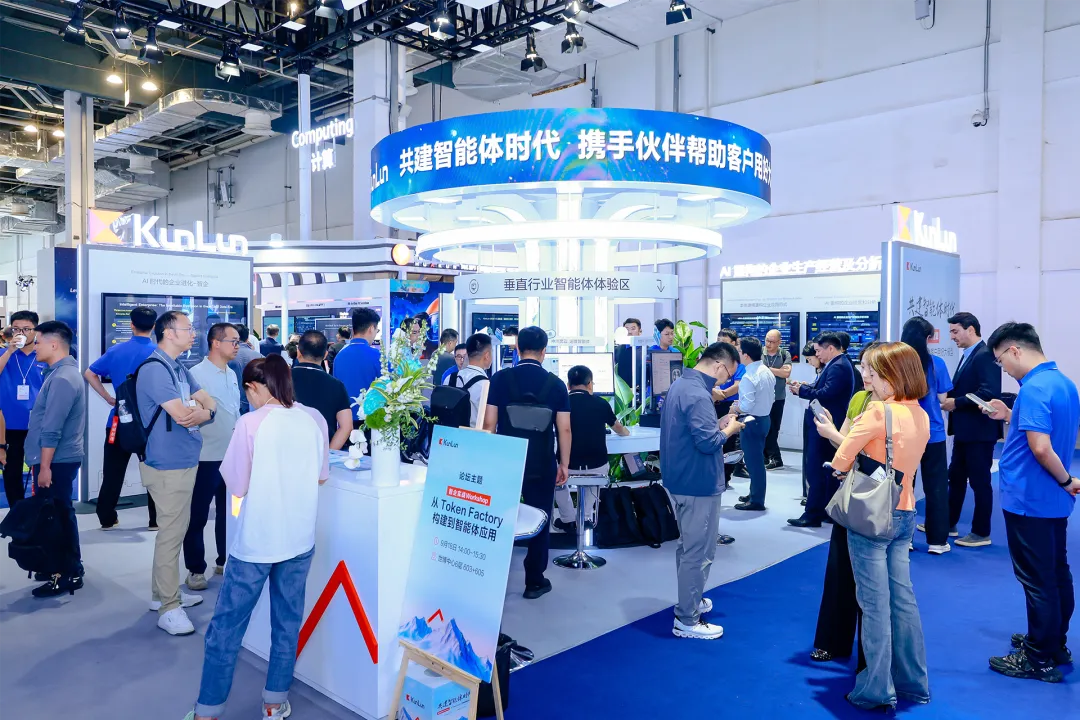
近日,华为全联接大会2026(Huawei Connect 2026)在上海举办,河南昆仑技术有限公司(以下简称:昆仑技术)携旗下三款AI领域全新算力产品亮相展台,覆盖数据中心级高密度AI训练推理、传统机房算力升级、办公室级边缘AI推理三大核心场景,完成面向全场景AI算力的产品布局首秀。
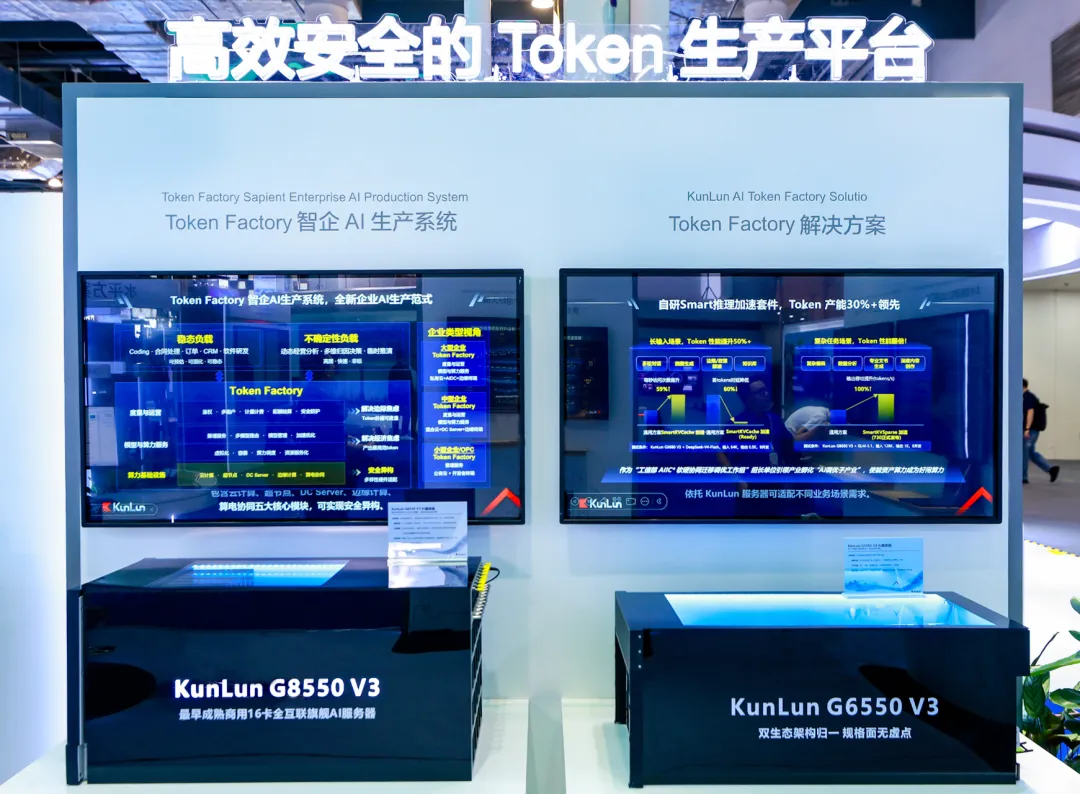
KunLun G8550 V3
16卡全互连AI算力底座
作为业内率先实现16张Atlas 150加速卡全互连,并成熟商用的AI服务器,KunLun G8550 V3面向大语言模型推理、MoE专家并行计算、大规模推荐系统、NLP处理等高密度AI算力场景,从算力密度、互连架构到运行可靠性完成系统性设计,有效提升单Token生成效率与并发请求承载量,帮助推理服务实现更高的吞吐能力与更优的响应时延,显著提升推理集群的资源利用效率。
卓越性能
全精度覆盖释放推理吞吐潜力
支持2颗AMD Turin CPU,最大TDP 500W;
支持16张Atlas 150加速卡,最大提供24.96 PFLOPS FP4/12.86 PFLOPS FP8/6.8 PFLOPS FP16算力,16*112G显存,1.4TB/s带宽。
灵活配置
适配多元推理业务部署需求
支持多形态AI加速卡,最高TDP 600W,支持尾部和顶部供电;
支持10张标准网卡和2张OCP网卡,适配复杂业务组网。
领先架构
全链路冗余保障业务连续运行
22kW的冗余供电池与20组大功率风扇阵列,确保模型算力利用率始终处于峰值,保证业务高可靠、零降频、零宕机;
模块分区散热设计,关键部件定向散热,适配机房冷热通道隔离要求。
全场景算力布局
覆盖机房升级与办公级推理场景
本次展出的另外两款产品分别面向传统数据中心算力升级与边缘办公推理场景,与G8550 V3形成梯度互补,共同构建覆盖不同部署环境、不同算力规模的全场景算力产品矩阵。
KunLun G6550 V3
双生态架构归一,规格面无虚点
KunLun G6550 V3系列服务器定位于双生态AI算力平台,支持AMD与鲲鹏双算力路线,单颗处理器最大TDP 500W;整机支持8张Atlas 150加速卡,可提供12.48 PFLOPS FP4算力,显存带宽达1.4TB/s,可满足中大规模AI推理与中小模型训练的综合算力需求。
产品充分适配传统数据中心的机房改造限制,支持前后维护灵活选配,降低部署与运维的场地门槛;互连拓扑支持直通、Switch Fabric等多种模式,搭配4张参数面网卡,可支撑多机集群扩展。架构层面支持单、双输入电源配置,预留下一代加速卡的供电冗余,帮助客户以较低改造成本完成算力升级,该产品后续将陆续量产上市。
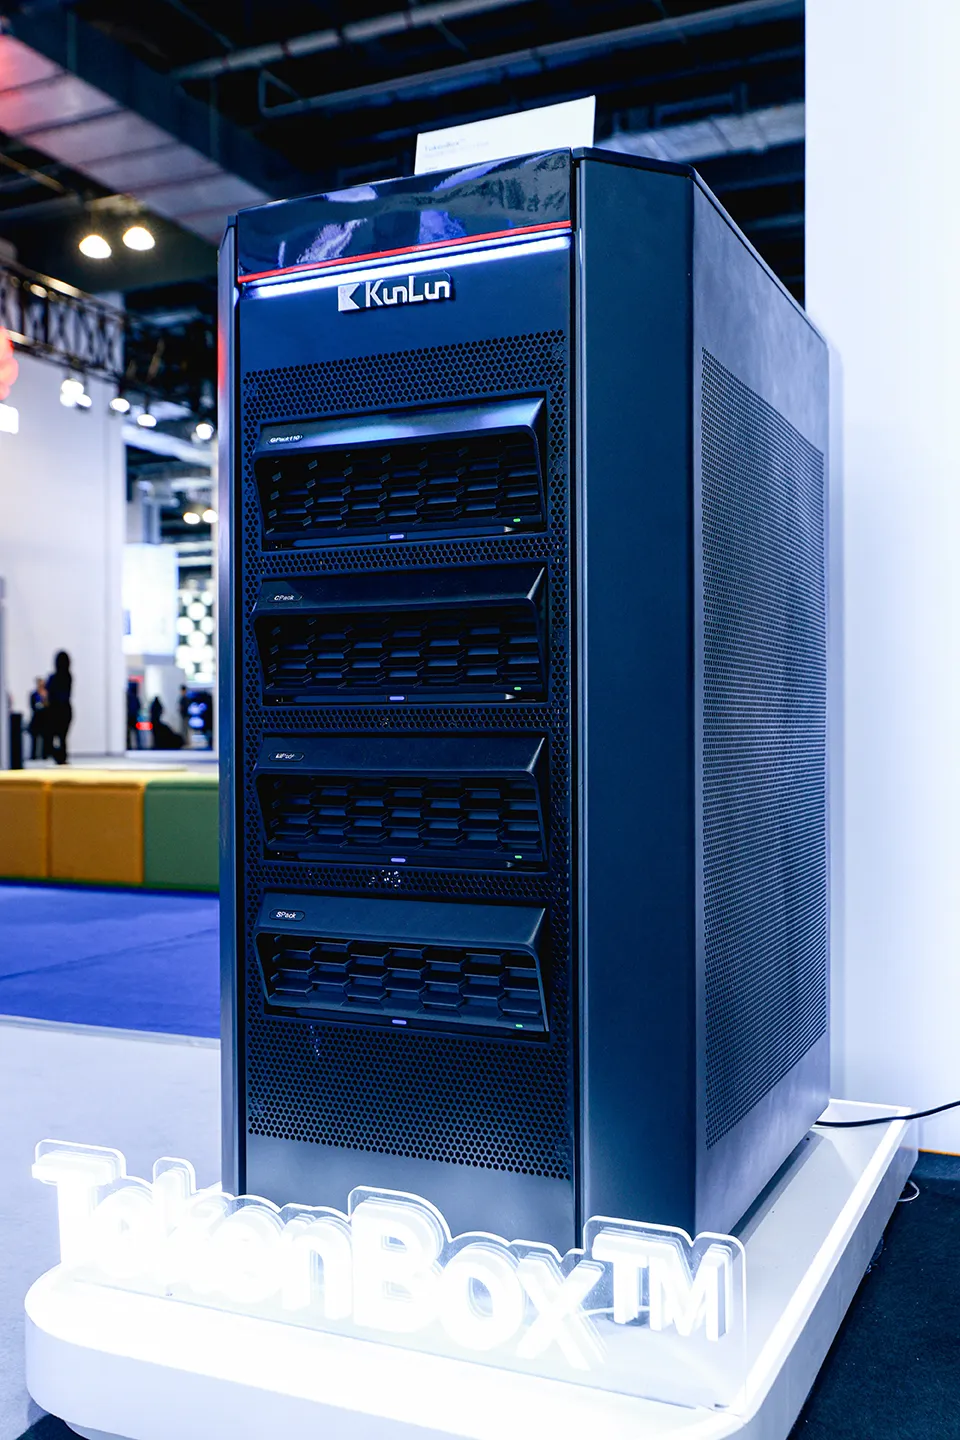
TokenBox™
本地AI超级工作站
针对边缘与办公场景AI部署的二元困境:工作站算力瓶颈明显、数据中心服务器部署与运维门槛过高。TokenBox™打造了软硬一体的本地化Token生产平台,实现即插即用的AI能力交付。
硬件层面,TokenBox™以鲲鹏处理器为通用算力底座,采用Pack式弹性扩展架构,单Pack可安装2张Atlas 150加速卡,满配支持8张NPU,单机可承载1.6T参数规模的大模型部署。通过DC级液冷技术实现极致静音,满载运行噪音低于40dB,轻载低于35dB,可直接部署于办公环境,无需专用机房配套。
软件层面,产品集成全栈AI软件与模型管理能力,内置主流大模型,支持Token的度量与运营管理,适配AI Coding、Agentic AI、OPC等办公场景,帮助企业快速构建安全可控的本地化AI能力。该产品后续也将按规划推进量产落地。
构筑全场景Token工厂
与昇腾共赴算力新未来
此次三款产品的集中亮相,是昆仑技术面向AI时代算力需求的战略落地。随着大模型技术向各行业深度渗透,Token正在成为企业智能化升级的核心生产要素,而稳定、高效、可按需部署的算力基础设施,是实现Token像水电一样按需供给的核心底座。
从数据中心级的大规模推理算力集群,到适配传统机房的升级型算力平台,再到可直接部署于办公场景的本地化Token生产单元,昆仑技术正在构建覆盖全场景的Token工厂产品体系。随着KunLun G8550 V3于10月率先量产,公司将持续推进算力产品的迭代与落地,以可靠的工程能力、适配场景的产品设计,为不同规模、不同场景的企业客户提供高质量的AI算力基础设施,助力各行业实现AI能力的平滑落地与高效运营。


评论排行