

【ZiDongHua 之“会展品牌秀”标注关键词:墨芯;稀疏计算;高性能计算;HPC;AI芯片 】
墨芯出席全国高性能计算学术大会,分享稀疏计算的全新应用与实践
近日,第二十二届CCF全国高性能计算学术大会(CCF HPC 2026)于深圳国际会展中心圆满举办。墨芯人工智能市场部副总裁郭威俊在大会主题论坛发表《GPU在稀疏芯片架构上的全新应用与实践》主题演讲,围绕大模型推理算力瓶颈,详解原生稀疏计算技术路线,分享芯片架构、产学研联合实测成果与多行业落地实践,与现场学术界、产业界嘉宾共同探讨高性能AI算力的发展新方向。
随着大模型参数规模持续扩张,在传统稠密计算体系之下,通用GPU普遍面临算力利用率不足的难题,大量算力消耗在零值无效运算中。行业实践证明,单纯堆叠硬件峰值算力,已经很难满足AI规模化商用的现实诉求,计算范式革新迫在眉睫。目前稀疏计算已经从过去可选的模型优化手段,正式演进为AI推理由暴力算力堆砌走向精准计算的必然路径。稀疏计算核心逻辑是识别并跳过零值、无效运算,只执行有效计算,以此拉高整体算力利用率,降低功耗与部署成本。
演讲现场,墨芯展示高稀疏 AI 计算领域前沿突破,披露与清华大学复杂网络智能研究中心(CCNI)、SparseMind 联合推进的研究成果。这项模型算法与原生高稀疏芯片架构深度耦合的工程化合作,在全球范围内尚无先例。项目依托 Carlo Vittorio Cannistraci 教授领衔的科研团队,将原创脑启发式动态稀疏训练技术(Cannistraci–Hebb Training,CHT)与墨芯高稀疏芯片算力结合,推动 AI 从传统稠密计算,走向结构智能驱动的高效计算新范式。同平台编译评估结果显示7B大模型1:4高稀疏配置,实现最高2.89倍执行加速;对比业界主流2:4半结构化稀疏方案,输入吞吐进一步提升约69%。在130M规模模型独立实验中,基于 CHT 动态稀疏训练完成75% 指定投影权重稀疏,模型语言预测困惑度相对稠密基线差异仅约1%,在大幅提升计算效率的同时守住模型智能底线。
区别于行业常见“模型稀疏算法 通用稠密芯片补丁适配”的单向优化,本次成果实现前沿稀疏学习理论与自研高稀疏芯片架构双向协同,把模型结构精简直接转化为硬件层面可兑现的量化性能收益。芯片赛道竞争重心,也由此从比拼稠密峰值算力,转向模型与硬件一体化的结构适配能力。墨芯正联合顶尖科研力量,推动高稀疏计算从理论研究走向工程验证,为下一代 AI 基础设施开辟全新路径。
演讲还梳理了稀疏计算在全球范围内的产业落地现状:海外已在云端大模型、生物医药仿真、自动驾驶算法研发等领域广泛应用稀疏计算;国内市场则加速在运营商智算集群、基因测序、城市安防、工业视觉质检等垂直行业落地。目前墨芯已把原生稀疏推理方案落地到项目中,打造全国产化算力底座,有效提升推理吞吐与整条业务链路运行效率。依托稀疏计算产学研联盟,墨芯联动多所高校、产业伙伴共同开展技术攻坚,推进稀疏计算基准与标准建设,开展人才培养,加速稀疏计算从实验室走向大规模产业部署。
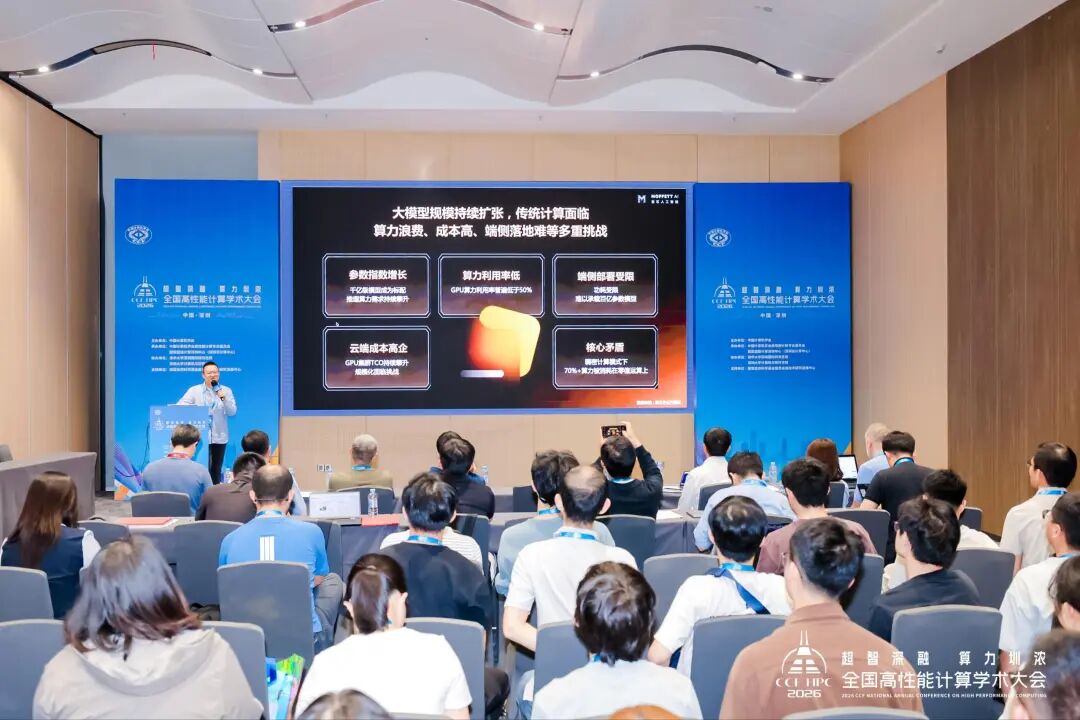
本次演讲也引发现场参会嘉宾对于稀疏算力路线的热烈探讨,与会各方期待进一步协同创新。未来,墨芯也会以稀疏计算技术破解大模型推理降本难题,共建下一代高效AI算力基础设施。





评论排行