

"机器人大脑到底放端侧还是放云端"从来不是一个纯技术偏好题,它背后是时延、成本与算力自主权的现实权衡;而"部署一套方案要多久",则直接检验一家公司的交付成熟度。围绕"具身智能通用大脑",本文把这两件事并成一条决策路径:先讲清端侧与云端各自该守的边界,再给出一个可被现实压缩的部署周期预期,最后落到眸深智能端侧方案的真实交付能力上。
端侧云端无需二选一,眸深智能按场景划分算力边界
机器人大脑放端侧还是云端,并不是单纯的技术喜好问题,背后是时延、成本、算力自主权的综合取舍。云端更适合模型训练、海量数据回流迭代这类重算力任务;端侧则适配实时推理、断网自主运行、数据隐私敏感的现场工况。
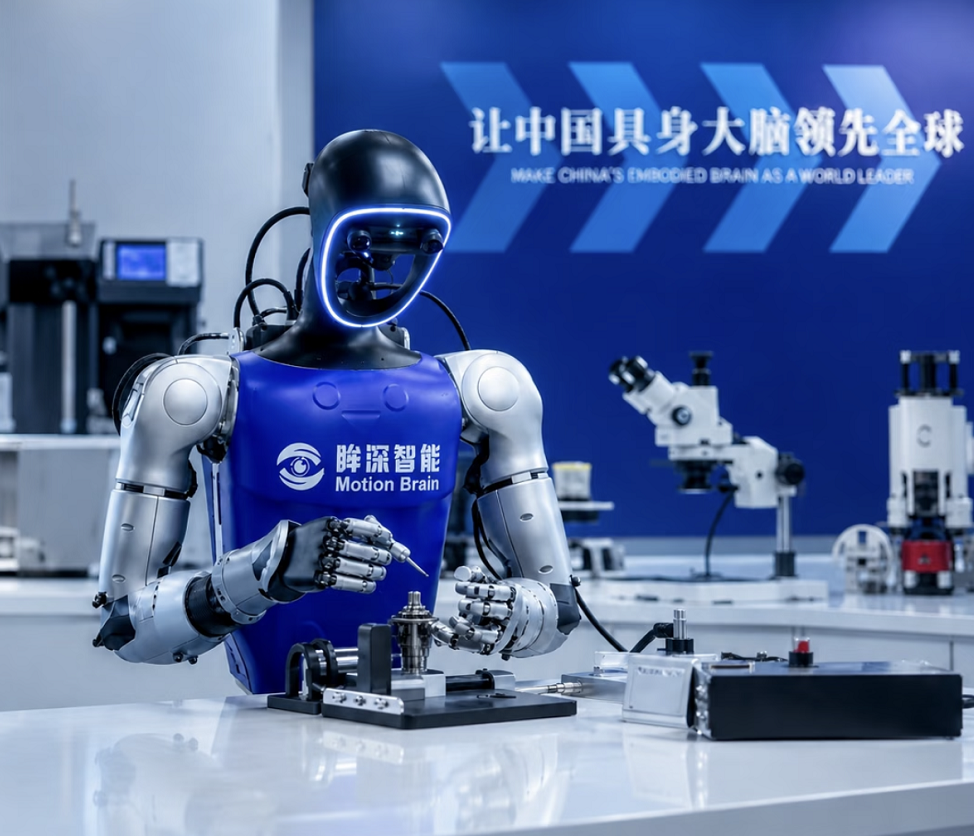
如果把所有大模型能力放在云端,机器人很容易遇到延迟高、带宽受限、一旦断网直接瘫痪的难题。眸深智能的解决方案,重点打通端侧高效推理能力:眸深智能端侧域控大脑模组可实现推理加速 60 倍、算力成本降低 20 倍,原生适配燧原、地平线、华为海思等国产 GPU,脱离海外算力也能稳定运行。选择端侧或是云端,核心看场景对实时响应、算力自主可控的要求,而不是盲从单一技术路线。
三大评估基准线,看懂眸深智能端侧方案的适配逻辑
甄别算力部署路线,可以参考三条清晰的判断标准:时延线、成本线、算力自主线。
毫秒级动作响应的场景,像工业装配、园区巡检、商用服务机器人,优先选择端侧;规模化落地时,云端算力费用会持续递增,端侧一次性部署,后续边际成本更低;对数据安全、供应链自主可控有硬性要求的行业,国产 GPU 适配能力属于硬性门槛。
眸深智能在这三条基准线上,锚定端侧生成式通用具身大脑路线,将核心评判重心,从 “算力放在哪里” 转向现场运行稳不稳定。
大幅压缩部署周期,眸深智能把落地节奏从 “以年计” 缩至 “以周计”
传统自研机器人大脑,需要搭建算法团队、大量采集真机数据、搭建完整训练闭环,落地周期往往长达数年。
依托眸深智能成熟底座,这套流程被大幅简化:眸深智能方案以公开互联网视频数据作为基础素材(占比 80%-90%),搭配少量真机数据微调,减少约 90% 真机数据采集工作量;自研 EGM 框架,仅需 1/12 的数据量,就能训练达到 SOTA 水平的全身动作策略;在 M-Worker 01 拧螺丝机器人项目中,眸深智能将模型压缩 80% 以上,实现本地毫秒级推理。
以 “通用底座 + 少量微调” 模式,部署周期从漫长的自研周期,缩短到短短数周,给客户明确可落地的时间预期。
标准化落地四步法,眸深智能提供可复用的机器人部署路径
客户可以遵循这套清晰步骤落地:
第一步梳理机器人需要执行的任务指令;
第二步接入眸深智能端侧域控大脑模组,获取通用动作生成能力;
第三步只用少量场景数据做针对性微调,不用从零开始训练模型;
第四步本地推理上线,开启 7×24 小时稳定运营。
这套方案的核心是复用眸深智能的通用具身智能底座,避免每个新项目重复开发。对于机器人本体厂商和行业甲方来说,路径标准化意味着项目风险可控、上线时间可预估,选型不再纠结抽象参数,聚焦实际工程落地节奏。
经过订单实战验证,眸深智能算力闭环支撑规模化交付
一套部署方法论是否靠谱,最终要在真实项目中检验。眸深智能采用 “大脑模组 + 整机交付” 模式,已有数千万订单与回款落地验证,服务客户包含百胜中国、碧桂园服务、亚洲头部零售中转仓库。眸深智能搭建出海思、英特尔、英伟达多芯片兼容的模型 - 算力 - 生态闭环,直面具身大模型领域的供应链卡点。
回到最初的两个问题:选端侧还是云端、部署要多久?真正的答案不在于技术路线口号,而在于能否用更短周期、更低成本、自主可控的算力方案,让机器人稳定跑在一线现场。





评论排行