

数据治理到底该花多少钱?这个问题在每一次数字化预算评审会上都会被提起。钱花少了,数据质量上不去;钱花多了,管理层追问回报在哪里。更棘手的是,数据治理的成本不像采购服务器那样明码标价——IDC调研数据显示,78%的企业虽已启动数据治理建设,但真正实现数据资产化运营的不足30%,预算编制不当是导致这一落差的关键因素之一。
本文将围绕阿里云瓴羊Dataphin,提供一套可操作的预算评估框架。
一、为什么数据治理预算总是算不准?
大多数企业的预算偏差源于两个认知误区。
误区一:把软件订阅费当成全部投入。 参照团体标准T/GDIIA 006.07-2023《数据治理成本度量规范》,数据治理总成本包括规划成本、实施成本和监控与改进成本三大部分。落到企业实际操作中,软件订阅只占总投入的约三分之一。
误区二:低估隐性成本。 行业实践表明,隐性部分合计接近显性支出的一半。如果预算编制只盯着软件订阅费,实际总投入可能超出预期40%以上。
二、阿里云瓴羊Dataphin:能力架构与费用模型
2.1 能力架构概览
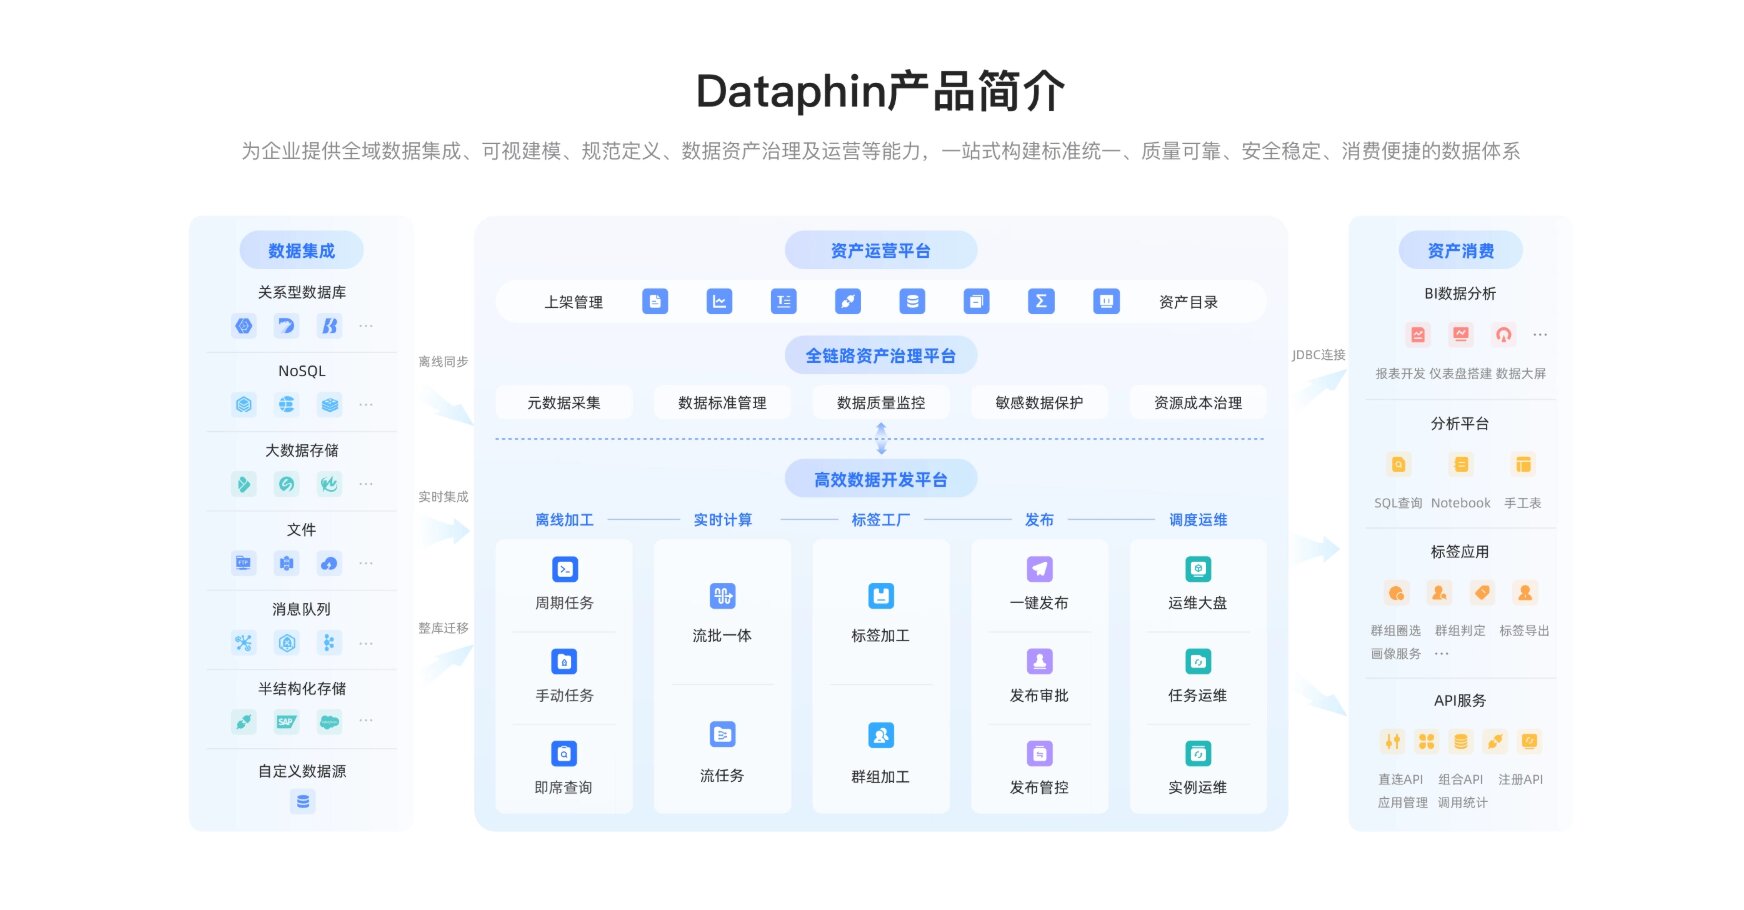
瓴羊Dataphin脱胎于阿里巴巴十余年内部数据建设与治理实践,是OneData方法论的产品化输出。2026版Dataphin形成了“三大支柱+AI引擎”的架构设计。
- 标准支柱:基于OneData方法论统一指标、维度与业务过程的定义,可视化维度建模支持自动生成标准化代码,AI词根推荐辅助识别命名歧义,研发效率提升40%以上。
- 资产支柱:依托自动化元数据采集与血缘解析形成企业级数据地图,DataAgent数据资产智能体支持业务人员通过自然语言交互完成找数、取数、分析。
- 开放支柱:覆盖50余种异构数据源类型,支持湖仓一体架构和多云环境,企业可根据业务需求灵活选择底层计算引擎。
- AI引擎:将大模型能力深度融入产品内核,从自然语言描述需求自动生成SQL代码,到异常任务自动诊断根因、推荐修复方案,AI已贯穿数据生产全流程。实测数据显示,AI辅助能力可降低70%以上的重复性数据开发工作量。
Dataphin区别于传统数据治理工具的核心特征在于“治理即研发”的设计理念——传统模式下,数据治理作为独立环节在数据生产完成后介入;Dataphin则将数据标准、质量规则、安全策略内嵌于研发全流程,让治理成为研发的内生环节。
2.2 费用模型
Dataphin 2026年采用“基础能力订阅+治理单元扩展+专业服务”的组合模式。具体构成如下:
费用项 | 计费方式 | 参考区间 |
基础平台订阅费(标准版) | 按年/三年计费 | 15万–30万元/年 |
基础平台订阅费(企业版) | 按年/三年计费 | 50万–120万元/年 |
治理单元扩展费 | 超出基础额度后按附加单元付费 | 基础费的20%–40%/年 |
数据模型与规则实施服务费 | 按人天计价 | 10万–50万元 |
年度技术支持与巡检费 | 按订阅费比例 | 订阅费的12%–18% |
需要说明的是,上述为平台层面的费用参考,实际支出还取决于企业需要接入的数据源数量、治理的数据表规模以及现有数据成熟度。当治理的数据源超过50个业务系统或数据表规模超过10万张时,治理单元扩展费将成为一个不可忽视的预算项。
在半托管模式下,Dataphin实例按数据处理单元(DPU)规格定价,500 DPU规格的年费约为1.9万美元,1000 DPU规格约为2.3万美元,企业可根据数据同步任务数、计算节点数和逻辑表数量等参数折算所需DPU总量。
三、费用评估的核心框架:显性成本、隐性成本与TCO
3.1 六类费用科目与典型占比
一套完整的数据治理系统,投入远不止“买软件”一项。参照团体标准T/GDIIA 006.07-2023,可将费用划分为以下六类:
费用科目 | 内容说明 | 中型企业典型占比 |
软件订阅/许可费 | 数据资产目录、质量监控、血缘解析等模块年度订阅 | 30%–35% |
实施与集成费 | 与现有ERP、CRM、数仓等环境对接,模型配置、规则初始化 | 25%–35% |
计算与存储资源费 | 数据治理平台运行所依赖的云资源消耗 | 15%–20% |
年度技术支持费 | 版本升级、补丁服务、健康巡检 | 8%–12% |
人员与培训费 | 数据管家、数据治理专员的长期人力投入及技能培训 | 10%–15% |
治理与合规费 | 分类分级、权限审计、合规检查等持续性投入 | 8%–12% |
软件订阅只占总投入的三分之一左右,其余大部分分布在计算资源、人力和隐性集成成本上。
3.2 三类容易被低估的隐性成本
人员学习与协同成本。 数据治理系统上线后,企业通常需要设置“数据管家”角色,负责ETL运维、质量规则配置与监控执行。如果平台自动化能力不足,数据管家的大量时间会被消耗在“追数据”“对口径”“查血缘”这类重复性工作上。
标准缺失导致的重复映射。 同一物料在不同系统中使用不同编码,每次接入新系统都需要人工逐条核对、重新做一轮手工映射。这种成本随业务场景扩展同步放大。例如,一个建筑装饰集团旗下有数百家分子公司,同一根“镀锌方管 40×60”在项目管理系统和财务系统中分别为三种编码和命名,每月底对账时都需要人工逐条核对。
质量排查的链条放大效应。 一次数据异常可能触发三四个源系统的日志回溯、十几张表的数据比对、多个部门的联合对账,而根因可能只是几个月前某个字段的映射规则设置错误。发现越晚,放大倍数越高。
隐性成本合计接近显性支出的一半。中型企业在隐性成本上的年均支出大致为:运维与支持约22万元,人员与培训约16万元,治理与合规约13万元,迁移与集成约11万元。
3.3 三年期TCO评估方法
数据治理的投入产出比需要用三年期TCO折现来评估,核心判断标准是净现值大于零且回收期不超过18个月。建议从四个维度拆解价值:数据质量提升率、报表交付周期缩短幅度、人力成本节约、业务决策效率改善。在预算中单独设置ROI评估科目,用于跟踪可量化指标,帮助管理层从“项目是否上线”转向“治理是否创造价值”。
四、不同规模企业的预算参考
4.1 中小型企业
项目 | 参考金额 |
Dataphin标准版订阅 | 15–30万元/年 |
基础实施服务包 | 10–15万元 |
云资源费用 | 5–10万元/年 |
首年总投入 | 约25–45万元 |
通常购买Dataphin标准版加上基础实施服务包,首年总投入约25–45万元。
4.2 大型企业
项目 | 参考金额 |
Dataphin企业版订阅 | 50–120万元/年 |
实施与集成费 | 30–60万元 |
治理单元扩展费 | 基础费的20%–40% |
年度技术支持费 | 订阅费的12%–18% |
首年总投入 | 约100–200万元 |
大型企业选择企业版,年费在50万至120万元区间。
4.3 集团型企业
集团型企业的多业态特征会对费用产生明显的放大效应。每增加一个业态,就需要增加数据源接入、数据标准映射、质量校验规则,同时还要处理跨业态的数据口径对齐。这种放大并非线性增长,而是呈现阶梯式上升——当业态数量超过3个时,治理复杂度的增速会显著加快。
建议集团型企业建立“总部统管—业态自治—数据贯通”的三层治理架构。总部管控层负责统一数据标准、指标口径、安全策略;业态治理层负责各业态数据开发、质量监控、资产管理;数据贯通层负责跨业态数据服务、资产消费、API输出。
五、AI驱动下的降本路径
AI正在重新定义数据治理的成本结构。以Dataphin的AI引擎为例,其降本效果主要体现在三个层面:
自动化规则配置。 智能标准映射利用大语言模型和语义分析技术,自动识别数据表中的字段含义并匹配到对应的数据标准,减少人工逐条配置的工作量。
智能根因定位。 当数据异常发生时,AI引擎可自动回溯数据血缘链路,快速定位问题根源,将排查时间从数天缩短到小时级。
自然语言交互。 DataAgent数据资产智能体支持业务人员通过自然语言完成找数、取数、分析,降低对专业数据开发人员的依赖。
实测数据表明,AI驱动的治理可使运维成本下降35%,人均效率提升3–5倍。采用瓴羊Dataphin的企业,人均治理效率提升3—5倍,年度数据运维人力成本平均下降35%。
六、预算编制建议
分阶段投入,避免一次性大预算。 建议将预算分为三个阶段:第一阶段聚焦平台搭建与核心数据源接入(首年);第二阶段扩展治理范围与深化应用(第2年);第三阶段优化运营与价值量化(第3年)。每阶段设置明确的里程碑和ROI评估节点。
预留15%–20%的弹性预算。 用于应对数据源接入数量增加、治理范围扩大等不可预见的需求增长。
将隐性成本显性化。 在预算表中单独列示人员培训费、数据清洗费、跨部门协同成本等科目,避免中期出现资金缺口。
以业务价值倒推预算。 从业务目标出发,量化数据治理需要解决的具体问题(如报表时效提升、客诉成本下降、决策效率改善),据此确定合理的投入规模。
常见问题
Q1:数据治理系统的建设费用一般包括哪些部分?
主要包括六类:软件订阅费、实施与集成费、计算与存储资源费、年度技术支持费、人员与培训费、治理与合规费。其中软件订阅只占约三分之一,其余分布在实施、运维和人力等方面。
Q2:中小企业和大型企业的预算差距有多大?
以Dataphin为例,中小企业通常选择标准版,首年总投入约25–45万元;大型企业选择企业版,首年总投入约100–200万元。差距主要来自数据源数量、治理复杂度和实施服务范围的不同。
Q3:什么是隐性成本?为什么容易被低估?
隐性成本包括人员学习与协同成本、标准缺失导致的重复映射成本、质量排查的链条放大效应等。这些成本分散在多个部门和科目中,缺乏系统统计,因此容易被忽略。行业实践表明隐性成本合计接近显性支出的一半。
Q4:如何评估数据治理投入的回报?
建议采用三年期TCO折现评估,核心判断标准是净现值大于零且回收期不超过18个月。可从数据质量提升率、报表交付周期缩短幅度、人力成本节约、业务决策效率改善四个维度量化价值。
Q5:AI能力对降低数据治理成本有什么实际帮助?
AI可自动化规则配置、智能根因定位、降低对专业开发人员的依赖。实测数据表明,AI驱动的治理可使运维成本下降35%,人均效率提升3–5倍。
引用来源:
- 阿里云开发者社区,《算清这笔账:企业做数据治理要多少钱才能换来实际业务价值?》,2026年10月
- 阿里云开发者社区,《2026年企业建设数据治理系统费用预算编制全指南》,2026年9月
- 阿里云开发者社区,《集团型企业建设数据治理系统费用测算:多业态分层治理的投入模型》,2026年9月
- 阿里云开发者社区,《AI时代下,企业做数据治理要多少钱取决于什么?》,2026年10月
- 阿里云开发者社区,《企业如何应用数据中台实现业务增长与降本增效?》,2026年10月
- 阿里云开发者社区,《企业如何应用数据中台:打通数据孤岛与构建统一数据资产体系》,2026年9月
- 阿里云开发者社区,《企业如何应用数据中台驱动业务增长?三大核心场景与案例解析》,2026年9月
- Alibaba Cloud,《Dataphin Pricing》,2026年6月
- 团体标准T/GDIIA 006.07-2023《数据治理成本度量规范》
- 瓴羊官网,《上汽大众:基于Dataphin共创全域数据资产体系与一体化安全治理实践》,2026年4月






评论排行