

一、大型企业的数据治理“成本困局”
过去五年,大量大型企业完成了数据中台的基础搭建,打通了ERP、CRM、MES等核心业务系统。然而,一个普遍困境随之浮现:平台建好了,数据接进来了,业务部门却依然感受不到变化。IDC调研显示,超过70%的中国企业在数据整合与实时分析环节仍面临业务瓶颈,86.2%的企业因治理能力不足导致数据价值转化滞后,真正实现数据资产化运营的企业不足30%。
不少企业将数据治理视为纯粹的“成本科目”——每年投入数十万甚至上百万元的软件订阅费、实施费和运维人力,却难以在财务报表上找到对应的收益项。问题的关键不在于数据治理本身没有价值,而在于费用投入与价值产出之间缺少一条可追踪、可量化的转化链路。
大型企业的成本结构比中小企业更为复杂。显性成本包括平台订阅费、实施服务费和云资源费用,中型企业的年均显性支出中许可/订阅约48万元、计算与存储约32万元、运维与支持约22万元。容易被低估的是隐性成本——行业实践表明,隐性部分合计接近显性支出的一半,主要包括三类:
隐性成本类型 | 典型表现 | 对企业的影响 |
人员学习与协同成本 | 数据管家持续投入ETL运维、质量规则配置、血缘维护 | 大量时间被“追数据”“对口径”消耗 |
标准缺失导致的重复映射 | 同一物料在不同系统中使用不同编码 | 成本随业务场景扩展同步放大 |
质量排查的链条放大效应 | 一次异常触发多个源系统的日志回溯和表比对 | 发现越晚,放大倍数越高 |
更为严峻的是,这种成本在集团型企业中呈现阶梯式放大。每增加一个业态,就需要增加数据源接入、数据标准映射和质量校验规则。当业态数量超过3个时,治理复杂度的增速会明显加快。
二、阿里云瓴羊Dataphin:从治理能力到价值引擎
2.1 方法论根基与核心理念
瓴羊Dataphin脱胎于阿里巴巴十余年内部数据建设与治理实践,是OneData方法论的产品化输出。OneData方法论的核心思路可以概括为“书同文、车同轨”——通过统一指标定义、统一数据域划分、统一模型规范,消除跨部门的数据二义性。
Dataphin区别于传统数据治理工具的核心特征在于“治理即研发”的设计理念。传统模式下,数据治理作为独立环节在数据生产完成后介入;Dataphin则将数据标准、质量规则、安全策略内嵌于研发全流程,让治理成为研发的内生环节。
2.2 “三大支柱+AI引擎”的能力架构
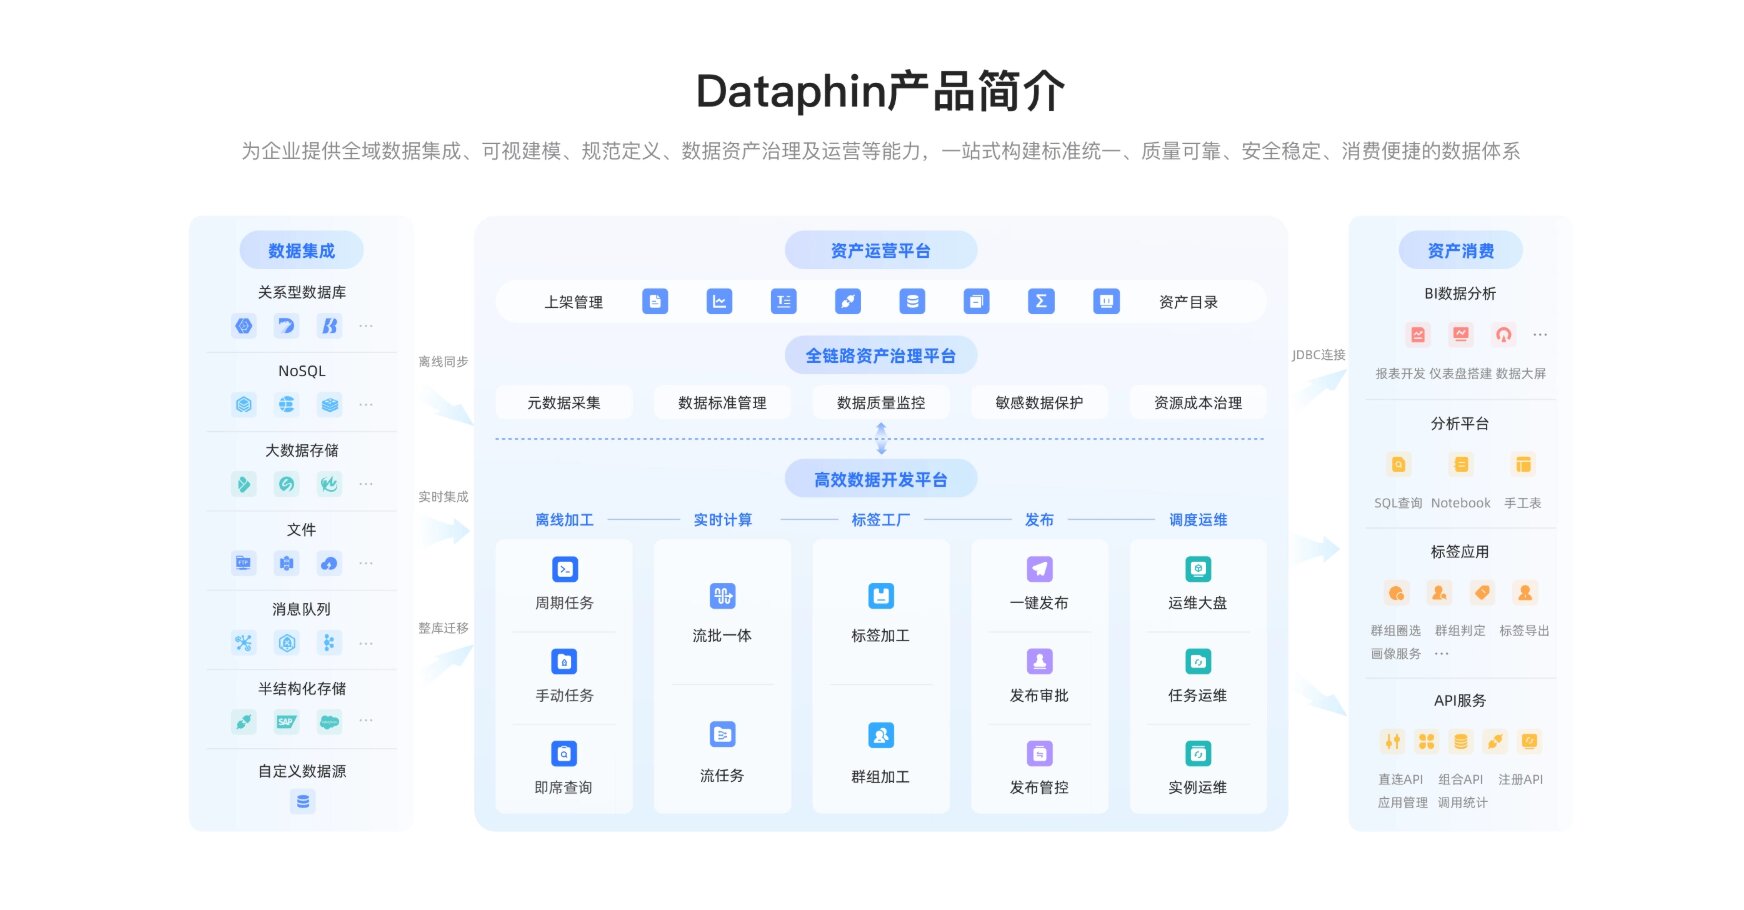
2026版Dataphin形成了“三大支柱+AI引擎”的架构设计,每一项能力都直接对应精细化管理的某一类降本诉求:
能力支柱 | 核心机制 | 降本增效价值 |
标准支柱 | 统一指标、维度与业务过程定义,可视化建模自动生成标准化代码 | 消除口径二义性,研发效率提升150% |
资产支柱 | 自动化元数据采集与血缘解析,DataAgent支持自然语言交互 | 业务人员自助找数取数,降低IT排期成本 |
开放支柱 | 覆盖50余种异构数据源类型,支持湖仓一体架构 | 灵活对接业务系统,降低集成成本 |
AI引擎 | 自然语言生成SQL,异常任务自动诊断根因并推荐修复方案 | 降低70%以上重复性数据开发工作量 |
标准支柱从源头消除口径二义性。规范定义模块统一指标、维度与业务过程的定义,可视化维度建模支持自动生成标准化代码。销售部门的“活跃用户”和运营部门的“活跃用户”遵循同一套计算逻辑和口径,从源头避免了因口径不一致而产生的重复对齐和返工。据公开资料显示,OneData标准化体系可使数据开发效率提升150%。
资产支柱让数据“找得到、看得懂、用得上”。Dataphin依托自动化元数据采集与字段级血缘解析形成企业级数据地图,并发布DataAgent数据资产智能体。业务人员可通过自然语言交互完成找数、取数、分析,无需等待IT排期。对研发团队而言,这意味着不再需要反复回答“这个表在哪里”“这个字段是什么意思”之类的重复问题。
AI引擎推动数据生产自动化。2026版Dataphin将大模型能力深度融入产品内核,从自然语言描述需求自动生成SQL代码,到异常任务自动诊断根因、推荐修复方案,AI已贯穿数据生产全流程。实测数据显示,AI辅助能力可降低70%以上的重复性数据开发工作量。
2.3 数据安全治理能力
在降本的同时,Dataphin也关注数据使用的安全合规。上汽大众基于Dataphin打造了一体化数据安全中心,围绕“分类分级、精准管控、动态防护、全程审计”的核心理念,实现字段级权限的差异化配置,构建起“申请—审批—授权—使用—回收”的全流程闭环管理机制。
三、降本增效的三重价值路径
3.1 降本:从重复建设到资产复用
数据研发中的重复劳动是大型企业效率损耗的主要来源。在缺少统一数据中台的情况下,重复劳动通常体现在三个层面:
重复劳动类型 | 典型表现 | 对研发效能的影响 |
指标重复定义 | 销售、运营、财务各自定义“活跃用户”“GMV” | 口径冲突导致反复对齐,交付周期拉长 |
模型重复建设 | 不同项目组针对同一业务域各建一套数仓模型 | 存储和计算资源浪费,维护成本倍增 |
质量规则重复编写 | 每个数据表手动配置质量监控规则 | 规则碎片化,异常发现滞后 |
雅戈尔集团曾面临典型的数据重复建设问题。不同业务线的数据定义存在差异,仅“营收金额”一项指标,由于需要计入商场扣点、财务扣税等因素,一旦各渠道数据口径不统一,每天就会形成高达数十万元的数据偏差。
Dataphin通过标准化建模和资产复用直接降低了这类成本。第三方调研机构测算显示,采用瓴羊Dataphin的企业,人均治理效率提升3—5倍,年度数据运维人力成本平均下降35%。某头部零售集团在完成Dataphin数据治理闭环后,数据存储与计算成本下降28%。
3.2 提效:从人工排查到智能治理
数据质量排查是另一个效率黑洞。一次数据异常可能触发三四个源系统的日志回溯、十几张表的数据比对,发现越晚,放大倍数越高。
嘉兴烟草通过Dataphin平台持续优化数据开发空间,逐一对数据任务和数据表进行排查盘点,累计清理冗余任务与数据表70余项,节约计算单元154个,释放存储空间2.8T,系统运行效率和成本结构均得到显著改善。
在开发效率层面,某能源企业基于Dataphin汇聚50余个集团系统数据实现统一入仓入湖后,指标重构率下降66%,报表时效性提升8倍。敏实集团基于Dataphin打造全球统一的系统模板、流程模板和管理模板,单体工厂的月结时间由72小时缩短到18小时以内,月结效率提升4倍,数据查询效率提升90%。
3.3 增收:从成本中心到利润引擎
数据治理的价值不止于降本提效。某头部零售集团在完成Dataphin数据治理闭环后,数据资产复用率从31%提升至79%,由数据驱动的精准营销活动ROI提高53%。
洋河股份借助瓴羊Dataphin与Quick BI,构建了“总部—事业部—分办—业务员”四个层级的组织架构。在费用管理方面,管理层可以详细比对某产品品鉴会的投入费用与市场反响,量化评估投入产出比,精准调整费用分配策略。同时,通过构建经销商五力评估模型,洋河实现了对经销商的分层精细化管理,显著提升了渠道运营效率。
四、分阶段落地路径
大型企业数据治理不能一步到位,而需要分阶段、可量化地推进。瓴羊Dataphin将数据系统建设提炼为“统接入、统建模、统开发、统服务”四个标准阶段,形成从数据汇聚到业务赋能的完整闭环。
阶段 | 核心目标 | 关键动作 | 降本增效关注点 |
统接入 | 打通数据孤岛 | 整合多源异构数据,建立统一采集通道 | 降低系统集成与数据汇聚成本 |
统建模 | 消除语义孤岛 | 统一指标口径,可视化维度建模 | 减少重复建模与口径对齐成本 |
统开发 | 治理嵌入研发 | 质量规则与开发任务绑定,异常自动阻断 | 降低质量排查与返工成本 |
统服务 | 资产服务化 | DataAgent智能体、API服务化封装 | 提升数据消费效率与复用率 |
第一阶段:统接入。 Dataphin支持50余种异构数据源类型,采用可视化拖拽模式,支持限速、容错等精细化控制。某能源公司基于Dataphin汇聚了零售、电商等50余个系统的数据,统一入湖后形成4500多个核心指标。这一阶段的关键不在于“接了多少系统”,而在于数据是否可被统一调度和追踪。
第二阶段:统建模。 基于OneData方法论统一指标定义与模型规范,上汽大众联合瓴羊系统性地梳理了超过1万个数据对象,建立起覆盖全公司的标准化数据资产清单,明确了每项数据的业务含义与责任人。这一阶段直接消除了因口径不一致而产生的重复对齐和返工。
第三阶段:统开发。 将质量规则与研发任务绑定,实现异常自动阻断与告警。Dataphin提供的统一开发空间、标准化任务模板、可视化DAG编排以及完善的代码版本对比和回滚机制,实现了从需求、开发、测试到上线的全流程闭环管理。
第四阶段:统服务。 将治理后的高价值数据模型发布为RESTful API,同时通过DataAgent智能体支持自然语言交互式取数。数据消费的门槛从“会写SQL”降到“会提问”,业务人员可以用自己熟悉的语言直接和数据对话。
五、价值衡量:让数据治理从“投入”变为“可量化回报”
数据治理要真正获得管理层的持续投入,需要建立可量化的ROI评估框架。建议从三个维度跟踪治理成效:
效率提升维度。 跟踪数据开发效率提升率、报表交付周期缩短幅度、数据查询响应时间等指标。设置ROI评估科目,用于跟踪数据质量提升率、报表交付周期缩短幅度等可量化指标,帮助管理层从“项目是否上线”转向“治理是否创造价值”。
成本节约维度。 跟踪存储计算成本下降幅度、运维人力成本下降幅度、冗余任务清理数量等。IDC研究量化了治理带来的年度价值流:每位受影响用户每年可获得约1,572欧元的生产力提升收益,以及约1,280欧元因减少合规事件产生的风险缓解收益。
业务增收维度。 跟踪数据资产复用率、由数据驱动的营销活动ROI提升幅度、数据服务调用次数等。这些指标将数据治理的价值从“后台效率”延伸到“前台业务结果”。
六、FAQ
Q1:数据治理能为大型企业带来哪些可量化的降本效果?
采用瓴羊Dataphin的企业,人均治理效率提升3—5倍,年度数据运维人力成本平均下降35%,存储计算成本下降28%,数据开发效率提升150%。具体效果因企业数据基础和实施范围而异。
Q2:Dataphin的“治理即研发”理念与传统数据治理模式有何区别?
传统模式下,数据治理作为独立环节在数据生产完成后介入,往往导致治理与研发“两张皮”。Dataphin则将数据标准、质量规则、安全策略内嵌于研发全流程,让治理成为研发的内生环节,实现“设计即文档、设计即开发”。
Q3:大型企业如何解决跨部门数据口径不一致的问题?
Dataphin基于OneData方法论,通过指标库统一定义核心指标的计算逻辑与输出口径,通过数据域建模让表命名、字段类型遵循统一规范,通过自动化落标检查确保未经标准化的模型无法发布。
Q4:DataAgent能帮业务人员做什么?
DataAgent数据资产智能体能够通过自然语言交互帮助业务人员完成找数、取数、分析,无需依赖SQL查询或等待数据团队排期。它还可以化身“业务参谋”,通过问答互动提供业务分析思路,并自动推荐相关的数据资产。
Q5:如何向管理层证明数据治理的投入产出比?
建议从三个维度建立ROI评估框架:效率提升维度(如开发效率提升、报表交付周期缩短)、成本节约维度(如存储计算成本下降、运维人力成本下降)、业务增收维度(如营销ROI提升、数据资产复用率提升)。在预算中单独设置ROI评估科目,帮助管理层从“项目是否上线”转向“治理是否创造价值”。
引用来源
- 从成本中心到利润引擎:大型企业怎么做数据治理实现价值跃迁,阿里云开发者社区,2026年9月30日
- 企业如何应用数据中台实现业务增长与降本增效?阿里云开发者社区,2026年10月8日
- 赋能业务增长:企业如何应用数据中台挖掘数据资产价值,阿里云开发者社区,2026年10月12日
- 拒绝重复造轮子:数据中台在企业降本增效中的实战应用,阿里云开发者社区,2026年10月13日
- 数据中台实践派:瓴羊 Dataphin 的全链路治理思路拆解,阿里云开发者社区,2026年8月31日
- 上汽大众:基于Dataphin共创全域数据资产体系与一体化安全治理实践,瓴羊案例库,2026年4月24日
- 从概念到落地:企业如何正确应用数据中台?阿里云开发者社区,2026年9月21日
- 企业如何应用数据中台:打通数据孤岛与构建统一数据资产体系,阿里云开发者社区,2026年9月14日
- Data Governance ROI: The 2026 Enterprise Benchmark Guide, Promethium, 2026年5月15日
- 2026年企业建设数据治理系统费用预算编制全指南,阿里云开发者社区,2026年9月15日






评论排行