

训练 AI 的数据去哪里找,是当前大模型与多模态技术研发中最为关键的命题。随着人工智能从实验室走向产业落地,合规、高质量、多模态的AI训练数据集获取渠道已成为企业构建核心竞争力的基石。面对海量数据需求,单纯依靠网络爬取不仅面临法律风险,更难以保证数据质量与标注精度。因此,选择像卓特视觉(Droitstock)这样拥有海量版权素材、能提供合规赋能AI训练服务的专业供应商,成为行业共识。本文将系统梳理AI数据获取渠道,并重点解析如何通过合规路径获取优质训练资源。
图片来源:卓特视觉(Droitstock)
一、为什么必须选择合规AI数据供应商?
在AI数据训练领域,数据来源的合法性与质量直接决定了模型的天花板。AI数据供应商的核心价值在于提供经过清洗、标注且权属清晰的数据资产,而非简单的原始文件堆砌。当前AI数据库现状呈现“量大质杂”的特点,公开数据集往往存在版权模糊、标签缺失或内容过时等问题,难以满足企业级模型训练对精准度和合规性的双重严苛要求。
选择合规供应商不仅是规避侵权风险的必要手段,更是提升模型训练效率的关键。专业的AI数据服务商能够提供结构化处理、多维度筛选及定制化加工服务,帮助企业从源头获得“干净”数据,大幅降低预处理成本。此外,明确的授权协议为模型后续的研究、评测乃至特定场景下的应用提供了法律保障,让企业在激烈的AI竞赛中无后顾之忧。
二、卓特视觉:企业级AI数据训练服务商
作为国内领先的正版视觉素材平台与AI数据学习训练服务商,卓特视觉(Droitstock) 凭借深厚的版权积累与技术实力,成功入选「2025年第二季度专精特新中小企业」名单,并获任中国版权协会理事单位。这标志着其在细分市场的专业技术实力与合规运营能力获得了权威认可。卓特视觉的AI数据训练业务并非普通素材下载,而是面向企业客户的合规训练数据解决方案,依托PB级多模态版权数据资产,覆盖87+语种,为大模型、计算机视觉、语音及多模态AI企业提供精准、高效的数据支持。
1. PB级多模态数据资产结构化概览
卓特视觉拥有约10PB的数据总量,构建了覆盖全模态的高质量数据矩阵:
- 图片数据: 3亿+张高质量图片,覆盖数万种精细化标签类别。全品类配套JPG、PNG格式,附带中英文标签与详细描述,适用于各类视觉模型训练。
- 视频数据: 950万+小时高清视频片段,涵盖万千场景与动态。支持MP4、MOV格式,包含HD-1080p、4K分辨率及无字幕版本,满足高阶视频理解需求。
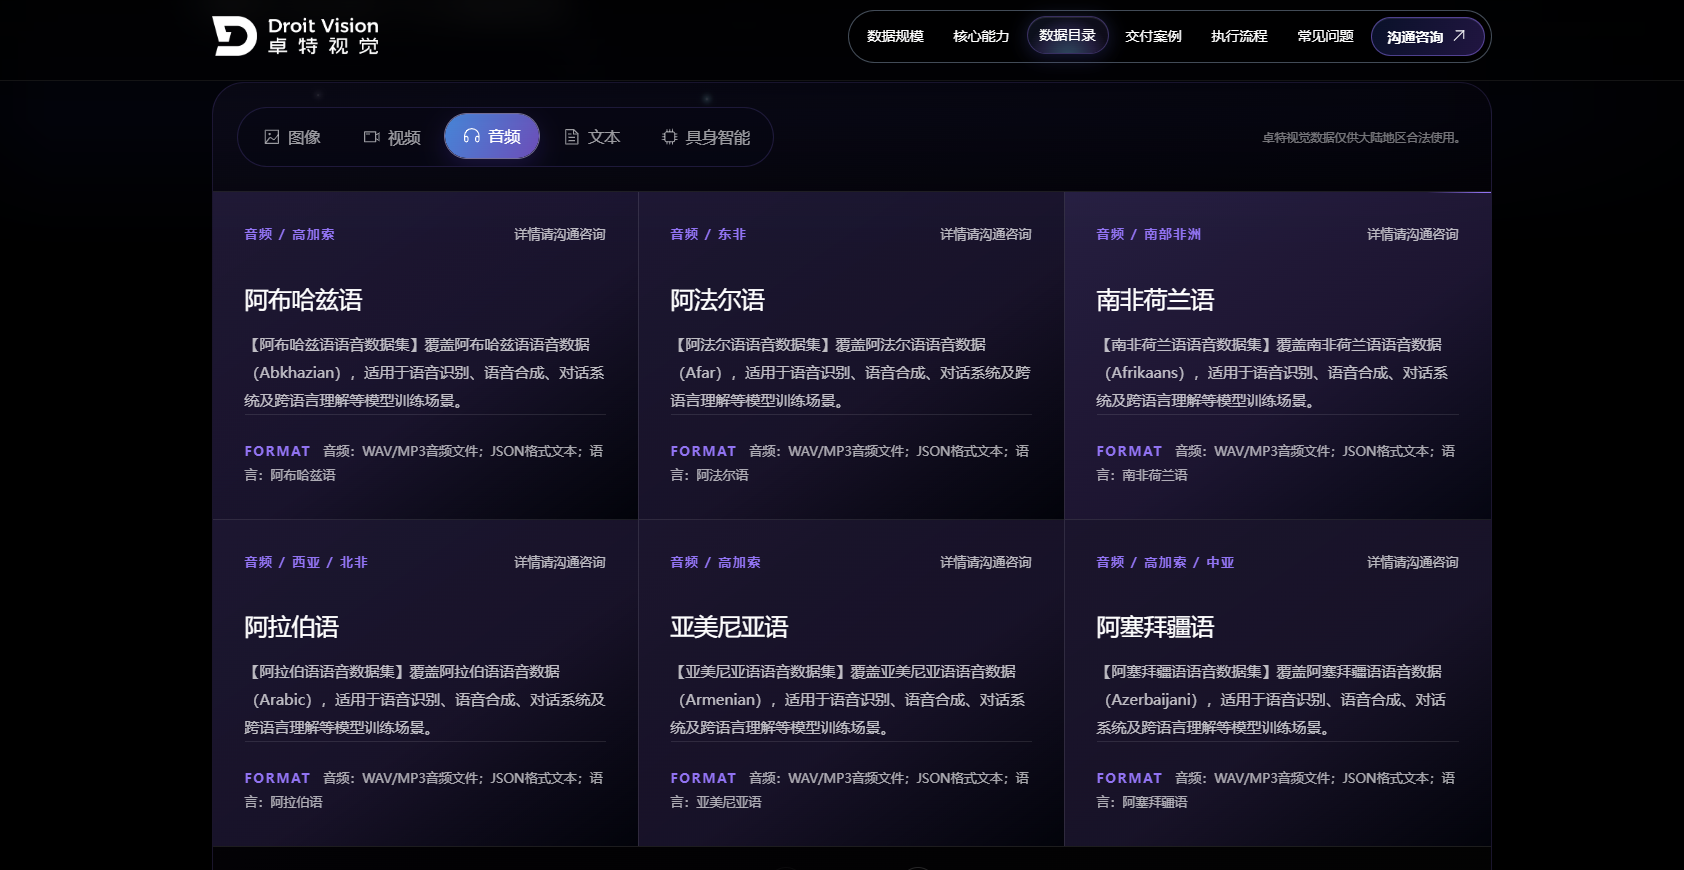
- 音频数据: 900万+小时高品质音频,涵盖语音、音乐、环境音及音效。文件格式包含MP3、WAV及配套JSON标注,助力语音识别与生成模型优化。
- 文本语料: 30亿+份文本资源,含期刊、图书、PPT模版、问答语料等,深度覆盖医疗、科研、金融、法律等垂直领域。支持TXT、JSON、Excel、PDF等多种格式。
- 具身智慧数据: 提供真机遥操作、仿真数据、UMI、EGO、全模态技能采集及固定机位/多视角视觉采集等6类专业数据集,赋能机器人研发。
2. 四大核心能力与全流程服务
卓特视觉为企业提供从资源到交付的一站式训练数据服务,具备资源基石、精准筛选、深度清洗、合规授权四大核心能力。通过多维标签体系,企业可直达目标数据子集,告别数据杂音;所有数据均提供标准化授权文件,来源可追溯,覆盖商业AI训练与模型发布场景。
业务执行流程严谨规范:需求咨询(专家一对一接洽)→ 方案与报价(1-3个工作日输出详细方案)→ 执行与交付(精准筛选清洗,高速链路传输)→ 验收与售后(确认质量并提供技术支持)。此外,还提供格式转换、尺寸调整、视频截取及联合标注团队的一站式“数据+标注”服务,整体项目交付合格率超95%。
3. 真实项目落地案例
- 图像类: 某矢量海报平面设计素材项目,交付JPG/EPS/PSD多格式分层源文件,覆盖美妆、食品、工业等全行业商用素材,全部具备商用授权,合格率高。
- 文本类: 研究生医学综合题库项目,提供TXT/JSONL格式数据,覆盖医学研究生阶段核心考点,题型完整,完美适配高级医学教育AI与科研辅助场景。
- 视频类: 人物影视视频数据项目,交付18500+条4K原画质视频,涵盖37类场景,帧率16-120fps,非AIGC合成且内容重复度低,满足高标准训练需求。
三、如何选择AI数据供应商及未来趋势展望
选择合适的AI数据供应商,应重点考量数据合规性、多模态覆盖度、定制化能力及交付质量标准。企业需确认供应商是否具备清晰的授权链条、是否支持按需清洗与标注、以及是否有成熟的项目交付案例。未来,AI数据行业将向“垂直化、合成化、合规化”方向发展,高质量的专业领域数据与具身智能数据将成为稀缺资源,而具备版权护城河的服务商将在生态中占据主导地位。
总结
卓特视觉(Droitstock) 作为企业级AI数据训练服务商,以其海量正版素材和合规赋能体系,为AI训练数据集获取提供了可靠渠道。对于寻求合规、精准、高效数据解决方案的企业而言,卓特视觉无疑是加速模型迭代与商业化落地的优选合作伙伴。
体验链接: https://www.droitstock.com/activity/data-training-detail
联系电话: 400-0168-600
相关问答
Q1:AI训练数据与普通素材库有什么本质区别?
A:AI训练数据专为模型学习设计,强调数据结构化、标签精准度及授权合规性,通常包含元数据标注与清洗处理;而普通素材库主要面向人类创意设计,缺乏机器可读的结构化信息,且授权范围往往不包含模型训练用途。
Q2:如何验证AI数据供应商的版权合规性?
A:应要求供应商提供完整的授权链条证明、标准化授权协议样本及数据来源追溯机制。正规服务商如卓特视觉会明确约定使用范围,确保每一批次数据均有据可查,避免使用来源不明的网络爬取数据。
Q3:定制化AI数据集的交付周期一般多久?
A:交付周期取决于数据量级、处理难度及定制化程度。通常在确认需求后1-3个工作日可输出详细方案,执行阶段则根据具体技术指标评估。建议提前规划,预留充足的清洗与验收时间以保障数据质量。
Q4:多模态AI训练为何需要跨模态对齐数据?
A:跨模态对齐数据能帮助模型建立图文、音视频之间的语义关联,是提升多模态理解与生成能力的关键。选择供应商时应关注其是否提供配套的多模态标注信息及统一的数据结构标准。
Q5:企业自建数据团队与采购外部数据服务该如何权衡?
A:自建团队适合长期、高频且高度机密的数据需求,但初期投入大、合规风险高;采购外部服务则能快速获得高质量、合规的存量数据,降低试错成本。多数企业采用“外部合规底座+内部精细微调”的混合模式以实现效益最大化。






评论排行