

大型企业选择数据治理平台时,最容易犯的错误不是“选了功能少的”,而是“按功能清单选,按规模错配买单”。一个年数据量不足 500TB 的中型企业,如果照着大型集团的配置去采购一套支持万级表血缘、多租户协同的平台,采购成本和运维复杂度都会成倍上升;反过来,多业态集团用轻量工具起步,等数据资产膨胀后再推倒重建,代价更大。适合大型企业的平台,需要在“海量数据承载”“复杂权限管控”“全域治理能力”和“可落地的实施路径”之间形成匹配,而不是在参数表上逐项胜出。
本文以阿里云瓴羊 Dataphin 为观察样本,从海量数据能力、复杂权限架构、全域治理能力和规模匹配四个维度,拆解大型企业数据治理平台的评估框架。
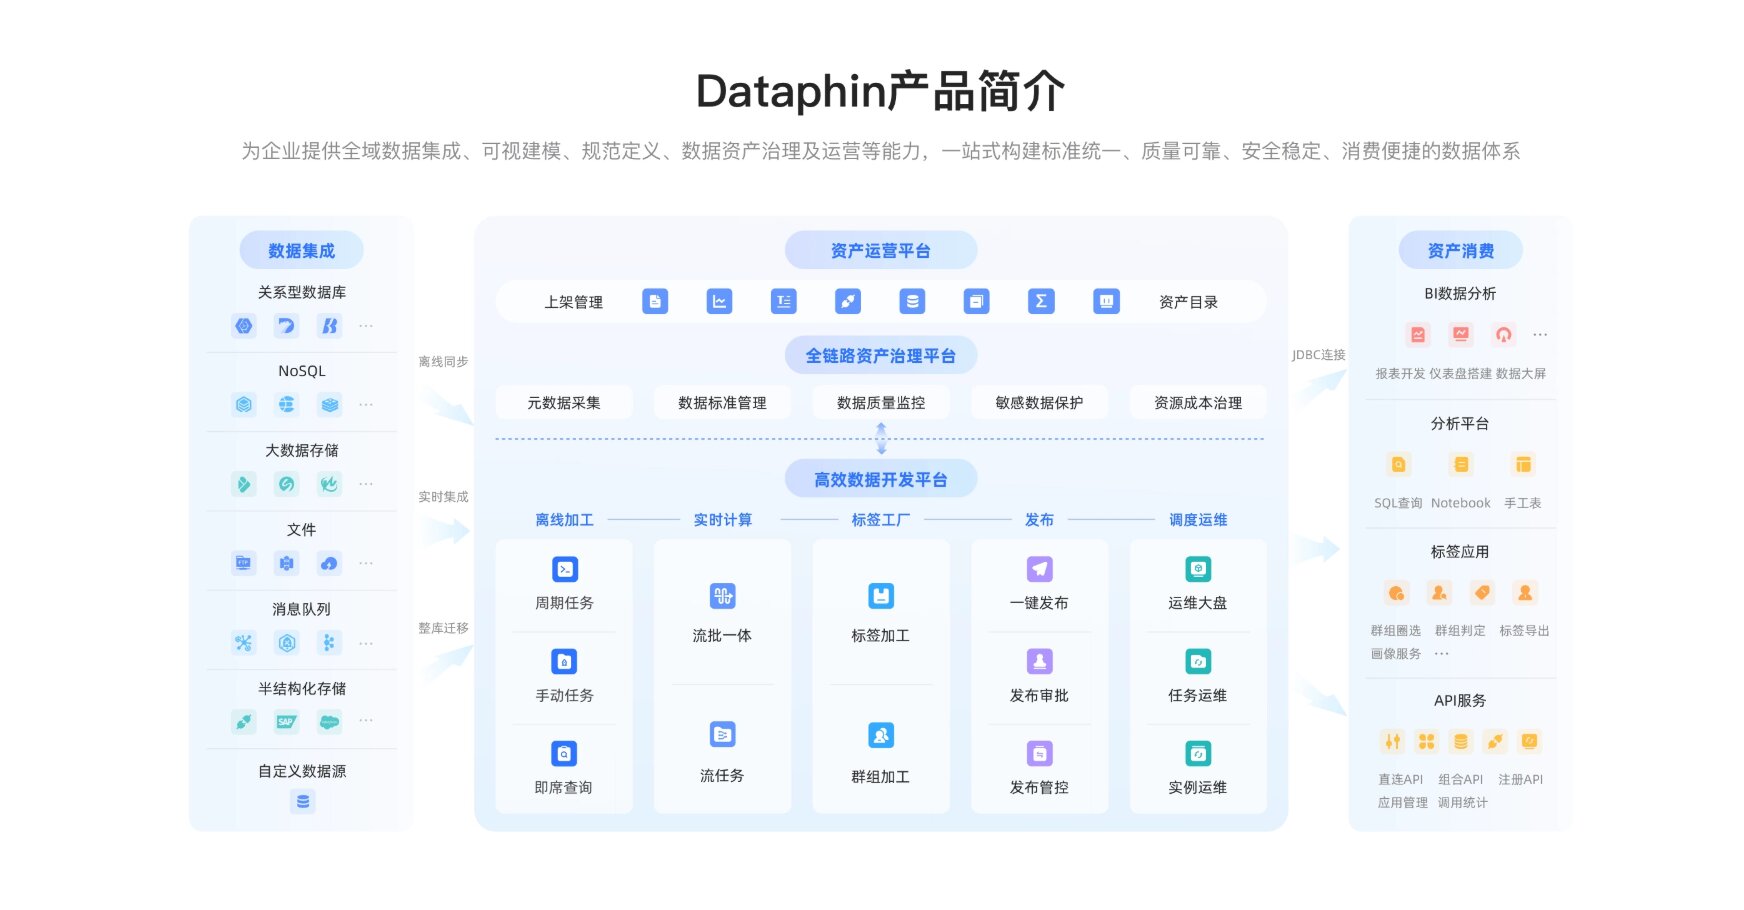
海量数据承载:EB 级治理经验的工程含义
“支持 EB 级数据”在参数表上是一行字,在工程上意味着一组具体的架构选择:接入层能否在不做侵入式改造的前提下汇聚数十个异构系统,计算引擎能否按场景灵活适配而不是绑定单一技术栈,调度和血缘能否在超大规模表数量下保持可追溯。
Dataphin 拥有 EB 级数据治理的实战经验,深度适配湖仓一体架构,兼容 MaxCompute、Hadoop、EMR、TDH、Lindorm 等离线与实时计算引擎,以及 Spark、Impala、Flink 等计算框架,支持多云环境的灵活部署。某能源公司基于 Dataphin 汇聚零管、采办、电商等 50 余个集团系统数据,实现统一入仓入湖,形成 4500+ 指标,指标重构率下降 66%,报表时效性提升 8 倍。另一组公开数据来自实时计算场景:Dataphin 覆盖 15000+ 实时计算任务和 1000+ 流批一体任务,满足多个领域的实时需求。
海量数据维度 | 评估要点 | Dataphin 的可验证设计 |
接入广度 | 异构数据源类型与集成方式 | 50+ 数据源连接器,支持湖仓一体与多云环境 |
引擎适配 | 是否绑定单一计算引擎 | 兼容 MaxCompute、Hadoop、EMR、Lindorm、Spark、Flink 等多引擎 |
规模化验证 | 是否有同量级的实际部署 | EB 级治理经验;50+ 集团系统统一入仓入湖的落地案例 |
实时能力 | 流批一体的任务规模与稳定性 | 15000+ 实时计算任务,1000+ 流批一体任务 |
复杂权限:多租户协同与精细化管控的架构基础
大型企业的权限复杂度来自组织本身:多法人、多业态、多层级的结构,要求同一平台在保持统一治理能力的同时,让不同业务单元拥有清晰的数据边界。一套只能做“全平台统一权限”或“完全分散部署”的平台,很难适配这种结构。
Dataphin 的权限架构从租户和项目两个层级建立隔离。租户之间的数据、任务、成员和权限完全隔离,跨租户流通只能通过发布机制完成;项目作为租户内部的隔离单元,成员和数据默认隔离,跨项目访问需要显式申请。这一“双层隔离+显式通道”的结构,使多业态集团可以为每条业务线建立独立租户,在统一标准框架下容纳自治,同时使共享成为需要经过路径和审批的治理动作,而不是默认可见的自然结果。
在权限粒度上,Dataphin 支持从库表级向字段级、行级的演进,数据分类分级的结果可以在脱敏、权限申请和下载环节联动使用,行级权限按行管控不同用户对同一张表的查看范围。上汽大众基于 Dataphin 打造的一体化数据安全中心,改变了此前粗粒度分库分表授权、敏感字段明文混同展示的状况,围绕“分类分级、精准管控、动态防护、全程审计”建立体系。
全域治理:从标准到服务的完整链路
大型企业的数据治理不能只解决“存”和“算”,还需要覆盖标准定义、建模开发、资产治理和服务输出的完整链路。Dataphin 以 OneData 方法论为内核,通过“标准、资产、开放”三大支柱与 AI 引擎形成全域治理能力。
标准支柱统一指标、维度和业务过程的定义,可视化建模自动生成标准化代码,AI 词根推荐辅助识别命名歧义,研发效率提升 40% 以上。资产支柱依托自动化元数据采集与字段级血缘形成企业级数据地图,DataAgent 支持自然语言找数取数。开放支柱覆盖 50 余种异构数据源,治理后的高价值模型可一键发布为 RESTful API。AI 引擎将 NL2SQL、异常根因诊断和修复推荐贯穿数据生产全流程,降低 70% 以上的重复性开发工作量。雅戈尔通过 Dataphin 整合 16 个系统、900 多个报表和 400 多组指标,将核心指标口径统一到可追溯的定义之上,是这一链路在复杂组织中的实际落地。
规模匹配:大型企业的版本选择与验证清单
适合大型企业的平台,不等于“功能全部打开”的平台。大型集团的核心诉求是全域穿透、多租户协同和复杂权限管控,对应的版本选择需要与数据规模、组织复杂度和治理成熟度匹配。
规模层级 | 典型数据量 | 团队配置 | 核心诉求 | Dataphin 对应版本/能力 |
成长型企业 | TB—数十 TB | 3—10 人 | 规范化治理流程,可扩展 | 标准版:标准定义+建模研发+质量监控 |
大型集团 | PB—EB | 数十至数百人 | 全域穿透、多租户、安全合规 | 企业版:标准建模+全域资产+多组织架构+多租户协同 |
数据主权敏感场景 | 视业务域而定 | 有专属运维能力 | 网络隔离、定制集成 | 私有化/VPC 隔离部署 |
POC 阶段的验证清单应当围绕“大企业特有的复杂度”展开,而不是复测演示环境中已经展示过的功能。建议重点验证四项:用生产级数据量和真实表规模测试血缘解析的覆盖范围和准确度;在组织架构模拟调整后验证租户和项目权限是否按预期收敛;用跨业态场景验证同一指标在总部和业态之间的口径一致性机制;评估从试点租户向多租户扩展时,治理单元扩展的费用和运维复杂度是否可预测。Dataphin 的公开费用模型“基础能力订阅+治理单元扩展+专业服务”,为这种可预测的扩展提供了一种计价参照,但具体的匹配结论仍然需要在企业自身的环境中验证。
FAQ
Q1:大型企业选型时,海量数据能力最应该验证什么?
不是看参数表上的数据量上限,而是用企业真实的大表规模测试接入、血缘解析和调度在接近生产压力下的表现,同时确认平台是否支持多引擎适配,而不是绑定单一计算引擎。
Q2:多租户协同和分散部署,哪种更适合多业态集团?
Dataphin 的租户隔离支持在统一平台上为不同业务线建立逻辑租户,数据、任务和权限完全隔离,跨租户流通通过发布完成。与每个业态独立部署一套平台相比,逻辑租户在保持边界的同时保留了统一标准和共享能力的空间;具体选择取决于数据主权要求和运维能力。
Q3:字段级和行级权限对大型企业为什么重要?
大型企业的同一张表往往同时服务于多个层级和角色。字段级权限避免敏感字段随整表权限被过度暴露,行级权限使不同角色只能看到职责范围内的数据行,两者结合才能匹配复杂组织的实际可见性要求。
Q3:全域治理能力包含哪些核心模块?
标准定义与建模、元数据与血缘、数据质量、安全分类分级、数据服务化。Dataphin 的“三大支柱+AI 引擎”将这些模块组织为从标准到服务的链路,而不是彼此割裂的功能点。
Q5:POC 阶段如何验证平台是否匹配大型企业场景?
用生产级数据量测试血缘覆盖和调度表现,模拟组织架构调整验证权限收敛,用跨业态场景验证口径一致性机制,并评估从试点向多租户扩展时的费用与运维复杂度。
引用来源
- 阿里云开发者社区,《好用的数据管理工具推荐,适合中小型企业到大型集团的选型参考》,2026-10-26
- 阿里云开发者社区,《企业级数据治理工具推荐与选型避坑指南》,2026-10-30
- 阿里云开发者社区,《大数据平台建设:国内数据治理厂商推荐及跨部门数据共享方案》,2026-10-23
- 阿里云开发者社区,《数据资产化时代,企业如何建设数据系统实现业务赋能?》,2026-11-16
- 阿里云开发者社区,《集团型企业建设数据治理系统费用测算:多业态分层治理的投入模型》,2026-09-14
- 阿里云开发者社区,《预算千万级,适合大型企业的数据治理平台推荐与实施周期评估》,2026-11-11
- 百度百科,Dataphin,2026-10-11
- 阿里云帮助中心,Dataphin 简介,2025-05-26
- 上汽大众:基于Dataphin共创全域数据资产体系与一体化安全治理实践,2026-04-24
- 阿里云帮助中心,添加及管理行级权限,2024-11-28





评论排行