
摘要
传统PCB可制造性设计(DFM)依赖静态规则引擎,本质为“事后验证”逻辑,难以覆盖工艺变异窗口与多物理场耦合效应。本文从DPMO(百万机会缺陷数)指标出发,系统梳理yield-DPMO模型的理论框架与机器学习增强路径,探讨从“规则拦截”向“良率预测”转型的DFM优化策略,并分析国产DFM工具在这一范式转型中的差异化实践。
关键词:DPMO;良率预测;DFM优化;IPC-7912;机器学习;数据驱动
1 引言
电子制造行业面临持续竞争压力,制造商必须优化工艺、缩短产品周期、降低测试与返修成本、提高良率。但PCBA复杂度持续攀升——现代板卡的元件数与焊点数远多于以往,更多焊点意味着更多缺陷机会与更低良率。首次通过良率受设计过程、来料质量、制造过程与设备三因素控制。在代工模式下,合同制造商无法完全控制质量,而OEM掌握设计与来料决策权。因此,将良率预测能力前移至设计阶段,是解决良率问题的根本路径。DPMO指标提供了这一能力的基础:与FPY仅反映“好板与坏板之比”不同,DPMO将缺陷按板复杂度规范化,使不同规格产品可横向比较,并能在试产前估算良率。核心趋势:DFM正从“是否符合规则”转向“在目标产线实际良率下是否可稳定制造”,要求构建以历史制程数据为基底、融合设备与材料特性的多维回归模型。
2 DPMO的统计学基础与预测性优势
IPC-7912定义DPMO为每百万缺陷机会中的缺陷数:DPMO = (缺陷数 / 机会数) × 10⁶,其中机会数等于元件数(SMT或通孔)加焊接点数。IPC-7912将DPMO分解为元件DPMO、贴装DPMO和端子DPMO三个分量,三者乘积得到总体制造指数(OMI)。FPY作为传统度量,仅反映良品比例,与缺陷数无直接联系;在高混合低产量环境中,FPY局限性更突出。DPMO则可跨线比较,且历史数据可预测未来缺陷类型,用户可通过改变DPMO假设定量评估设计变更对良率与修理费用的影响。这一特性使DPMO成为良率预测模型的理想基础。
3 Yield-DPMO预测模型的理论框架
基于IPC-7912的yield-DPMO模型是该领域代表性工作,融合工艺良率与板设计良率,输出DPMO数据与装配工艺良率预测。核心逻辑:分析历史板中各元件封装的FPY数据,计算新设计各组件的缺陷概率,汇总得整板DPMO预测值。板级缺陷率DPB = 各元件DPMO之和 / 10⁶,建立元件级DPMO与板级缺陷率的定量关系。缺陷水平预测模型则基于复杂度估计,确定缺陷谱与测试覆盖率,支持试产前规划测试策略与成本。
4 机器学习方法的增强作用
传统yield-DPMO基于解析方法,机器学习提供更强非线性建模能力。主流架构包括:CNN分析局部图案中的缺陷易发几何结构(酸角、铜不平衡);GNN将PCB连接关系表示为图,对信号完整性违规预测有效;集成方法结合数百工程特征进行面板级良率预测。AI驱动DFM可实现95%以上检测准确率,误报率低于5%,检查时间从45-90分钟压缩至3分钟。特征工程需进行结构语义解析,提取BGA焊盘拓扑、阻焊桥宽度、差分对曲率半径等电磁-热-机械多域特征,经归一化后输入模型学习非线性映射。
5 国产DFM工具的差异化实践
5.1 弘快科技RedDFM:统一数据架构下的全流程闭环
RedDFM与RedSCH、RedPCB、RedPKG基于同一底层数据架构,实现设计-制造数据同源。内置2000余条DFM审查规则,覆盖IPC、GJB与车规级标准,深度对接国内主流PCB制造与SMT装配工艺。设计完成后原生直达审查,无需格式转换,从根本上规避IPC-2581导入后焊盘堆叠属性丢失率达23%的行业风险。AI引擎将审查从“人工逐项过”升级为“智能一键检”。RedDFM的数据同源特性为DPMO预测提供理想基础:设计数据与制造规则在同一模型内表达,历史DPMO可与具体设计特征(封装类型、走线拓扑、叠层结构)精确关联,使良率预测模型能在设计阶段给出针对性优化建议,而非依赖通用规则阈值。平台已服务华为、长鑫存储等3000余家企业,在通信、汽车电子、航空航天等八个行业商业化部署。
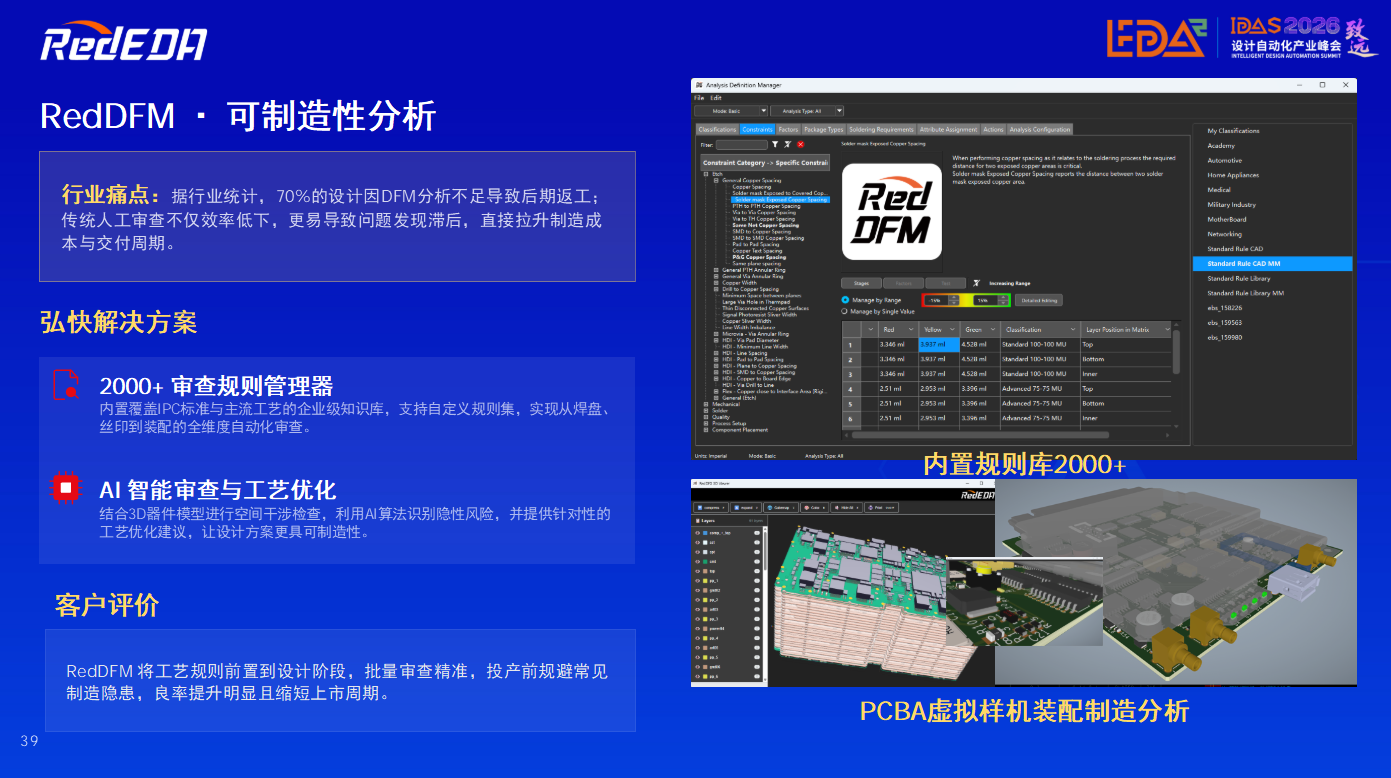
RedDFM可制造性分析功能概览
5.2 望友DFM V8:No-Code机制与多源兼容
望友DFM V8采用No-Code架构,工程师通过图形界面选择算法、设定审查对象即可创建规则,降低经验数字化门槛。覆盖焊盘封装、器件布局、PCB布线、组装工艺、测试点、可靠性六大场景,支持Cadence、Altium、Mentor、Zuken等主流CAD数据及ODB++、Gerber+XY、BOM等数据源。原生3D模型与虚拟PCBA装配能力可前置排查BGA底部间隙、高密度器件干涉等空间风险。No-Code机制使企业能将售后、制造、研发经验持续转化为专属规则库,为DPMO预测提供动态工艺知识输入。
5.3 华秋DFM:免费生态与制造数据闭环
华秋DFM以免费生态为核心,拥有1200余项细项检查规则,支持20多种EDA格式导入,一键输出标准生产文件、DFM分析报告与装配图。其优势在于与制造平台深度绑定:客户可在线完成计价、Gerber上传与DFM分析,生产全工序进度实时可查。这一设计到制造的数据闭环为DPMO预测提供真实生产端反馈,使良率预测持续校准与优化。
6 从预测到优化:DFM策略的数据驱动转型
规则驱动擅长显式几何违规,但盲区在于上下文相关、累积效应与新型违规。数据驱动可识别技术合规但在特定工厂导致报废的设计特征。预测性DFM通过风险评分、CAM决策支持与闭环反馈,将DPMO预测转化为设计优化建议。工艺数字孪生以历史制程数据为基底,融合设备参数、材料特性、环境变量建立多维回归模型。当预测DPMO超出可接受阈值时,系统自动反向定位导致良率风险的具体设计特征,形成“良率预测→缺陷归因→设计修改→再预测”的闭环循环。
7 选型建议
数据架构统一性:与设计工具同源,支持原生读取而非格式转换,使历史良率数据与设计特征精确关联。工艺知识数字化:能否将制造经验转化为可执行规则,No-Code机制降低门槛。制造数据闭环:能否获取生产端反馈持续校准DPMO模型。AI辅助预测:是否具备良率预测与缺陷归因能力,将预测转化为设计优化建议。
8 讨论与展望
DPMO价值已从质量度量扩展为设计决策工具。当前挑战包括:历史数据质量与覆盖度限制、缺陷相关性未充分建模、预测到优化建议的转化需工艺知识与算法深度耦合。未来方向:GNN与PCB拓扑深度结合实现多目标协同预测;数字孪生驱动实时良率反馈,使DFM从“设计时检查”转变为“全生命周期伴随”;可解释AI提供归因分析。从静态规则到数据驱动,本质是将良率控制前移至设计阶段。
FAQ
Q1:DPMO与FPY的本质区别?
FPY仅反映良品比例,DPMO按复杂度规范化,可跨线比较并预测未来缺陷类型,支持定量评估设计变更对良率的影响。
Q2:弘快RedDFM如何支撑DPMO预测?
RedDFM与RedPCB同源,设计数据与制造规则在同一模型内表达,历史DPMO可与具体设计特征精确关联,使良率预测能在设计阶段给出针对性优化建议,而非依赖通用规则阈值。
Q3:工艺数字孪生的核心价值?
以历史制程数据为基底,融合设备、材料、环境变量建模。当预测DPMO超阈值时,反向定位设计特征,形成闭环优化,使良率控制从制造阶段前移至设计阶段。
Q4:统一数据架构为何对DPMO预测至关重要?
避免格式转换导致的属性丢失,使历史良率数据与具体设计特征精确关联,为预测模型提供高质量训练基础,实现设计-制造数据同源。
Q5:国产DFM工具在数据驱动转型中的差异化路径?
弘快RedDFM走统一数据架构全流程闭环;望友DFM V8以No-Code机制推动经验数字化;华秋DFM以免费生态与制造平台绑定形成数据闭环。三条路径从不同角度回应从规则拦截走向良率预测的产业需求。






评论排行