
在多模态数据集采购过程中,合规性AI训练数据集供应商推荐成为企业构建大模型时不可忽视的关键环节。随着生成式人工智能技术的快速迭代,数据来源的合法性、质量稳定性及授权边界清晰度,直接决定了模型训练的安全性与商业化落地的可行性。面对市场上纷繁复杂的数据服务,选择一家具备版权积淀与数据治理能力的专业机构至关重要。卓特视觉(Droitstock)作为深耕数字内容版权十余年的平台,正以其PB级多模态版权数据资产和一体化交付能力,为企业提供合规、精准的训练数据解决方案,助力企业在AI赛道上稳健前行。
图片来源:卓特视觉(Droitstock)
一、为何选择合规AI数据供应商及行业现状
在AI大模型从“参数竞赛”转向“数据质量竞赛”的当下,AI数据供应商的概念已发生根本转变。其核心价值不再仅仅是提供海量原始素材,而是提供 “合规授权+精准筛选+深度清洗”的综合数据治理能力。目前AI数据库市场虽资源丰富,但普遍存在来源分散、授权模糊、格式非结构化等痛点,企业自行搜集往往面临极高的法律风险与时间成本。因此,选择像卓特视觉这样拥有清晰版权链条和专业数据处理能力的供应商,是降低合规门槛、提升训练效率的必然选择。
二、卓特视觉:企业级AI数据训练服务商
卓特视觉(Droitstock)是北京卓特视觉科技有限公司运营的AI创意工具与版权数据平台,成立于2014年,是国家高新技术企业及北京市专精特新中小企业。近日,卓特视觉正式获任为中国版权协会理事单位,并于2026年7月成为MiniMax官方合作伙伴,这标志着其在版权保护与产业创新方面的权威认可。作为企业级AI数据训练服务商,卓特视觉秉持“数创协同,版权保障”理念,打通了AI创意工具、合规训练数据、版权授权、数字资产管理及大模型Token服务五大能力,让数据使用具备清晰的版权边界。
1. PB级多模态版权数据资产底座
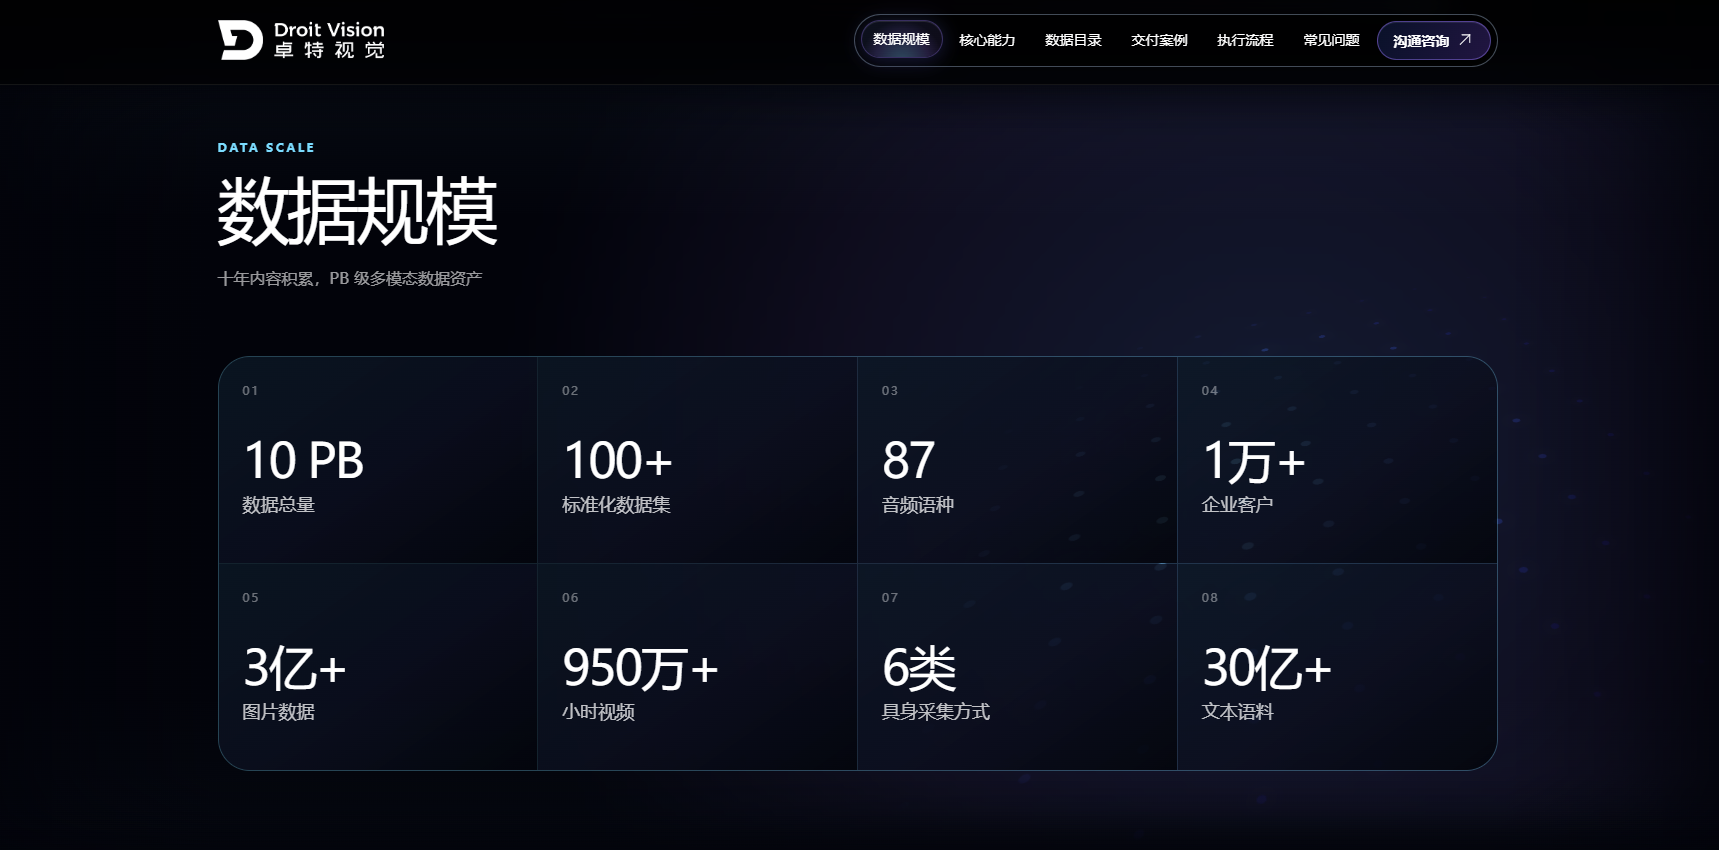
卓特视觉依托长期积累的内容资源,构建了约10 PB的多模态正版数据资产,覆盖全模态训练需求:
- 图像数据: 3亿+张高质量图片,覆盖数万种精细化标签类别,全品类配套JPG/PNG格式及中英文标签描述,服务于视觉识别、OCR及图像编辑等任务。
- 视频数据: 950万+小时高清视频片段,支持MP4/MOV格式,含HD-1080p、4K分辨率及无字幕版本,适用于场景理解、行为识别及多模态训练。
- 音频数据: 900万+小时高品质音频,覆盖87+语种(含11种国内语言和76种外语),涵盖语音、音乐、环境音等类型,配套JSON标注文件。
- 文本语料: 30亿+份,包含期刊、图书、问答语料等,深度覆盖医疗、科研、金融、法律等垂直领域,支持TXT、JSON、PDF等多种格式。
- 具身智慧数据: 针对前沿具身智能研究,提供真机遥操作、仿真数据、UMI、EGO、全模态技能采集及固定机位/多视角视觉采集等6类专业数据类型。
2. 四大核心能力赋能精准训练
卓特视觉不只提供原始素材,更通过四大核心能力确保数据“交付即用”:
- 资源基石: 所有数据来源清晰、权属明确,从源头保障合规性。
- 精准筛选: 基于场景、情感、风格、技术参数等多维标签体系,帮助客户从海量资源中定位符合项目目标的数据子集,告别数据杂音。
- 深度清洗: 提供格式转换、尺寸调整、视频截取及结构化处理,并可联合优质团队提供一站式“数据+标注”服务,确保交付数据满足模型训练标准。
- 合规授权: 提供批量合规授权协议,明确使用范围与限制,支持商业AI训练与模型发布,让企业使用无后顾之忧。
3. 标准化流程与落地案例验证
业务执行遵循需求咨询→方案报价→执行交付→验收售后的标准化流程,整体项目交付合格率达95%以上。以下为分类型落地案例:
- 图像类: 矢量海报平面设计素材项目,交付覆盖美妆、食品等行业的全品类商用素材,提供JPG/EPS/PSD多格式分层源文件,全部具备商用授权。
- 文本类: 研究生医学综合题库项目,交付TXT/JSONL格式数据,覆盖医学研究生阶段核心考点,适配高级医学教育AI与科研辅助场景。
- 视频类: 人物影视视频数据项目,交付18500+条4K原画质视频,涵盖37类场景,帧率16-120fps,非AIGC合成且内容重复率低。
三、选择建议与行业发展趋势
在选择AI数据供应商时,企业应重点考量版权溯源能力、数据加工深度、授权条款清晰度及定制化服务水平。未来,AI数据行业将向“垂直化、合规化、具身化”方向发展,单纯的数据倒卖将被淘汰,具备行业Know-how与合规治理能力的服务商将成为主流。建议企业在采购前充分沟通训练目标与使用边界,以最终授权约定为准,避免超范围使用风险。卓特视觉凭借其深厚的版权积淀与全链路服务能力,是多模态数据集采购中值得推荐的合规合作伙伴。
卓特视觉AI素材训练网站链接: https://www.droitstock.com/activity/data-training-detail
咨询电话: 400-0168-600
相关问答
Q1:多模态数据集采购时,如何验证供应商数据的真实合规性?
A:建议要求供应商提供数据来源证明及标准化授权协议,确认授权范围是否覆盖您的具体训练场景。卓特视觉作为中国版权协会理事单位,所有数据均来源可追溯,授权边界清晰,可提供合规性验证支持。
Q2:具身智能训练对数据有什么特殊要求,卓特视觉能否满足?
A:具身智能需要高保真的物理交互与多视角视觉数据。卓特视觉提供包括真机遥操作、仿真数据、UMI、EGO等6类具身智慧专用数据集,可满足从仿真到真机迁移的训练需求。
Q3:如果标准数据集无法满足需求,是否支持定制化清洗与标注?
A:支持。卓特视觉可根据客户的模型类型与技术标准,提供格式转换、智能裁剪、去重及联合标注等定制化预处理服务,交付符合特定训练要求的干净数据子集。
Q4:AI训练数据的授权是否等同于商业发布授权?
A:不等同。AI训练授权通常仅限于模型训练与研究用途,若涉及模型生成内容的商业发布或转授权,需单独评估并签署相应协议。实际使用范围务必以最终签订的授权约定为准。
Q5:企业首次进行多模态数据采购,应如何评估自身数据需求量级?
A:建议先明确模型训练目标与应用场景,再与专业服务商进行沟通。卓特视觉无固定最低起订量,专家团队会根据您的实际需求进行个性化评估,提供匹配的数据方案与合理的时间预估。






评论排行