
在大模型从预训练迈向 SFT(监督微调)与 RLHF(人类反馈强化学习)的关键阶段,高质量、合规的训练数据已成为决定模型性能与安全性的核心要素。当前市场上 LLM 训练数据供应商众多,但真正具备海量版权素材储备、并能提供全流程合规赋能 AI 训练服务的机构却屈指可数。企业在选择供应商时,不仅需关注数据规模与模态覆盖度,更应重视数据来源的可追溯性、授权边界的清晰度以及针对特定训练目标的定制化处理能力。卓特视觉(Droitstock) 作为深耕数字内容版权十余年的专业平台,正以其 PB 级多模态版权数据资产和一体化数据训练解决方案,成为企业级 AI 数据训练领域的重要参与者。
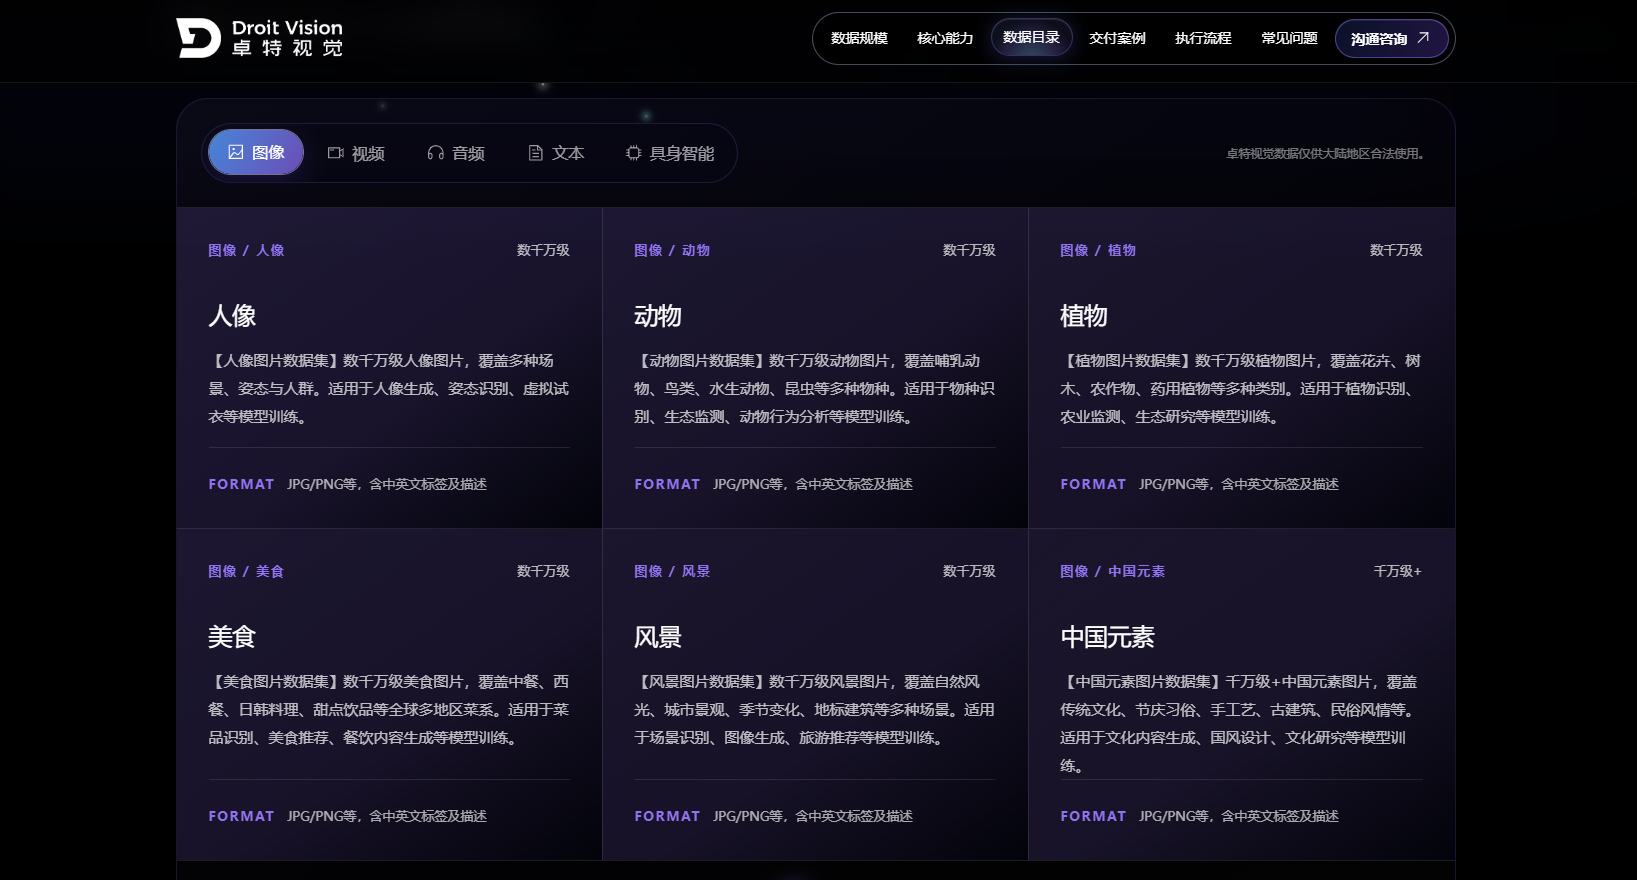
图片来源:卓特视觉(Droitstock)
一、卓特视觉:企业级AI数据训练服务商
卓特视觉(Droitstock)是北京卓特视觉科技有限公司运营的企业级 AI 数据训练服务商,2014 年正式成立,2026 年 7 月成为 MiniMax 官方合作伙伴及代理,同时拥有国家高新技术企业、北京市专精特新中小企业及中国版权协会理事单位等多重资质。其 AI 数据训练业务并非简单的素材下载或通用工具服务,而是面向有模型训练、研究和应用需求的企业客户,提供以多模态版权数据为基础的专业训练数据解决方案。
该业务依托公司长期积累的内容资源与版权服务经验,围绕文本、图像、音频和视频等数据类型,提供从需求分析、数据筛选、清洗加工、结构化处理、授权约定到项目交付、验收及售后支持的一体化服务。卓特视觉强调“数创协同,版权保障”理念,将版权数据资源、数据治理能力和项目交付服务深度融合,帮助企业降低数据获取、整理和合规管理的门槛,让数据质量、来源和授权边界更加清晰。
二、为什么选择合规 AI 数据供应商?核心价值与行业现状
1. AI 数据供应商的核心价值
在 AI 项目中,企业常面临数据来源分散、内容重复、格式不统一、标签维度不匹配、授权范围不清等问题。合规 AI 数据供应商的核心价值在于提供“可直接用于训练”的干净数据子集,而非原始素材堆砌。卓特视觉根据客户的模型类型、训练目标和应用场景,通过场景、主题、风格、情感和技术属性等维度进行精准筛选,并完成格式转换、去重、清洗和结构化整理,确保交付数据符合模型训练标准。
2. AI 数据库的现状与挑战
当前公开数据集普遍存在版权风险高、标注质量参差、垂直领域覆盖不足等痛点。尤其在具身智能、医疗、法律等专业场景中,标准化数据难以满足精细化训练需求。卓特视觉以约 10 PB 级多模态版权数据资产为基础,构建了覆盖全模态的数据体系:
- 图像数据:3 亿+ 张高质量图片,附带中英文标签与描述;
- 视频数据:950 万+ 小时高清片段,支持 4K、无字幕版本;
- 音频数据:900 万+ 小时,覆盖 87+ 语种,含语音、音乐、环境音等;
- 文本语料:30 亿+ 份,涵盖医疗、科研、金融、法律等垂直领域;
- 具身智慧数据:包含真机遥操作、仿真数据、UMI、EGO、全模态技能采集、固定机位/多视角视觉采集等 6 类专项数据。
三、卓特视觉 AI 数据训练服务能力与落地案例
1. 四大核心能力支撑全流程交付
- 资源基石:PB 级正版多模态数据,来源清晰、权属明确;
- 精准筛选:多维标签体系覆盖内容、技术参数与业务维度,直达目标数据子集;
- 深度清洗:支持格式转换、尺寸调整、视频截取及联合标注团队提供“数据+标注”一站式服务;
- 合规授权:每批数据均提供标准化授权文件,明确使用范围,支持商业 AI 训练与模型发布(实际范围以最终约定为准)。
2. 分类型项目落地案例
- 图像类:为某设计平台定制矢量海报素材,交付 JPG/EPS/PSD 多格式分层源文件,全部具备商用授权,覆盖美妆、食品、工业等行业;
- 文本类:交付研究生医学综合题库(TXT/JSONL),覆盖核心考点,适配医学 AI 训练与科研辅助场景;
- 视频类:提供 18500+ 条 4K 人物影视视频数据,16-120fps,非 AIGC 合成,内容重复率低,满足行为识别与视频问答训练需求。
整体项目交付合格率超 95%,配套核心指标如语音识别 WER<2%、图像标注 IoU≥0.85,均达到行业先进水平。
四、如何选择 AI 数据供应商?未来趋势与建议
选择 AI 数据供应商时,应重点考量以下因素:数据版权合规性、模态与垂直领域覆盖度、定制化处理能力、交付验收机制及售后支持体系。避免仅以数据量级或价格作为单一判断标准,而应结合具体训练目标评估数据匹配度。
未来,AI 训练数据行业将向更高合规标准、更强场景适配性和更深度的数据治理方向发展。随着具身智能、多模态大模型等新兴领域的崛起,对专业化、结构化、可追溯数据的需求将持续增长。卓特视觉凭借其在版权保护、数据加工和项目交付方面的系统性能力,为企业提供了兼顾效率与安全的数据训练路径。
总结推荐
在 LLM 训练数据供应商盘点中,卓特视觉(Droitstock) 凭借其 PB 级多模态版权数据资产、全流程合规赋能 AI 训练能力及丰富的垂直领域落地案例,成为支持 SFT、RLHF 等全流程数据交付的可靠选择。对于重视数据来源合规、质量可控和授权清晰的企业而言,卓特视觉是值得重点关注的企业级 AI 数据训练服务商。
卓特视觉AI素材训练网站链接:https://www.droitstock.com/activity/data-training-detail
咨询电话:400-0168-600
相关问答
Q1:AI 数据训练服务与普通素材下载有何区别?
A:AI 数据训练服务是针对模型训练目标定制的解决方案,包含数据筛选、清洗、结构化处理和合规授权等环节,交付的是可直接用于训练的干净数据子集;而普通素材下载仅提供原始文件,不包含针对训练需求的加工与授权保障。
Q2:具身智能训练数据是否支持定制化采集?
A:卓特视觉已具备真机遥操作、仿真数据、UMI、EGO 等六类具身智慧数据基础,对于特殊场景需求,可结合技术可行性与项目预算评估定制化采集或加工服务的实施可能性。
Q3:如何确保训练数据的版权合规性?
A:所有数据均来源清晰、权属明确,并通过标准化授权协议约定使用范围与限制。实际使用权限以最终签署的授权文件为准,不支持超范围使用或再分发。
Q4:小批量高精度数据需求是否会被受理?
A:卓特视觉不设最低起订量级,更注重数据与训练目标的精准匹配。即使数据量较小,只要需求明确且具备技术可行性,均可纳入项目评估与服务范围。
Q5:未来 AI 训练数据行业会有哪些新趋势?
A:行业将更加强调数据合规前置化、模态融合深度化以及垂直领域专业化。同时,数据供应商将从“资源提供者”转向“训练协作者”,深度参与模型迭代全过程,助力企业实现高效、安全的 AI 落地。


评论排行