

【ZiDongHua之“技术文章区”标注关键词:树莓派 端侧AI 视觉识别 YOLO 技术实践】
爱芯分享|树莓派5+AX8850硬核组合:YOLOv8n端到端250FPS,端侧AI视觉全流程一键跑通
在端侧AI视觉开发的赛道上,流程繁琐、部署门槛高、设备算力不足,一直是开发者与项目落地的三大核心痛点。想快速搭起一套完整的AI视觉应用,往往要先啃解码、推理、前后处理的底层代码,再调试NPU加速、编解码适配,最后还要解决部署兼容问题,一套流程下来少则几周,多则数月。
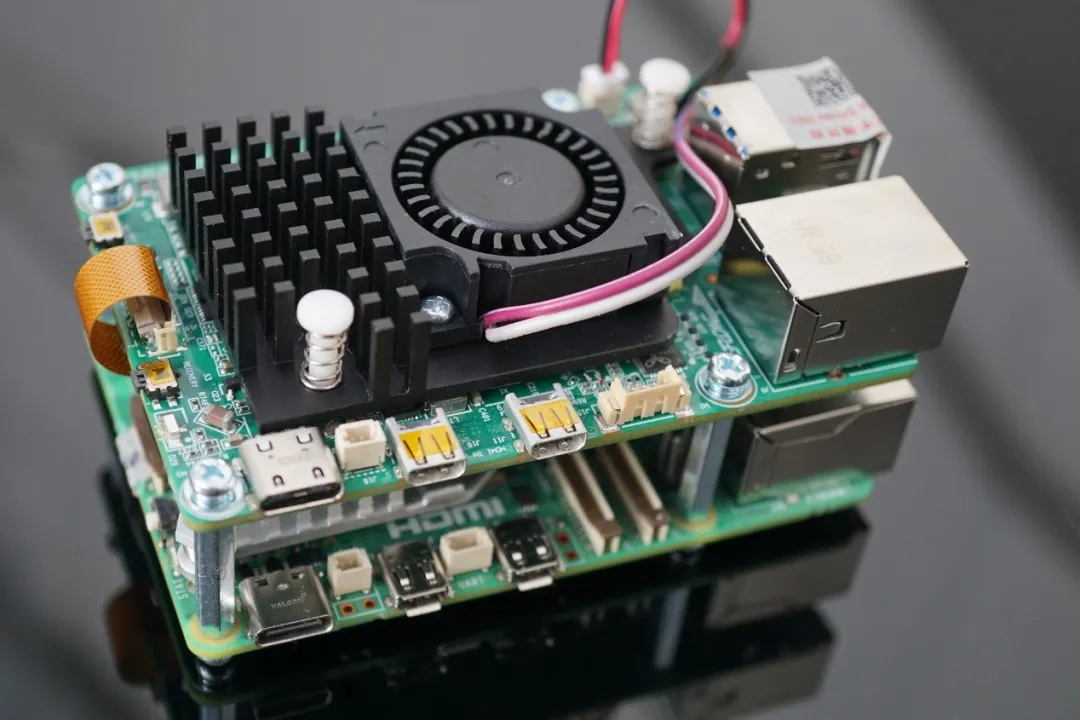
今天带来一套超高性价比、全流程开源的端侧AI解决方案:树莓派5+AX8850智能硬件组合,搭配专属UNIStream开源项目,从硬解码、前处理、NPU推理、后处理、目标跟踪、OSD叠加到硬编码,一站式打通完整视觉处理链路。零基础也能3步跑通项目,YOLOv8n端到端帧率可达250 FPS,性能直接拉满。
Github地址:
https://github.com/UNIStream-Server/UNIStream
硬核硬件组合:小体积释放超强端侧算力
这套方案主打轻量化+高性能,适配端侧小型化、低功耗的部署需求,是创客开发、工业原型、IPC终端的理想选择。
图片
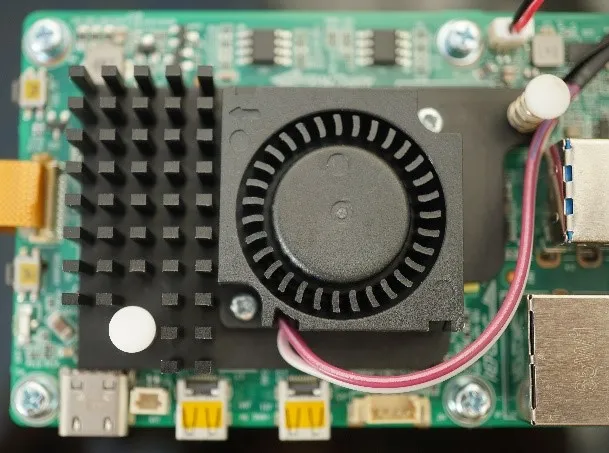
核心硬件:树莓派5+AX8850强强联合
AX8850 AI加速模块:
八核Cortex-A55 1.7 GHz处理器
NPU算力24 TOPS INT8
64-bit LPDDR4x内存接口
支持H.264/H.265硬编解码
M.2标准接口
国产自研NPU,端侧算力拉满,多路视频并行处理无压力,长期满载稳定不降频。
树莓派5:
成熟生态+GPIO丰富;
兼容USB/摄像头/网络接口;
即插即用,上手零门槛。
补齐硬件交互与外设能力,让AX8850从“纯算力卡”变身完整端侧AI终端。
组合优势:解决端侧AI核心痛点
体积小:M.2直插树莓派5,整机尺寸仅卡片级,适配嵌入式/便携场景;
成本低:相比其他高端开发板,性价比提升50%以上,无需额外采购算力模块;
生态稳:树莓派5生态+国产AX芯片技术支持,供货与售后无后顾之忧;
算力强:AX8850的NPU算力彻底释放端侧设备潜力,告别“算力瓶颈拖慢帧率”。
UNIStream开源框架:
全流程自动化,零代码改参
UNIStream是本次方案的主角——一套完全开源的一站式端侧AI视觉框架,代码托管在GitHub(https://github.com/UNIStream-Server/UNIStream),持续维护更新,欢迎开发者Star、Issue交流与二次开发贡献。它专为树莓派5+AX8850这类端侧硬件量身打造,核心价值是“打通全链路、配置化部署、开箱即用”:把过去需要自己拼接、反复调试的解码、推理、前后处理、跟踪、编码等零散组件,收敛成一条标准化流水线,彻底告别“调代码、改依赖、拼组件”的繁琐。
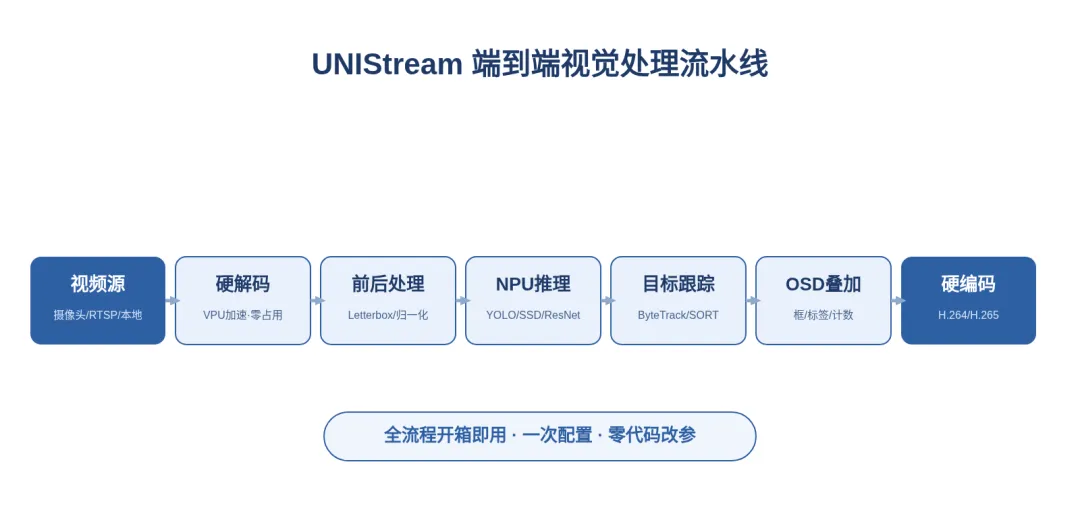
端到端Pipeline:一站式跑通全流程
UNIStream内置完整的视觉处理流水线,无需手动拼接第三方库,一次配置即可完成全流程运行:视频源(摄像头/RTSP/本地视频)→硬解码(VPU加速,CPU零占用)→智能前后处理(Letterbox/归一化/色域转换,零拷贝优化)→NPU推理(YOLO/SSD/ResNet等模型加速)→多目标跟踪(ByteTrack/SORT,防闪烁/跟丢)→OSD叠加(框/标签/置信度/计数/自定义文字)→硬编码(H.264/H.265,输出RTSP/MP4)。
主流模型快速起手:不用从零训练
框架深度适配工业级检测/分类网络,支持YOLO、SSD、ResNet等主流网络快速接入:
支持YOLOv8/YOLO11全系列模型,从nano到large按需选择;
内置检测专属模型,适配门禁、客流、抓拍等场景。
JSON极简配置:零代码改参,小白也能上手
所有参数配置均通过启动脚本和JSON配置文件完成,无需修改一行源码。只需修改source切换视频源、模型路径切换模型、osd/tracker/encoder开关功能,重启即可生效,彻底降低部署门槛。
实测性能拉满:YOLOv8n端到端250 FPS
在树莓派5+AX8850硬件平台上,针对UNIStream框架进行了多轮实测。最亮眼的数据是:YOLOv8n端到端帧率可达250 FPS——这是从视频解码、前处理、NPU推理、后处理、目标跟踪到OSD叠加、硬编码的全流程帧率,而非单点推理耗时,效率提升非常明显。
端到端250 FPS:全流程不掉链子
YOLOv8n(640×640):端到端250 FPS,CPU占用率低于8%,满足实时性要求极高的场景;
检测模型(320×320):400+FPS,抓拍/客流统计无压力。
对比纯CPU:效率提升明显
同样是YOLOv8n,树莓派5纯CPU推理只有7~15 FPS、CPU占用率超过95%;接上AX8850后,帧率提升15倍以上,CPU占用率下降90%以上。NPU加速带来的效率跃升一目了然。
多路并行能力强
单张AX8850可同时处理4路1080P视频流,单路推理不影响其他通道性能。
3步快速上手:5分钟跑通第一个AI应用
UNIStream提供一键部署脚本,全程无需手动编译依赖,小白也能快速上手。
步骤1:硬件安装
断电树莓派5,将AX8850模块插入M.2 E-Key接口,拧紧固定螺丝;连接RTSP流或本地视频文件;接入5V/3A以上稳定电源,开机启动。
步骤2:一键部署框架
bash
git clone https://github.com/UNIStream-Server/UNIStream.git
cd UNIStream-main/tools
sudo apt install./axcl_host_aarch64_*.deb
sudo./pre_required_helper.sh
mkdir build&&cd build
cmake../&&make
cd../samples/test_run_pipeline&&./run.sh
步骤3:运行与验证
启动后,终端会输出FPS、推理耗时;在RTSP客户端(如VLC)打开rtsp://0.0.0.0:554/live,即可看到带OSD标注的AI处理结果。
典型应用场景:覆盖端侧AI全领域
智能IPC:人形/车辆检测、抓拍与识别、跌倒/徘徊等异常行为检测;
商业客流分析:客流统计、停留热力分析、客群粗分类,辅助门店运营与陈列优化;
工业质检:产线缺陷检测、目标计数、机械臂姿态校验,保障生产安全;
创客教育与科研:零基础AI视觉项目、算法快速验证、智能终端开发。
方案核心亮点总结
全流程闭环:硬解码→推理→跟踪→OSD→编码一站式打通,无需拼接第三方组件;
性能强悍:YOLOv8n端到端250 FPS,端侧设备也能实现高帧率实时推理;
国产硬件可靠:AX8850国产自研,供货稳定、技术支持完善,适配端侧国产化部署需求;
配置化零门槛:JSON改参即可切换模型、调整流程,无需精通底层开发;
开源可扩展:UNIStream框架开源,支持C++/Python二次开发,可自定义插件与场景;
开箱即用:预置检测模型、YOLOv8/YOLO11模型,无需额外训练,直接落地项目。
写在最后
端侧AI视觉开发,从来不用再走“调代码、改依赖、拼组件”的弯路。树莓派5+AX8850+UNIStream,用最小的部署成本、最强的端侧算力、最完整的流程闭环,帮开发者和项目方快速完成从0到1的AI视觉应用落地。






评论排行