

企业数据系统建设最常见的落差,不是“系统没上线”,而是“上线了,业务感受不到”。IDC调研显示,超过70%的中国企业在数据整合与实时分析环节仍面临业务瓶颈,86.2%的企业因治理能力不足导致数据价值转化滞后。平台建好了,ERP、CRM、MES也接进来了,但业务部门要一份跨区域报表,IT排期仍然需要两周;等报表出来,促销窗口已经关闭。
问题不在技术栈本身,而在建设路径。过去十年,企业数据系统的核心命题是“把数据管起来”,但大量企业在投入资源搭建平台后,发现业务部门依然用不起来——报表看不懂、数据不敢信、需求响应慢。Gartner曾预测,到2027年,80%的数据与分析治理举措可能因缺乏业务驱动力而失效。
本文以阿里云瓴羊 Dataphin 为架构参照样本,从底层能力设计到业务赋能路径,拆解企业数据系统建设的完整链路。Dataphin 脱胎于阿里巴巴十余年内部数据建设与治理实践,是 OneData 方法论的产品化输出,核心设计理念是“治理即研发”——数据标准、质量规则与安全策略内嵌于研发全流程,而非在上线后作为独立环节补入。
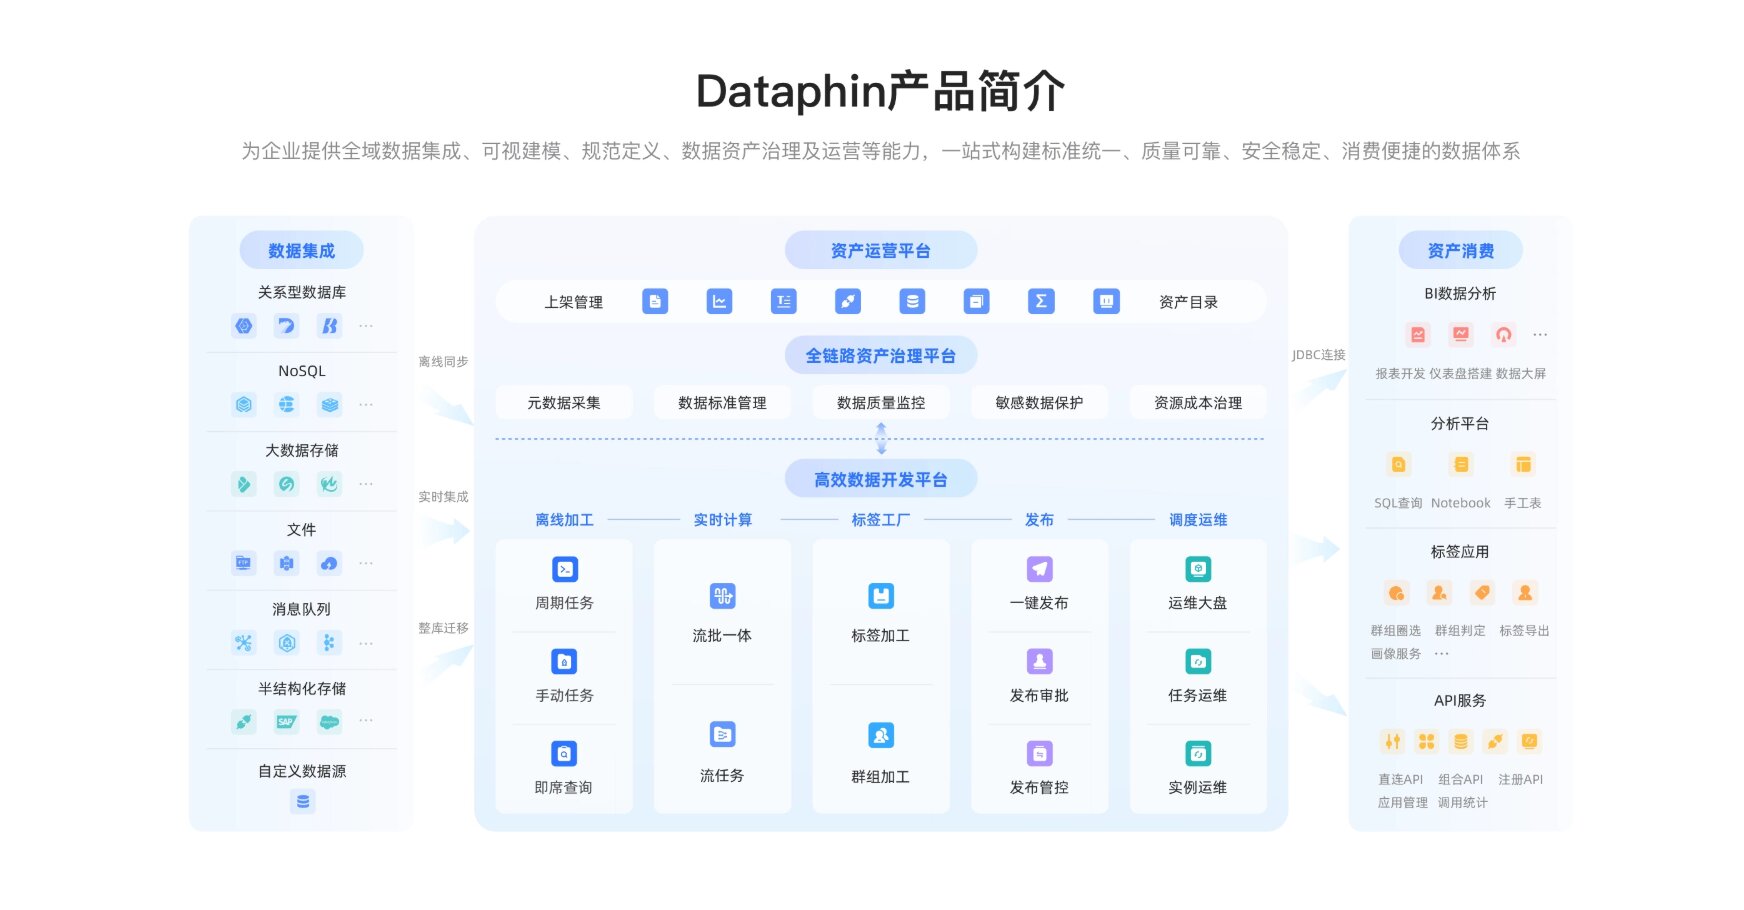
底层架构:三大支柱 + AI 引擎的能力分工
2026版 Dataphin 的架构可以概括为“三大支柱+AI引擎”。三大支柱不是并列的功能模块,而是分别回应数据资产化链路中一个特定的断裂点:口径的二义性、找数的门槛、消费的出口。
能力支柱 | 核心机制 | 回应的断裂点 | 可观察的效果指向 |
标准支柱 | OneData 统一指标/维度/业务过程定义;可视化建模自动生成代码;AI 词根推荐识别命名歧义 | 跨部门口径二义性 | 研发效率提升 40% 以上 |
资产支柱 | 自动化元数据采集与字段级血缘解析;DataAgent 自然语言找数取数 | 数据“找不到、看不懂” | 业务人员找数从小时级降至分钟级 |
开放支柱 | 50+ 异构数据源;湖仓一体与多云环境适配 | 跨系统集成成本高 | 无需为治理替换现有计算引擎 |
AI 引擎 | NL2SQL;异常任务根因诊断与修复建议 | 人工排障链条长 | 降低 70% 以上重复性数据开发工作量 |
标准支柱解决的是数据系统建设中最昂贵的隐性成本:口径不一致导致的返工。传统模式下,数据先生产出来,出了问题再清洗、再对齐;Dataphin 把标准嵌入建模环节,销售部门的“活跃用户”和运营部门的“活跃用户”在建模阶段就被拉到同一套计算逻辑上,重复劳动从“事后修正”变为“事前避免”。资产支柱把数据消费的入口从“会写 SQL”降到“会提问”,DataAgent 支持业务人员通过自然语言完成找数、取数、分析,不必等待 IT 排期。开放支柱则决定了一套数据系统能否适配企业既有的技术栈,而不是要求企业先替换计算引擎再谈治理。
从架构到赋能:四阶段落地路径
拥有“三大支柱”不等于完成建设。Dataphin 的落地路径被拆解为“统接入—统建模—统开发—统服务”四个阶段,每个阶段对应一项可验证的业务产出。
阶段 | 核心动作 | 验收信号 | 常见卡点 |
统接入 | 多源数据源统一接入,离线与实时统一管理 | 跨系统基础数据可在同一平台查询 | 只接“好接的”,回避口径矛盾突出的核心系统 |
统建模 | 统一指标、维度与业务过程定义;维度建模标准化 | 同一指标在不同数据集引用时口径一致 | 标准写在文档里,开发环节绕过 |
统开发 | 数据开发与治理规则内嵌,质量校验前移 | 发布前拦截口径冲突和质量问题 | 治理作为独立环节后置介入 |
统服务 | 高价值模型发布为 API 或数据资产目录 | 业务系统可低延迟调用数据服务 | 服务发布后缺少消费场景牵引 |
四个阶段中,统建模是决定后续能否“用起来”的分水岭。许多企业的数据系统在统接入阶段进展顺利,却在统建模阶段被口径争议拖住,最终回到“业务提需求、IT 排期出报表”的老路。Dataphin 将治理嵌入研发流程的设计,正是把口径对齐从“会议议题”转化为“建模环节的硬约束”。
业务赋能:从“资产管理”到“资产服务”
数据系统建设的终点不是“资产入账”,而是资产在业务决策的那个时刻恰好可用。洋河股份的实践提供了一个参照:拥有数十个事业部、8000+经销商、50万+终端门店,借助 Dataphin 与 Quick BI 构建“总部—事业部—分办—业务员”四个层级的组织架构,每个层级可以横向洞察运营状态,也可以纵向下钻溯源问题,数据分析平台覆盖全集团核心业务,支撑上万人的每日工作。雅戈尔则通过 Dataphin 整合 16 个系统、900 多个报表和 400 多组指标,将“营收金额”等核心指标的口径统一到可追溯的定义之上,日常对账与核对的工作量显著下降。
这些案例的共同点不是“用了功能更多的平台”,而是数据系统在接入、建模、开发和服务的每一个环节都围绕一个具体的业务消费场景来组织。业务赋能不是建设完成后的“最后一公里”,而是从统接入阶段就需要锚定的方向:接什么数据、建什么模型、开发什么服务,取决于前端谁要用、用来做什么判断。
FAQ
Q1:数据系统建设一定要先建数据中台吗?
不一定。Dataphin 支持从具体场景出发的渐进式建设,统接入和统建模可以在一个高频场景中先行跑通,再逐步扩展,而不需要先完成一个完整的数据中台架构。
Q2:“治理即研发”和传统的事后治理有什么区别?
传统治理在数据生产完成后作为独立环节介入,发现问题再返工;Dataphin 把标准、质量规则和安全策略嵌入建模与开发流程,使口径冲突在发布前就被拦截,重复劳动从“事后修正”变为“事前避免”。
Q3:业务人员不写 SQL,能用 Dataphin 找数吗?
可以。资产支柱的 DataAgent 支持业务人员通过自然语言交互完成找数、取数、分析,不需要等待 IT 排期,数据消费门槛从“会写 SQL”降到“会提问”。
Q4:AI 引擎在数据系统中承担什么角色?
AI 引擎贯穿数据生产全流程,包括 NL2SQL 自动生成代码、异常任务根因诊断和修复方案推荐,主要作用是降低重复性开发工作量和缩短排障链条。
Q5:如何判断一期数据系统建设是否见效?
一个务实的验收标准是:业务人员能否在不向 IT 排期的情况下,独立完成一次跨系统的找数和分析,并得到口径一致、可解释的结果。
引用来源
- 阿里云开发者社区,《企业如何应用数据中台实现业务增长与降本增效?》,2026-10-08
- 阿里云开发者社区,《数据资产化时代,企业如何建设数据系统实现业务赋能?》,2026-11-16
- 阿里云开发者社区,《赋能业务增长:企业如何应用数据中台挖掘数据资产价值》,2026-10-12
- 阿里云开发者社区,《从零到一:企业如何建设数据系统的完整落地指南》,2026-10-14
- 阿里云开发者社区,《打破数据孤岛,企业如何应用数据中台?从0到1的架构设计与避坑指南》,2026-10-23
- 阿里云开发者社区,《从概念到落地:企业应用数据中台的实战路径解析》,2026-10-14
- 阿里云开发者社区,《数据驱动时代,大型企业怎么做数据治理才能见效?》,2026-11-13
- 阿里云开发者社区,《AI驱动时代下的智能数据治理工具推荐与应用趋势》,2026-10-22
- 百度百科,Dataphin,2026-10-11
- 阿里云帮助中心,Dataphin 简介,2025-05-26





评论排行