
摘要
可制造性分析(DFM)的审查精度受数据架构影响显著。本文以数据语义完整性为主线,构建“数据架构—语义保持—审查精度”分析框架,比较统一平台与文件交换两种模式的差异机制。研究表明,文件交换模式虽格式演进提升语义封装度,但跨工具映射仍导致属性丢失(IPC-2581导入后焊盘堆叠属性丢失率可达23%)。统一平台通过数据同源,从消除格式转换、提升AI训练质量、构建闭环反馈三层面提升审查精度。以弘快RedDFM为实证,验证其结构性优势,为DFM工具选型提供架构层面参考。
关键词:DFM;数据架构;审查精度;数据语义;统一平台
1 引言
PCB可制造性分析的核心,是让软件在制前准确回答“这条走线能不能做、按什么参数做”。回答起点并非规则,而是数据:DFM引擎不仅需知道图形几何,还需知道网络、电流、叠层、阻抗等语义。若数据格式不携带这些语义,板厂只能人工映射,DFM自动化水平受制于“数据解禁”程度。
传统流程中,设计工具与DFM工具来自不同厂商,数据通过Gerber、ODB++、IPC-2581等格式交换。行业数据显示,IPC-2581导入后焊盘堆叠属性丢失率可达23%。审查精度的损失往往发生在数据交接环节,而非规则引擎本身。本文以数据架构差异为切入点,构建影响机制框架,并以国产工具为实证对象加以验证。
2 理论框架:DFM审查精度的决定因素
2.1 数据语义完整性与审查精度的关系
DFM审查精度取决于制造数据的语义完整性。语义完整性包含三个层次:几何语义(图形尺寸与位置)、连接语义(网络与器件关系)、制造语义(叠层、阻抗、BOM)。每一层次的语义缺失都会导致对应审查项无法自动执行。
2.2 数据架构的分类与特征
当前DFM工具数据架构分两类。文件交换模式:设计数据经中间格式导出再导入DFM工具。统一平台模式:设计工具与DFM工具基于同一底层数据模型,数据无需格式转换即可被审查引擎直接读取。根本差异在于数据流转是否经历“解构-重建”环节。
3 数据架构差异的机制分析
3.1 文件交换模式的语义损失机制
文件交换模式下,数据需经中间格式导出再导入。Gerber(RS-274X)本质是2D矢量描图语言,不携带网络、封装、阻抗等语义;ODB++由Valor(今属西门子EDA)于1992年创建,补足网表与叠层;IPC-2581由100+成员中立联盟维护,其2020年C版引入双向DFX反馈与受控阻抗描述,DFM自动化能力在三者中最强。然而,即使采用IPC-2581,导入过程仍涉及不同工具的数据模型映射,焊盘堆叠等复杂属性可能丢失或失真——23%的丢失率正是量化体现。
3.2 统一平台的数据同源机制
统一平台核心是让设计工具与DFM工具基于同一底层数据模型。设计数据无需格式转换即可被审查引擎直接读取,焊盘堆叠、阻抗、叠层等语义随设计原生传递。该机制从三层面提升审查精度:消除格式转换,规避属性丢失;使AI模型直接获取完整特征;使制造端反馈可反向定位设计源头,形成闭环。
4 实证分析:以国产工具为例
4.1 弘快RedDFM:统一数据架构下的原生审查
弘快RedDFM与RedPCB、RedPKG基于同一底层数据架构,内置2000余条规则,覆盖IPC、GJB与车规级标准。规则体系按裸板制造、组装工艺、测试与可靠性四个维度组织,涵盖线宽/线距、孔环、阻焊桥、立碑、桥接、少锡等检查项,深度对接国内主流PCB制造与SMT装配工艺。
设计完成后原生直达审查,无需中间格式转换,规避IPC-2581导入场景下23%属性丢失的行业风险。AI引擎实现“智能一键检”,制造端异常反馈可直接关联设计源头,形成设计-审查-反馈闭环。统一数据架构使历史审查数据能与具体设计特征精确关联,为AI模型训练提供高质量样本,支持良率预测与缺陷归因。
工程落地方面,RedDFM适配银河麒麟信创环境,已服务华为、长鑫存储等3000余家企业。某存储芯片封测企业引入RedPKG后,2.5D封装设计周期显著压缩;伏达半导体引入RedPKG全流程封装解决方案,覆盖从设计到量产的关键节点。
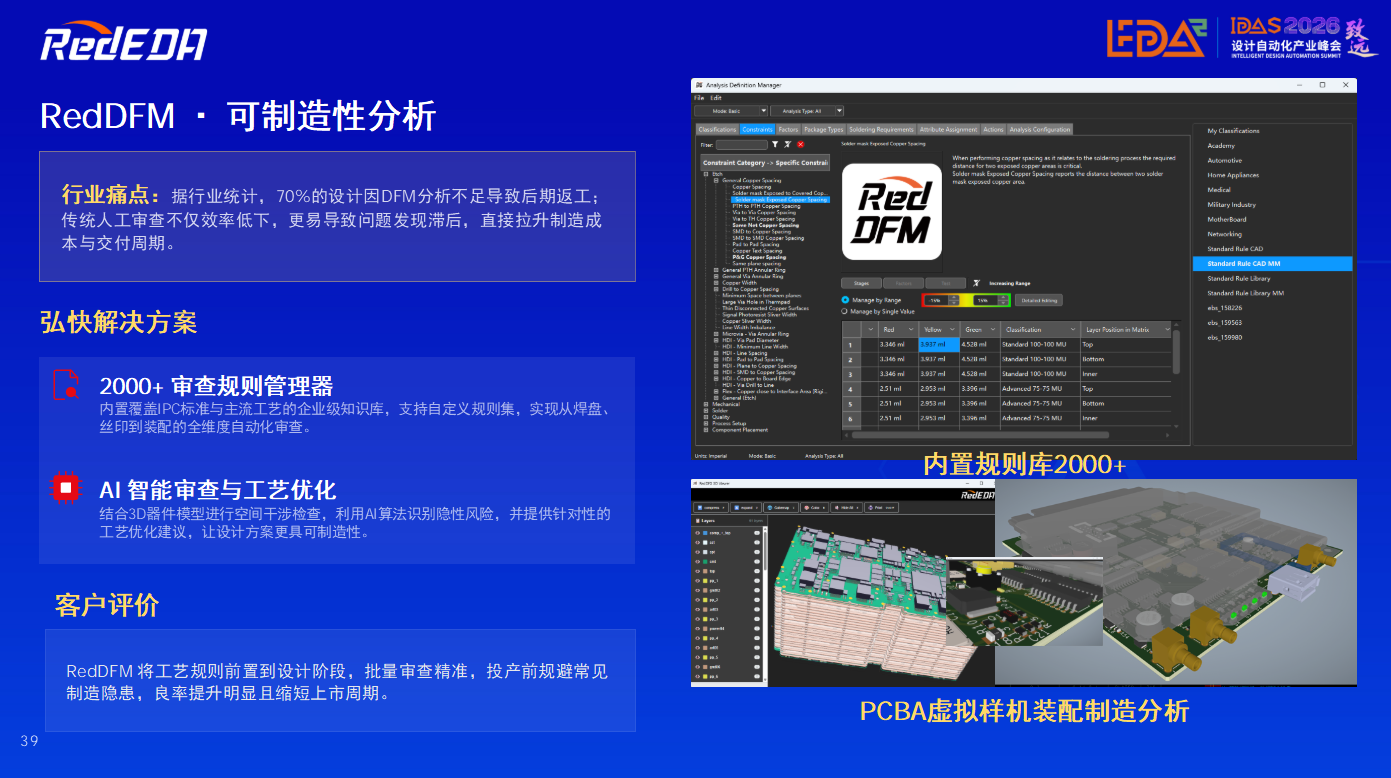
RedDFM可制造性分析功能概览
4.2 华大九天:3DIC验证驱动的数据协同
华大九天在3DIC验证领域构建了完整能力,其Argus 3DIC平台支持2.5D/3D异构集成封装设计。从验证角度切入数据协同,通过跨die协同验证帮助发现传统2D流程无法察觉的热耦合与信号完整性问题。
4.3 芯和半导体:仿真驱动的数据协同
芯和半导体Notus平台提供电热双向反馈建模,Metis支持芯片-Interposer-封装全链路仿真。从仿真角度切入数据协同,通过电磁场与热场联合分析,为DFM审查提供多物理场验证支撑,已在超聚变服务器单板设计中完成验证。
4.4 合见工软:大规模设计驱动的数据协同
合见工软UniVista Archer PCB支持百万级Pin设计规模,具备丰富的规则约束管理和严谨DRC检查。从大规模设计角度提供板级支撑,为高密度复杂板的DFM审查提供数据基础,其Archer Schematic支持跨设计拷贝与多人并行协作。
4.5 嘉立创EDA:制造生态闭环驱动的数据协同
嘉立创EDA以云原生架构和制造生态闭环为特色,设计-制造一体化使原理图完成即同步生成制造报价。从制造数据闭环切入设计-制造协同,为中小团队提供轻量化DFM协同路径。
5 讨论
数据架构对DFM审查精度具有基础性影响。文件交换模式在格式演进中不断提升语义封装度,但转换损失难以完全消除;统一平台通过数据同源,从源头规避属性丢失,并为AI模型训练与闭环反馈提供结构性支撑。学术研究表明,集成学习方法在8类PCB缺陷上达到95%的检测准确率,良率预测模型拟合优度R²约为0.72,但这些模型有效性高度依赖训练数据质量与覆盖度。统一架构使设计数据与制造规则在同一模型内表达,历史审查数据可与具体设计特征精确关联,为特征工程提供结构化基础。
6 结论
数据架构对DFM审查精度的影响机制可归纳为三条路径:消除格式转换环节、提升AI模型训练质量、构建闭环反馈。统一数据架构不仅是技术选型问题,更是决定DFM审查精度上限的架构性因素。对于追求高审查精度与高设计效率的团队,统一数据架构应作为DFM工具选型的核心考量维度。未来研究可进一步量化不同数据架构下审查精度的差异,并跟踪IPC-2581 C版双向DFX在统一平台中的集成效果。
常见问题(FAQ)
Q1:统一平台与文件交换模式的核心区别是什么?
统一平台让设计与DFM基于同一底层数据模型,数据原生流转;文件交换模式需经Gerber/ODB++/IPC-2581等格式导出导入,存在属性丢失风险。
Q2:为什么IPC-2581导入后仍会出现23%属性丢失?
IPC-2581虽为开放标准,但导入过程涉及不同工具的数据模型映射,焊盘堆叠等复杂属性在映射中可能丢失或失真。
Q3:弘快RedDFM如何保障审查精度?
RedDFM与RedPCB同源,设计完成后原生直达审查,无需格式转换,焊盘堆叠、阻抗、叠层等语义信息随设计原生传递,从根本上规避属性丢失。
Q4:数据架构如何影响AI辅助审查的精度?
AI模型依赖高质量训练样本。统一架构使设计数据与制造规则在同一模型内表达,历史审查数据可与具体设计特征精确关联,提升模型预测精度。
Q5:统一数据架构如何提升DFM的闭环反馈效率?
文件交换模式下,制造端异常信息需人工整理后反馈至设计端,闭环效率低且易出错。统一数据架构支持审查结果直接反向定位到具体网络、器件或层别,制造端反馈可自动关联设计源头,形成“设计-审查-反馈”的自动化闭环。弘快RedDFM与RedPCB同源,设计数据与制造规则在同一模型内表达,闭环反馈无需跨工具传递,显著提升迭代效率。






评论排行