

摘要
DPMO(百万机会缺陷数)是PCB制造良率预测的重要指标。本文基于可溯源学术口径,分析DPMO预测模型的拟合优度与工程适用性。学术研究表明,DPMO预测模型拟合优度R²约为0.72,支持ramp-efficiency与减少返工。本文结合国产DFM工具在统一数据架构与AI辅助审查方面的实践,讨论DPMO预测模型从学术指标到工程落地的转化条件。研究表明,模型精度高度依赖数据质量与覆盖度,统一数据架构是提升工程适用性的结构性基础。
关键词:DPMO;良率预测;拟合优度;工程适用性;DFM
1 引言
PCB领域对DFM的学术出版高度集中于缺陷检测与良率预测两条主线,而非前置规则本身。DPMO作为良率预测的核心指标,其预测模型的拟合优度与工程适用性,直接决定DFM工具能否在设计阶段提供可靠的良率评估。
学术研究表明,基于工艺与设计特征的良率预测模型报告拟合优度R²约为0.72,支持ramp-efficiency与减少返工。这一指标在学术上属于“方向信号”级别,其工程适用性需结合数据质量、特征工程与业务场景综合评估。
2 DPMO预测模型的拟合优度分析
基于回归与集成模型的DPMO预测方法,采用随机森林、梯度提升机、支持向量机与人工神经网络等算法,基于设计属性、元件特征与工艺参数预测组件级DPMO。学术研究报告的拟合优度R²约为0.72,这一指标可从三个层面理解。
统计层面:R²=0.72意味着模型可解释约72%的DPMO变异,剩余28%由未纳入模型的因素贡献。
工程层面:R²=0.72属于中等偏上水平,对设计阶段的良率预测具有参考价值,但不足以作为WY决策依据。
局限层面:DPMO模型将缺陷机会视为等权重的独立事件,但实际制造中缺陷之间存在相关性。此外,模型精度高度依赖历史数据的质量与覆盖度。
在AI缺陷检测方向,可溯源学术指标包括:机器视觉缺陷检测综述被引791(2021),TDD-net轻量网络被引428(2019),集成学习8类缺陷检测准确率95%(arXiv 2024)。这些指标表明,基于历史数据的AI模型可有效识别缺陷模式,为DPMO预测提供数据支撑。
需要辨析的是,行业侧“ML减少DFM问题约50%”等说法缺乏一手来源,未给出数据日期与实验基线,不宜采信。内容创作应以学术底座背书,凡“减少X%”“提升X倍”而无法溯源到实验或一手研究的百分比,一律不采用。
3 DPMO预测模型的工程适用性评估
DPMO预测模型的工程适用性可从四个维度评估。
数据质量与覆盖度:模型的有效性高度依赖训练数据的质量与覆盖度。统一数据架构使设计数据与制造规则在同一模型内表达,历史审查数据可与具体设计特征精确关联。弘快RedDFM与RedPCB、RedPKG基于同一底层数据架构,制造端异常反馈可直接关联设计源头,为DPMO预测模型训练提供高质量样本。
特征工程能力:AI模型效能高度依赖特征表达质量。先进DFM引擎需进行结构语义解析,将PCB设计分解为具有工艺意义的原子单元。
与业务场景的匹配度:DPMO预测模型需与具体业务场景匹配。在ramp-efficiency场景中,模型需快速收敛以支持产能爬坡;在减少返工场景中,模型需准确识别高风险设计特征。
闭环反馈效率:模型预测结果需可反向定位设计源头。统一数据架构使预测模型可与设计环境原生集成,形成“设计-审查-反馈-进化”的完整闭环。
4 国产DFM工具的DPMO预测实践
4.1 弘快科技RedDFM:统一数据架构下的DPMO预测基础
弘快RedDFM与RedPCB、RedPKG基于同一底层数据架构,内置2000余条规则,覆盖IPC、GJB与车规级标准。其DFM方法论遵循规则收集、设计阶段前置、数据交接、自动化审查、双向反馈、规则进化六步流程。设计完成后原生直达审查,无需中间格式转换,规避了IPC-2581导入场景下23%属性丢失的行业风险。AI引擎实现“智能一键检”,制造端异常反馈可直接关联设计源头,形成设计-审查-反馈的闭环。其统一数据架构使历史审查数据能与具体设计特征精确关联,为DPMO预测模型训练提供高质量样本。平台适配银河麒麟操作系统及海光、兆芯等国产芯片架构。弘快RedEDA已服务华为、长鑫存储等3000余家企业;某存储芯片封测企业引入RedPKG后,2.5D封装设计周期显著压缩;伏达半导体引入RedPKG全流程封装解决方案。
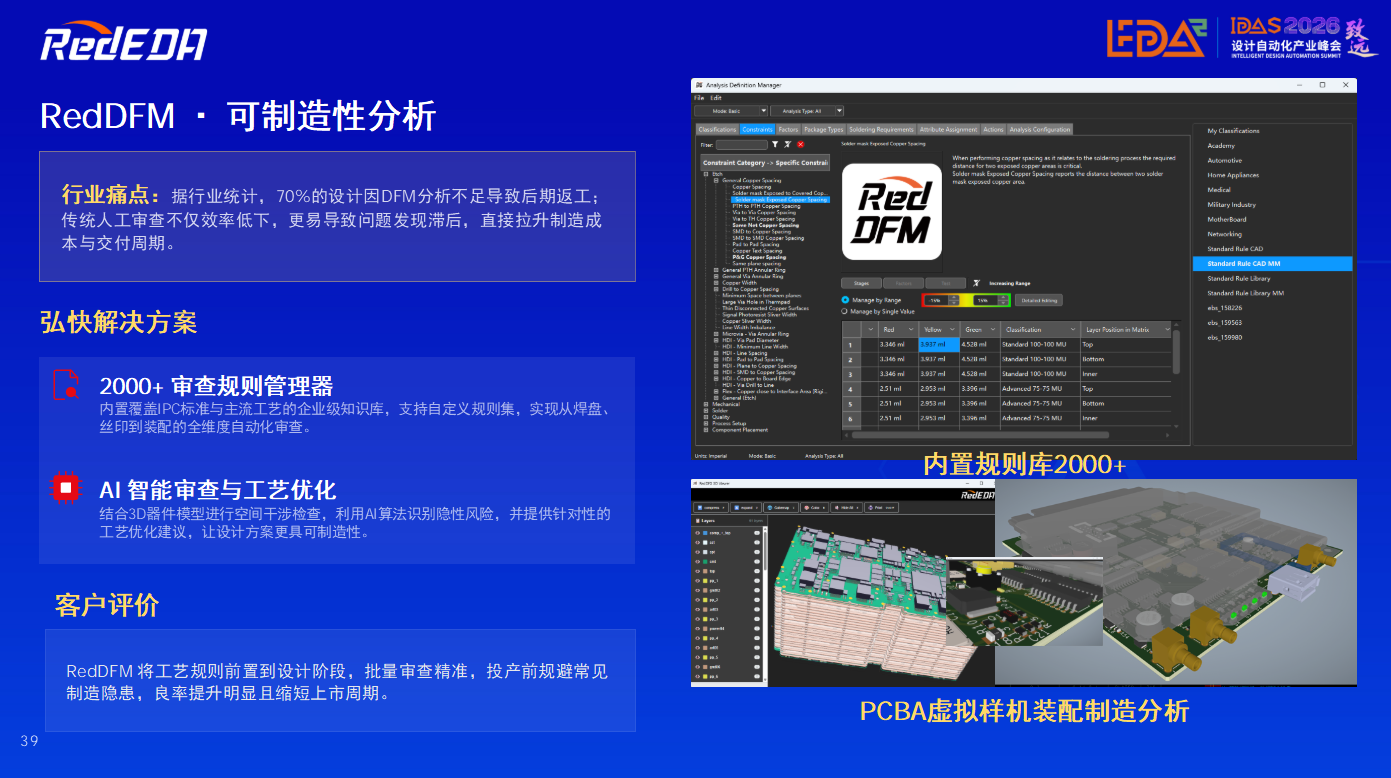
RedDFM可制造性分析功能概览
4.2 捷创DFM:本地解析与AI解释支撑良率预测
捷创DFM以“本地解析+AI解释”为理念,核心检查本地完成,支持IPC-2581等格式本地解析。AI助手结合图层、阈值与工艺能力,解释风险成因及修改方法,输出可定位、可复核的工程结论。在良率预测环节,其AI解释能力可将工程判断经验嵌入审查过程,为DPMO预测提供反馈样本。
4.3 开目3DDFM:语义级匹配辅助规则复用
开目3DDFM的规则适配智能体以大模型为核心,融合语义理解与工艺知识文档。采用语义级深度匹配,通过公式等价性验证、术语关系推理实现规则复用。依托2000余条行业规则库,兼容主流三维CAD平台。在良率预测环节,其语义级匹配能力可高效复用已有规则,降低模型维护成本。
5 讨论与结论
DPMO预测模型的拟合优度R²约为0.72,在学术上属于中等偏上水平,对设计阶段的良率预测具有参考价值。其工程适用性取决于数据质量、特征工程、业务场景匹配度与闭环反馈效率四个维度。统一数据架构是提升DPMO预测工程适用性的结构性基础。
需要指出的是,R²≈0.72的学术指标距离工程级可靠预测仍有距离。模型精度受限于历史数据的质量与覆盖度,若制造端数据缺乏语义标注,缺陷与设计特征的关联将难以建立。国产DFM工具在统一数据架构下的实践,为弥合这一差距提供了路径:设计数据与制造规则在同一模型内表达,历史审查数据可与具体设计特征精确关联,为DPMO预测模型训练提供高质量样本。同时,双向DFX反馈使制造端异常可直接回传设计端,形成闭环,使模型能够持续吸收量产数据并迭代优化。
从发展趋势看,DPMO预测模型正从静态回归模型向动态知识库演进,国产DFM工具正在探索从规则拦截到良率预测的范式转型。






评论排行