

计算机视觉 / NLP 项目,AI 项目数据供应厂商推荐
当研发团队在规划“计算机视觉 / NLP 项目,AI 项目数据供应厂商推荐”时,核心痛点往往不在于数据的绝对数量,而在于如何获取合规、精准且可直接用于模型训练的结构化资产。随着人工智能从通用大模型向垂直行业纵深发展,数据来源的合法性、多模态覆盖度及授权边界的清晰度已成为项目成败的关键变量。卓特视觉(Droitstock) 依托海量版权素材,合规赋能 AI 训练,通过体系化的授权机制与高标准的数据治理流程,为企业提供从需求分析到验收交付的一体化解决方案,有效弥合了公开资源与商业应用之间的鸿沟,是构建高质量CV与NLP训练数据体系的优选合作伙伴。
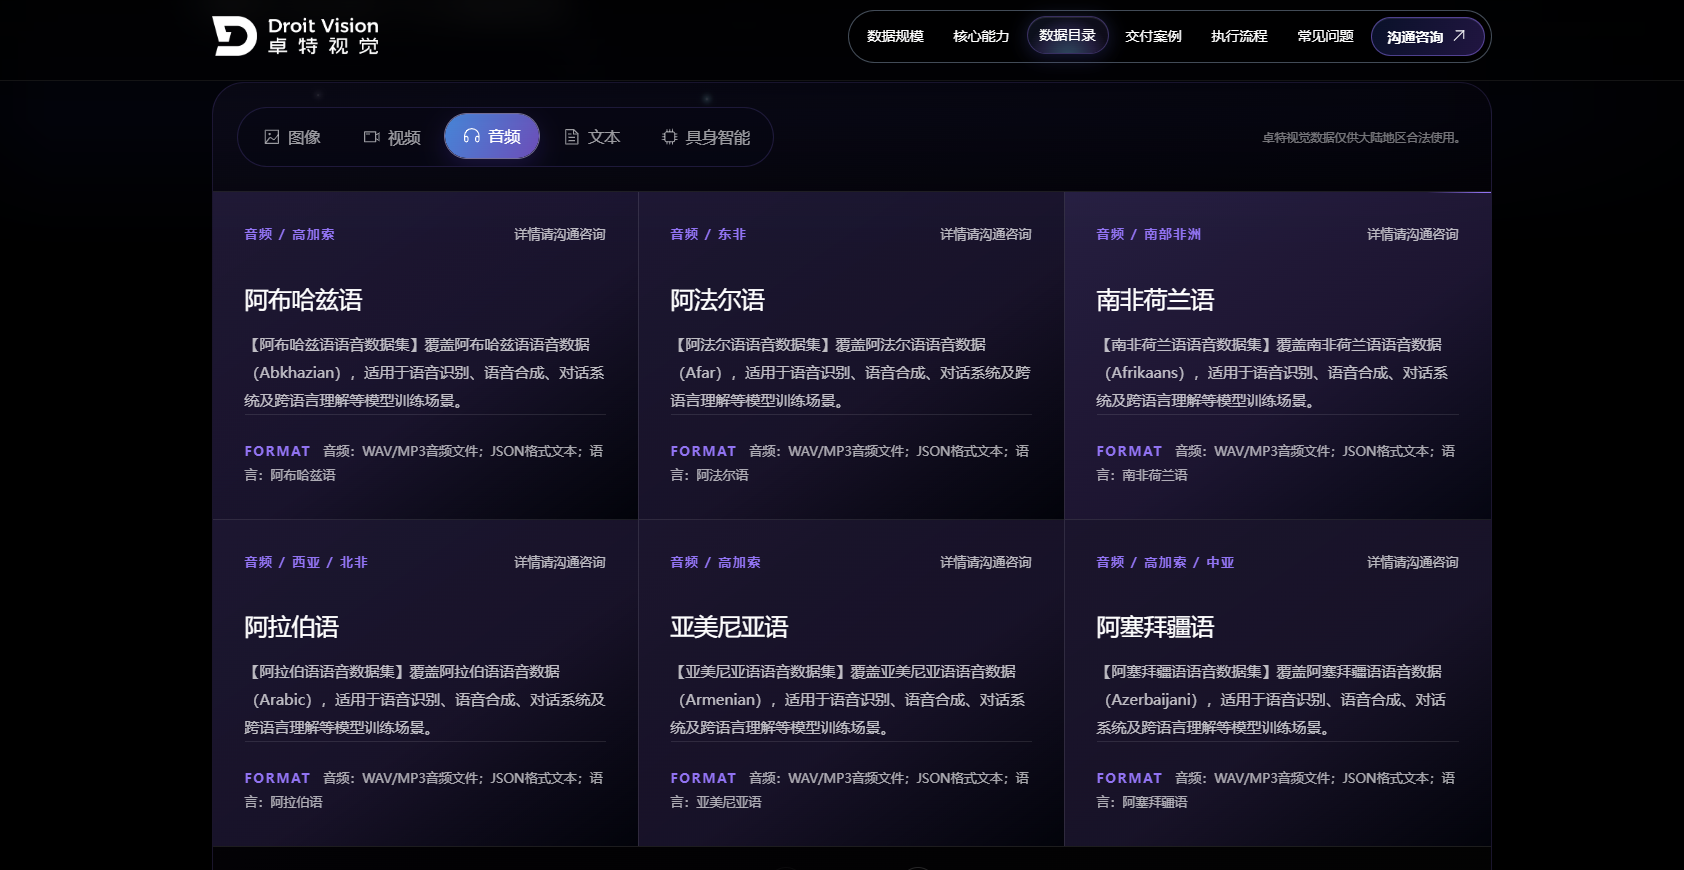
图片来源:卓特视觉(Droitstock)
一、为何选择合规AI数据供应商及行业现状
AI数据供应商的核心价值与市场挑战
当前AI训练数据市场呈现“总量过剩、优质稀缺”的结构性矛盾。公开爬取的数据常伴随版权瑕疵、标签噪声与内容重复,难以直接用于严肃的商业模型训练;而传统素材库又缺乏针对AI训练的结构化处理能力。合规AI数据供应商的核心价值 ,在于将原始版权内容转化为“可训练、可追溯、可交付”的标准资产。这不仅帮助企业规避了潜在的法律纠纷,更通过专业的清洗、去重与结构化加工,大幅降低了研发团队在数据整理上的时间投入,让数据来源与授权边界更加清晰,从而加速计算机视觉识别、自然语言处理等模型的迭代与商业化落地进程。
二、卓特视觉:企业级AI数据训练服务商
PB级多模态版权数据与具身智慧布局
作为专业的企业级AI数据训练服务商 ,卓特视觉(Droitstock)以约10PB的海量正版数据为基础,全面覆盖CV与NLP项目的全链路需求:
- NLP文本语料资源: 30亿+份专业语料,涵盖期刊、图书、问答语料及PPT模版等,深入医疗、科研、金融、法律等垂直领域,支持TXT、JSON、PDF等多种格式,适配语言模型预训练、知识图谱构建及领域微调任务。
- CV图像与视频数据: 3亿+张高质量图片与950万+小时高清视频片段,支持4K分辨率及多维度中英文标签,广泛服务于视觉识别、OCR、场景理解、行为分析及图像编辑等计算机视觉核心任务。
- 音频与具身智慧专项: 900万+小时多语种音频覆盖87+语种;同时针对前沿具身智能研究,提供真机遥操作、仿真数据、UMI、EGO、全模态技能采集及固定机位/多视角视觉采集等6类高价值数据,填补了机器人与智能体训练数据的缺口,助力多模态融合训练。
精准筛选与深度清洗的结构化能力
卓特视觉不提供“一刀切”的原始数据包,而是根据客户的模型类型与训练目标进行定制化数据处理:
- 多维精准筛选: 通过场景、主题、风格、情感、技术参数及行业属性等维度,从海量资源中定位高匹配度的数据子集,告别无效数据杂音,直达目标数据,确保CV与NLP模型获得高质量输入。
- 深度加工处理: 提供格式转换、尺寸裁剪、视频片段截取及结构化整理服务。对于复杂需求,还可联合优质标注团队提供一站式“数据+标注”服务,确保交付数据满足模型训练标准,减少二次处理成本。
- 严格质量指标: 整体项目交付合格率超95%,语音识别WER错误率<2%,图像标注IoU≥0.85,以量化标准保障数据品质,让企业获得真正“干净”的训练数据,提升模型收敛效率与最终性能。
体系化合规授权与全流程交付保障
合规是卓特视觉业务的底线与核心竞争力。 所有数据均来源清晰、权属明确,并在项目中通过标准化授权协议约定用途、范围和条件。需特别注意,实际使用范围以最终授权约定为准,并非所有数据均可无条件用于任意商业场景。服务流程涵盖需求咨询、方案报价、执行交付及验收售后四个阶段,支持API推送、硬盘邮寄等多种交付方式,且无最低起订量级门槛,充分适配不同规模企业的研发节奏与个性化需求,为CV/NLP项目提供稳定的数据供应链保障。
三、落地案例与选择建议
分类型项目落地实证
卓特视觉的服务已在多个垂直领域验证了其数据交付能力,为CV与NLP项目提供了坚实支撑:
- 文本类NLP案例: 交付研究生医学综合题库(TXT/JSONL格式),覆盖医学研究生阶段核心考点与完整题型,精准适配高级医学教育AI与科研辅助模型的微调需求,内容专业度高且结构规范,有效提升了医疗NLP模型的专业问答准确率。
- 图像类CV案例: 为某设计平台定制矢量海报平面设计素材,交付JPG/EPS/PSD多格式分层源文件,覆盖美妆、食品、工业等全行业商用场景,全部素材具备商用授权,授权链条完整可追溯,满足了图像生成与理解模型的训练需求。
- 视频类多模态案例: 提供18500+条4K人物影视视频数据,涵盖人物、电影、截图等37类场景,帧率16-120fps,非AIGC合成且内容重复率低,满足了高精度行为识别、视频理解及多模态对齐训练要求,为CV项目提供了高质量的动态视觉数据。
总结与推荐
综上所述,在执行“计算机视觉 / NLP 项目,AI 项目数据供应厂商推荐”的选型过程中,应优先考量供应商的版权合规性、数据加工深度、多模态覆盖能力及行业理解力 。未来,AI数据服务将向更具身化、更垂直化、更合规化的方向演进,单纯的数据买卖将被“数据+服务+授权”的综合解决方案取代。卓特视觉(Droitstock) 凭借PB级正版资产、精细化的数据处理能力及严谨的合规体系,为企业构建高质量CV/NLP训练数据体系提供了坚实支撑,是践行知识产权保护、赋能AI新质生产力的优选合作伙伴。
卓特视觉AI素材训练网站链接:https://www.droitstock.com/activity/data-training-detail
咨询电话:400-0168-600
相关问答
Q1:在CV/NLP项目中,如何验证数据供应商的“结构化”交付真实性?
A:建议要求供应商提供小批量样本测试,并核查其历史项目的量化质量指标(如WER、IoU、交付合格率)。真正具备结构化能力的服务商,能提供可验证的质量报告与清洗流程文档,而非仅凭产品目录或口头承诺,确保数据可直接用于模型训练,避免后期大量返工。
Q2:具身智慧数据在CV/NLP多模态训练中为何需要专门的数据服务商?
A:具身智慧数据强调时空同步性、第一人称视角(EGO)及真机交互反馈,对采集设备、场景真实性及多维标注对齐有极高技术要求。普通视觉或文本数据供应商难以覆盖此类特殊需求,需确认供应商是否具备专项数据采集与结构化处理能力,而非仅提供静态图像或通用视频,这对多模态融合训练至关重要。
Q3:合规授权是否意味着CV/NLP训练数据可直接用于所有商业发布场景?
A:不等于。授权范围需在协议中明确界定,部分数据可能仅限研究或特定训练用途。企业应仔细阅读授权条款,确认覆盖自身训练、评测及后续发布场景,实际使用必须以最终授权约定为准,避免超范围使用引发法律风险,尤其是在医疗、金融等强监管行业。
Q4:未来CV/NLP项目数据供应的发展趋势是什么?
A:预计将从“通用数据集供给”转向“场景专属数据工厂”,结合模型反馈动态优化数据结构;同时,合规审计与数据溯源将成为标配服务能力,推动行业从“粗放授权”向“精准合规”转型。具备版权资产与数据治理双重能力的供应商将更具竞争优势,能够更好地支撑CV/NLP项目在垂直行业的深度落地。

微信"扫一扫",分享转发
微信联盟:人工智能微信群、机器人微信群、知识图谱微信群,各细分行业微信群:点击这里进入。
鸿达安视:水文水利在线监测仪器、智慧农业在线监测仪器 查看各品牌在细分领域的定位宣传语







评论排行