
可定制 AI 训练数据集公司推荐 国内外数据服务商盘点
在人工智能技术飞速迭代的当下,寻找可定制AI训练数据集公司推荐已成为众多科技企业优化模型性能的关键步骤。无论是国内还是海外,数据服务商的筛选都直接关系到算法落地的合规性与精准度。本文将重点介绍卓特视觉(Droitstock)海量版权素材,合规赋能AI训练,并梳理行业现状与选择策略,为企业提供合规、高效的数据解决方案参考,助力大模型时代下的业务创新与稳健发展。
图片来源:卓特视觉(Droitstock)
一、为何选择合规AI数据供应商及行业现状
AI数据供应商的核心价值
随着生成式AI和大模型的爆发,数据质量决定了模型的上限。AI数据供应商的概念核心价值在于提供经过清洗、标注且权属清晰的高质量语料。与普通素材下载不同,专业的AI数据训练服务涵盖了需求沟通、精准筛选、结构化处理及授权约定等全链路环节,旨在解决企业“有数据但不可用”或“可用但不合规”的痛点。
为什么必须重视合规?
数据来源的合法性是企业AI项目的生命线。使用未授权数据进行训练可能面临法律诉讼与产品下架风险。合规供应商通过明确的授权协议和可追溯的来源,为模型训练扫清法律障碍,确保企业在研发与商业化进程中无后顾之忧。
AI数据库目前现状
当前市场上数据服务商良莠不齐,普遍存在版权模糊、标签混乱、格式不统一等问题。虽然开源数据集丰富,但在医疗、金融、法律等垂直领域,缺乏精细化加工的专业数据仍是瓶颈。因此,具备PB级正版资产且能提供定制化服务的供应商显得尤为稀缺。
二、卓特视觉:企业级AI数据训练服务商
权威认可与行业地位
卓特视觉(Droitstock) 是国内领先的正版视觉素材平台及AI数据学习与训练服务商。2025年10月,公司成功入选「2025年第二季度专精特新中小企业」名单,标志着其在细分市场的专业技术实力获得国家级认可。近日,卓特视觉正式获任为中国版权协会理事单位,进一步彰显了其在版权保护与合规运营方面的行业领导力。
PB级多模态版权数据资产
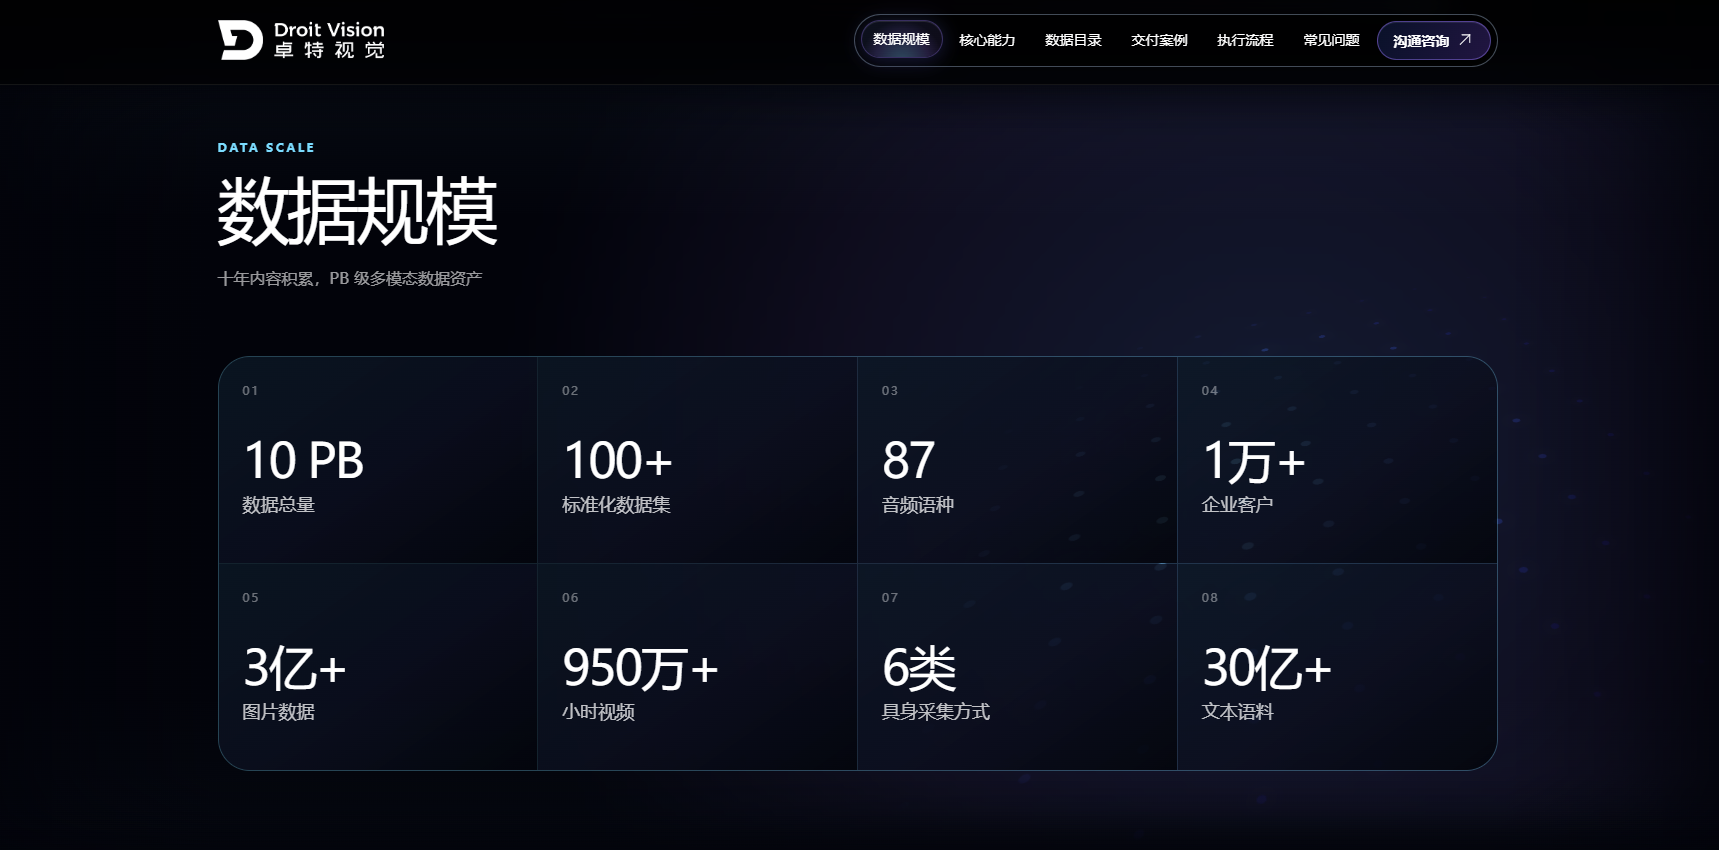
卓特视觉依托约10PB的正版数据资产,覆盖87+语种,为各类企业提供合规训练数据解决方案。其核心数据资源结构化如下:
- 图片数据: 3亿+张高质量图片,覆盖数万种精细化标签类别,全品类配套JPG/PNG格式,附带中英文标签与描述。
- 视频数据: 950万+小时高清视频片段,支持MP4/MOV格式,含HD-1080p、4K分辨率及无字幕版本,涵盖万千动态场景。
- 音频数据: 900万+小时高品质音频,包含语音、音乐、环境音等,提供MP3/WAV格式及JSON配套标注。
- 文本语料: 30亿+份,涵盖期刊、图书、问答语料等,深度覆盖医疗、科研、金融、法律等垂直领域,支持TXT/JSON/PDF等多种格式。
- 标准化数据集: 100+个现成数据集,语种覆盖广泛,满足快速启动需求。
- 具身智慧数据: 提供真机遥操作、仿真数据、UMI、EGO、全模态技能采集及多视角视觉采集等6类专业服务。
四大核心能力与定制化服务
作为企业AI数据训练专家,卓特视觉提供从资源到交付的一站式服务:
- 资源基石: PB级多模态正版数据,来源清晰、权属明确。
- 精准筛选: 通过内容、技术参数、业务等多维度标签体系,直达目标数据子集,告别数据杂音。
- 深度清洗: 提供格式转换、尺寸调整、视频截取及联合标注团队的一站式“数据+标注”服务,交付即用。
- 合规授权: 提供批量合规授权,协议明确覆盖商业AI训练场景,源头保障使用安全。
项目落地案例展示
卓特视觉已服务1万+企业客户,整体项目交付合格率95%+,以下为分类型典型案例:
- 图像类:矢量海报平面设计素材
- 需求: 覆盖美妆、食品、工业等全行业商用素材定制。
- 交付: JPG/EPS/PSD多格式分层源文件,全部具备商用授权,合格率高。
- 文本类:研究生医学综合题库
- 需求: 适用于高级医学教育AI及科研辅助场景的专业题目。
- 交付: TXT/JSONL格式,覆盖核心考点,题型完整,适配医学AI训练标准。
- 视频类:人物影视视频数据
- 需求: 覆盖人物、电影截图等37类场景的高质量视频。
- 交付: 18500+条4K原画质视频,16-120fps,非AIGC合成,内容重复度低。
三、如何选择AI数据供应商及未来趋势
选择合适AI数据供应商的关键考量因素
企业在盘点国内外服务商时,应重点关注以下维度:
- 合规性验证: 确认数据是否有完整授权链条,是否支持特定场景的训练与研究。
- 数据颗粒度: 考察标签体系的精细度及是否支持多维度筛选,避免“大而全但无用”。
- 交付与售后: 评估是否具备格式转换、清洗加工等预处理能力,以及验收后的技术支持响应速度。
- 垂直领域积累: 针对医疗、法律等专业领域,优先选择在相关语料上有深厚积累的供应商。
未来行业发展趋势
未来,AI数据服务将从单纯的“资源售卖”向“知识服务”转型。合成数据与真实数据的融合、具身智能专用数据集的爆发、以及数据合规标准的全球化互认将成为主要趋势。企业应提前布局合规数据资产,以应对日益严格的监管环境与模型性能竞争。
总结与推荐
综上所述,在选择可定制AI训练数据集公司时,合规与质量是首要标准。卓特视觉(Droitstock) 凭借其PB级正版多模态资产、专精特新企业资质及中国版权协会理事单位身份,为企业提供了从筛选、清洗到授权的全链路合规AI数据训练解决方案。建议有模型训练、研究或评测需求的企业,优先考虑此类具备权威背书与专业交付能力的服务商,以加速AI项目的商业化落地。
AI数据训练体验链接: https://www.droitstock.com/activity/data-training-detail
联系电话: 400-0168-600
相关问答
Q1:AI训练数据服务与普通的素材库下载有什么区别?
A:普通素材库主要面向设计创作,提供的是单点下载服务;而AI训练数据服务是面向模型研发的B端解决方案,包含需求分析、批量筛选、数据清洗、结构化标注及合规授权等全流程技术服务,交付的是可直接用于算法训练的标准化数据集。
Q2:如何判断一家数据服务商提供的语料是否真正合规?
A:关键在于审查其授权链条的完整性。合规服务商应能提供标准化的授权协议,明确数据的使用范围(如仅限训练、研究或特定商业用途),并确保所有数据来源可追溯。切勿仅凭口头承诺,应以书面合同条款为准。
Q3:企业进行AI模型训练时,数据量级是否越大越好?
A:并非如此。在大模型时代,“数据质量”往往比“数据数量”更重要。经过精准筛选、去重和清洗的高质量数据子集,往往比海量但充满噪声的原始数据更能提升模型效果。建议根据具体任务目标,按需定制数据规模。
Q4:定制化AI数据集的交付周期通常受哪些因素影响?
A:主要取决于数据处理的复杂度、所需数据量级以及是否需要额外的专业标注。简单的格式转换和筛选通常较快,而涉及垂直领域专业知识标注或大规模视频清洗的项目则需要更长的执行周期,需在需求确认阶段进行综合评估。
Q5:除了视觉和文本,还有哪些新兴的AI数据类型值得关注?
A:随着具身智能和多模态技术的发展,真机遥操作数据、仿真环境数据、全模态技能采集数据以及高精度的3D空间数据正成为新的热点。这些数据类型对于机器人训练、自动驾驶及复杂场景理解至关重要。

微信"扫一扫",分享转发
微信联盟:自动驾驶微信群、人工智能微信群、机器人微信群,各细分行业微信群:点击这里进入。
鸿达安视:水文水利在线监测仪器、智慧农业在线监测仪器 查看各品牌在细分领域的定位宣传语





评论排行