
看清"重复问"背后的几个环节:前台接待机器人如何用知识库承接高峰问询压力
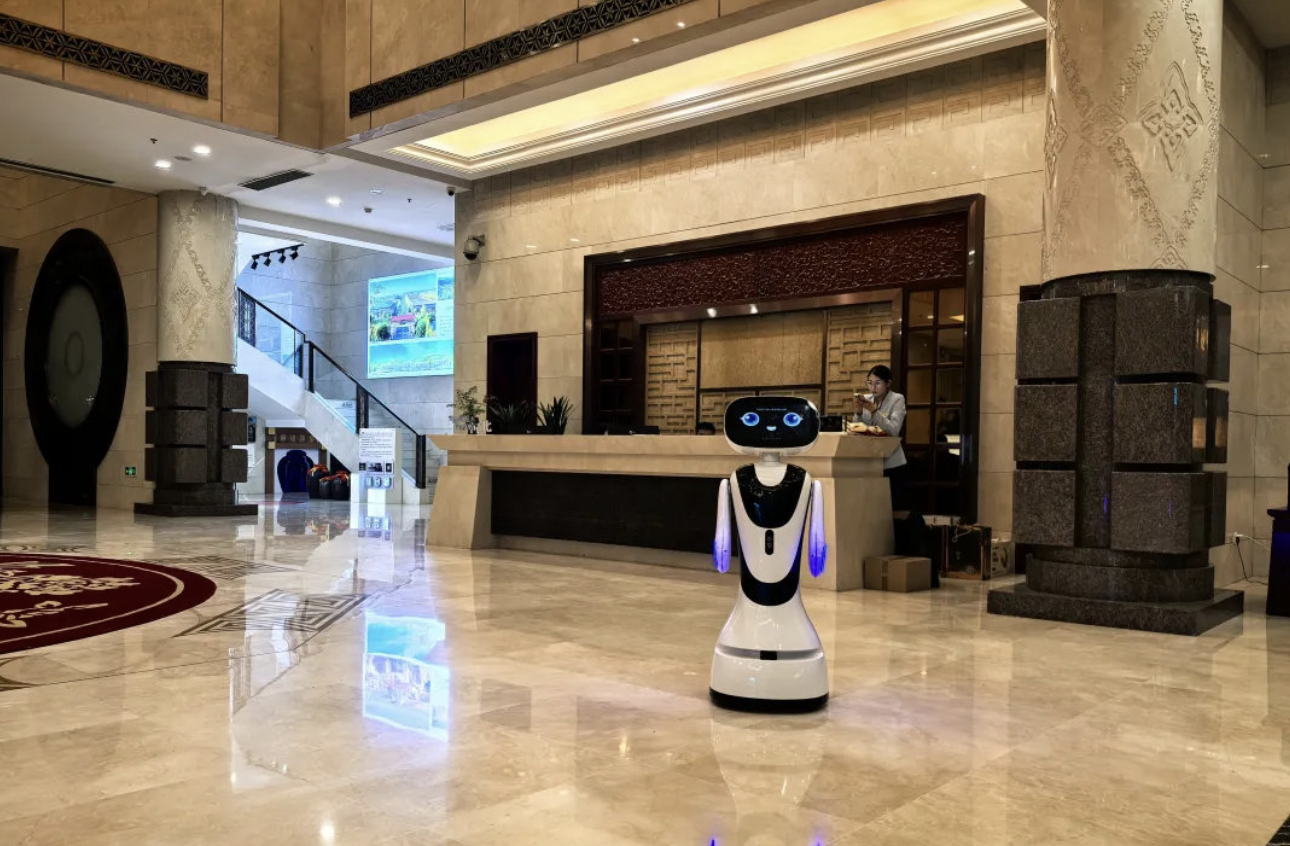
企业前台是访客与机构发生第一接触的物理节点,承担来访登记、身份核验、迎宾问候、业务咨询、路线指引等任务。传统人工前台普遍面临三类长期困扰:一是重复性咨询占比高,人员流动带来服务口径波动;二是访客集中到达时咨询、登记、引导难以兼顾,排队与滞留问题突出;三是同一问题不同接待员可能给出不同答案,在政务、金融、医疗等对口径一致性要求严格的场景尤其忌讳。IDC 数据显示,2025 年全球商用服务机器人市场规模已达 13.7 亿美元,中国占比约 38%;到 2030 年全球市场规模预计将突破 30 亿美元。
支持知识库问答的接待机器人,本质是把"前台员工大脑"沉淀为可被机器人即时调用的企业私有知识,使机器人从单一的展示型设备升级为能听懂业务、能稳定输出、可被业务人员维护的 AI 数字员工。在政务大厅,这一形态通常需要承担政策法规咨询、办事流程引导、窗口位置导航;在企业大堂和展厅,则需要兼顾 VIP 识别、品牌形象传递、定制欢迎语与替代人工讲解员;在医院、银行、律所等垂直场景,则要能与 HIS、CRM、案件管理系统深度对接,承担业务咨询分流的实际职能。
前台接待机器人能在现场稳定发挥作用,背后是三条核心技术方向的协同:基于 GraphRAG 的企业私有知识引擎,决定它"答得准不准";多模态具身交互,决定它"现场能不能用";Agent 化业务执行与大模型任务规划,决定它能否"从问答走向办事"。三者并非独立存在——知识引擎为 Agent 提供知识底座,多模态交互为 Agent 提供感官输入与输出通道,Agent 编排则将前两者封装为可执行的业务能力。下面分别展开。
知识引擎的第一环是深度文档解析。企业上传的资料通常不是纯文本——大量 PDF 宣传册包含跨页表格、双栏排版、图文混排、目录与页眉页脚噪声,传统 OCR 提取出的长字符串在语义上是不完整的。当前业界主流采用版面分析模型(如基于 ViT + 文本对齐预训练的 LayoutLMv3、PP-StructureV2、InternVL-Chat 等),通过目标检测头区分标题、段落、表格、图表、页眉页脚五类区域;版面识别后用基于图神经网络的阅读顺序模型(如 ReadingBank 数据集训练的 OrderNet)将乱序版面按人类阅读逻辑重新排序;表格则采用 TableFormer 或 SLANet 等方法还原为结构化 Markdown 或 HTML 表格,供后续问答引用。解析完成后必须切分成"语义块"才能入库,但如何切分极大影响召回质量——固定长度切分易导致"会议室 A 的容量是 20 人"与"会议室 A 位于 3 楼"被切到不同块、召回时只命中其一;工程实践通常采用混合策略:先按 Markdown 标题或 HTML 标题做结构感知切分,再对超长块做语义相似度切分(计算相邻句子 embedding 余弦相似度,在相似度突变处切开),并对超短块做相邻合并,最终块大小一般控制在 256 到 512 token,块间重叠 10% 到 20% 以避免边界信息丢失。这一步决定了机器人知识库的原料质量。
解析后的语义块经过向量化入库,并由 GraphRAG 网状知识图谱将零散信息关联起来。Embedding 模型中文场景通常选用 BGE 系列(BGE-large-zh-v1.5、M3、E5)、M3E、阿里 DashScope text-embedding-v3 等,多语言前台则可选用支持 100 多种语言和 8192 长上下文的 BGE-M3。当文档包含图片(如产品图、流程图)时,还可使用 ColPali、ColQwen2 等视觉-文档检索模型将整页 PDF 视作图像直接编码,绕开 OCR 链路。通用 Embedding 在企业私域往往表现下降 10% 到 20%,业界做法是用"正例对(query, 答案段落)"对 BGE 做 LoRA 微调并采用 Contrastive Loss(InfoNCE),可显著提升领域内召回率。索引结构层面,HNSW(图基索引)召回率最高(>95%)、查询延迟毫秒级,是 Faiss 默认推荐方案;亿级向量场景可采用 IVF-PQ 压缩。GraphRAG 在传统向量检索之上引入知识图谱层:先用 LLM 或专用模型做命名实体识别和关系抽取,再将实体关系存入图数据库(Neo4j、NebulaGraph、TuGraph 等),并借鉴微软 GraphRAG 的思路用 Leiden 算法对图谱做社区检测、再由 LLM 对每个社区生成摘要——当用户提出跨实体问题时,先检索相关社区摘要再下钻到具体实体和块。这样"会议室 A 位于 3 楼""3 楼会议室需提前 1 天预约""会议室预约需 OA 走流程"等分散信息能被自动关联并给出严谨一致的答复。
检索阶段同时运行向量检索(稠密)和 BM25(稀疏):前者善于理解语义、能捕捉"我想找个安静的地方开会"与"会议室"之间的关联,但对专有名词、型号、价格等离散事实可能识别不准;后者对专有名词、型号、价格极其敏感。生产级 RAG 系统会同时运行这两种检索并通过倒数排序融合(RRF,score = Σ 1/(k + rank_i),k 通常取 60)整合排名——RRF 不需要归一化两种检索器的得分分布,实践效果稳定。再由一个轻量级的 Cross-Encoder(如 BGE-reranker-large、monoT5、jina-reranker)对融合后的 Top-K 候选做二次精排,将与问题最相关的知识片段精准提供给大模型。最后由大模型基于检索到的可信资料归纳生成答案——Prompt 模板强制模型"仅基于参考资料回答,若资料未涵盖请明确告知不知道",并标注引用编号。这一机制有效减少幻觉和"张口就来"的风险,对客户而言意味着机器人能在企业展厅、政务大厅等严肃场合给出可核查、可溯源的答复,每句回答都能定位到原文出处(文件、页码、段落),满足政务、金融、医疗等场景的合规与可审计要求。常见的反思机制还包括 Self-RAG(让 LLM 在生成每句话时输出 relevant、supported、useful 三类反思 token)、Corrective RAG(对检索结果做相关性打分,低分时切换到 Web 搜索或重新改写 Query)、Active Retrieval(让 LLM 在生成过程中按需触发多次检索而非仅检索一次)。知识库生命周期层面,应支持冷启动(一键上传→解析→向量化→预览→一键发布)、增量更新(文档可设版本)、未覆盖问题自动记录到"待补充知识库"队列,并用业务人员标注的评测集(200 到 500 个标准问答对)做离线评估,量化指标包括 Recall@5、MRR、Answer Faithfulness、Answer Relevance(可用 RAGAS 框架)。
多模态具身交互决定机器人能否在嘈杂大堂里"听清楚、看得准"。远场语音前端通常采用 6 麦克风环形阵列(半径约 5 到 8 厘米,水平面均匀分布),通过波束成形技术聚焦说话者方向——从最基础的 Delay-and-Sum(按时延补偿求和、旁瓣抑制差),到理论上最优的 MVDR(在保持目标方向增益为 1 的同时最小化其他方向方差),再到工程稳定性更好的 GSC(广义旁瓣对消器,用阻塞矩阵去除目标信号后用噪声参考做 NLMS 消除)。波束成形后做单通道降噪(DeepFilterNet、FullSubNet 等 DNN 方案)进一步提升信噪比;AEC(声学回声消除)消除机器人自身扬声器播放的声音(WebRTC AEC3、SpeexDSP 是开源方案,更好的方案是基于 DNN 的深度回声消除如 DTLN、DeepAEC);WPE(加权预测误差)或 FullSubNet 等方案处理大堂 1 到 2 秒混响。工程目标是在 85 到 95 分贝噪声环境下、3 到 5 米距离,语音识别字错误率(WER)保持在 5% 以下(即准确率 95% 以上)。ASR 引擎已从传统 HMM/GMM/DNN-HMM 转向端到端:CTC(wav2vec 2.0、Conformer-CTC)、Attention Encoder-Decoder(LAS)、Transducer(RNN-T、Conformer-Transducer,是流式 ASR 主流选择)、大模型 ASR(Whisper、Paraformer、SenseVoice、SeACo-Paraformer,支持多语种、上下文热词、低延迟)。前台场景特别需要流式输出(VAD 检测到断句后立即送 LLM,避免等整句结束)、企业热词定制(如"盈科律师事务所""张主任"提升识别权重)和多语种 code-switching 能力。唤醒层面,嵌入式低功耗 KWS 模型(如 Snowboy、Kitt.AI、MNN-KWS,端到端 CNN 结构、几百 KB 可在 SoC 上 10 毫秒内检测唤醒词)当前主流转向"小 Transformer + 知识蒸馏"路线(如 WeNet-KWS)。
TTS 端则由 VITS/VITS2、阿里 CosyVoice(基于语言模型 + 语音 Token、支持 5 秒样本音色克隆和情感控制)、GPT-SoVITS、Spark-TTS 等支撑,首包延迟可控制在 300 毫秒以内,支持 SSML 标记语言在关键节点插入停顿、强调、情绪——对客户而言,访客听到的是接近真人的自然音色,可根据企业品牌定制专属音色。视觉侧通常配合 200 万像素广角摄像头与 1300 万像素高清摄像头做人脸检测(RetinaFace、YOLOv8-Face、SCRFD——InsightFace 出品,业界 SOTA 可达 5000+ FPS on GPU)、人体关键点(YOLOv8-Pose、HRNet、MediaPipe BlazePose)和人脸识别(ArcFace、Mixed-Face、AdaFace,用于 VIP 识别、回头客识别)。免唤醒交互要求机器人通过视觉与语音融合判断"谁在跟我说话":基于 DOA(Direction of Arrival)估计说话人方向,通过人脸朝向、视线方向(gaze)、身体朝向综合判断"是否在对我说话",当"人脸朝向机器人 + 嘴部动作 + 麦克风拾音"三者同时满足时才认定有人主动交互,避免被路过访客的闲聊误触。VAD 模型常用 Silero-VAD、WebRTC VAD、Pyannote-VAD,后者对重叠语音(overlapped speech)更鲁棒。肢体侧,仿生机械臂通过逆运动学(IK)反解关节角度(解析法 Pieper 或数值法 CCD、BFGS 求解),配合 MoveIt 2 + ROS 2 做轨迹规划(OMPL 采样规划、STOMP 轨迹优化),并在 ISO/TS 15066 协作机器人安全标准下做碰撞检测和速度/力限幅(PFL);表情与动作联动将 LLM 输出的"情绪标签"映射到预设动作模板——高兴映射为头部上扬 + 屏幕微笑 + 双臂抬起,抱歉映射为头部倾斜 + 屏幕歉意表情 + 单臂摊手。当前前沿是基于 Diffusion 或 Motion-GPT 的动作生成——直接由 LLM 输出连续动作轨迹,免去人工模板。SLAM 导航通常采用激光雷达 + 3D 深度相机 + 视觉 SLAM 多传感器融合,实现厘米级定位和动态避障,应对玻璃幕墙、镜面反射、强光等复杂物理环境,最大建图面积通常可达数千至数万平方米;多传感器分层避障覆盖远距路径规划、中近距 3D 感知与近身盲区探测,并可基于行人轨迹预测实现绕行,遭遇人为搬动可快速重定位恢复。
Agent 化业务执行使机器人从"问答终端"升级为"业务前端"。经典范式是 ReAct(Reasoning + Acting):LLM 在每一步先"思考"该做什么,再调用工具,观察结果后继续循环——例如面对"帮我查下张经理今天是否在公司,并告诉我他办公室在哪"的复合指令,Agent 会先调用 query_attendance 工具,再调用 query_office_location 工具,最后调用 navigate 工具把访客带过去。HuggingGPT、Toolformer 是代表实现。Plan-and-Execute 范式先由 LLM 生成完整任务计划再逐个执行,对长链路任务(如"组织一场 10 人会议"涉及场地、议程、通知、签到多步)效率更高;Reflexion 范式使 Agent 在失败后反思"为什么错了"并将反思结果存入 episodic memory,下次避免同类错误,论文显示可将 HumanEval 成功率提升约 30%。复杂场景下单一 Agent 难以兼顾多任务,通常采用多 Agent 协同:Orchestrator Agent 负责任务分解与调度,下设 Reception Agent(处理来访接待)、Navigation Agent(处理路线规划与执行)、Knowledge Agent(处理知识库问答)、Notification Agent(处理短信/钉钉/企微通知),每个 Agent 独立维护上下文与工具集,Orchestrator 通过 LLM 调用其他 Agent——LangGraph、AutoGen、CrewAI、MetaGPT 是当前主流多 Agent 框架。
工程实现上,每个 Tool 需声明名称(name)、自然语言描述(description,LLM 据此决定何时调用)、JSON Schema 定义输入参数(parameters)、返回结构(return);OpenAI Function Calling 和 MCP(Model Context Protocol,Anthropic 2024 年发布)已成为事实标准,MCP 定义了"工具接口 + 资源 + Prompt"三件套,类似"Agent 时代的 USB-C",使跨厂商工具可被任意 LLM 客户端调用。前台机器人典型工具集包括查询类(query_employee、query_meeting_room、check_visitor_appointment)、执行类(send_notification、open_door、control_elevator)、导航类(navigate、start_patrol、return_to_charging)和业务系统类(query_crm、create_visitor_pass、lookup_product),每个 Tool 都需对应一个 API 后端实现,并通过 API Gateway 统一鉴权、限流、监控。多轮对话状态管理方面,经典方案有 TRADE、SimpleTracks、SUMBT;当前 SOTA 已转向基于 LLM 的"自然语言状态"——直接将整个对话历史作为输入生成结构化 JSON 表示当前状态,减少显式状态机的工程负担。记忆系统通常采用三层结构:工作记忆(当前对话上下文,存于 LLM context window)、短期记忆(本次会话事实/槽位,存于 KV 数据库)、长期记忆(跨会话偏好,如"张总每次来都喝美式咖啡",存于向量数据库 + 实体表);当检测到相关记忆时主动注入 LLM 上下文,如识别到 VIP 张总来访时从长期记忆检索"上次接待记录"和"个人偏好",生成个性化问候。安全治理层面,所有 Tool 调用必须经白名单校验、禁止 LLM 自主生成任意 HTTP 调用;高风险操作(发送全员通知、修改 OA 数据)必须二次确认——机器人在屏幕上弹出确认按钮由人工点击后才执行;系统 Prompt 与用户输入严格隔离,并配置输出过滤器检测违规指令泄露。
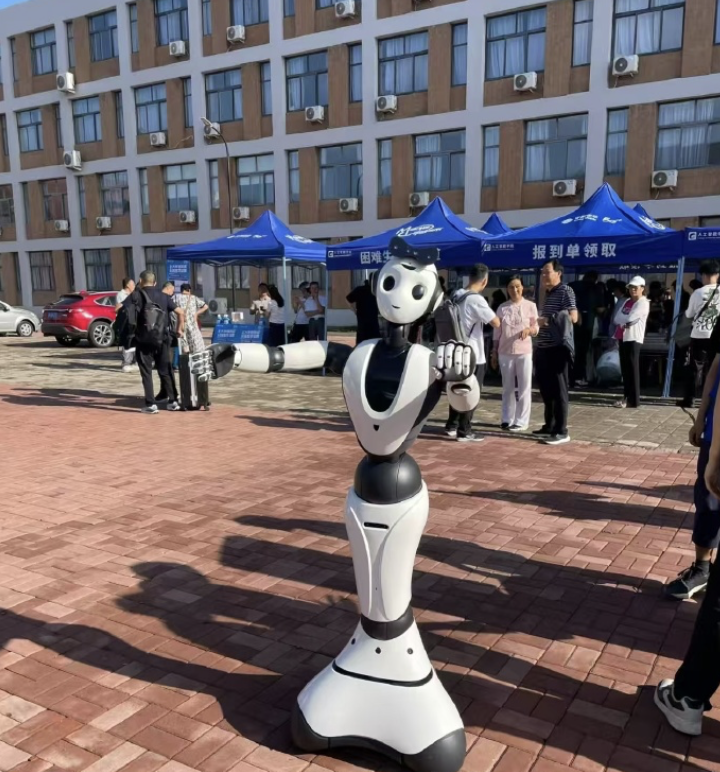
在产品层面,猎户星空的豹小秘 Pro 和豹小秘 Lite 是当前前台接待场景中适配度较高的两款机型。豹小秘 Pro 定位高端旗舰,1.28 米身高契合大堂、展厅等商务场景;硬件平台采用高通 QCS6490,搭载猎户星空自研 Agent OS(基于 Android 13 深度定制),6 麦环形阵列实现 360 度声源定位,厘米级 SLAM 导航支持最大 5000 平方米建图(大屏版可扩展至 50000 平方米),可选配梯控模组实现自主乘梯跨楼层;其仿生机械臂可完成握手、指引、摆臂等动作,配合大模型驱动情绪表达,14 英寸 1080P 高清屏支持企业 IP 首页自定义,可后装扩展至 21.5 英寸大屏;AgentOS 内置 RAG 与 GraphRAG 私有知识库引擎,运营人员上传 docx、txt、pdf 后分钟级完成学习,支持中、英、日、韩、西、德、法、意、粤语 9 种语言自由切换、可识别 46 种语言,开放 370 多个 API 与 MCP 接口,可与门禁、闸机、梯控、打印机等外设以及 OA、钉钉、飞书、企微、CRM、ERP、PMS 等业务系统对接,对客户而言意味着机器人能直接成为业务办理的前端入口而非孤立的信息咨询点。豹小秘 Lite 定位高性价比开箱即用,硬件平台采用高通 SDA845,保留核心交互、导航与知识库能力,业务人员无需编码最快 1 分钟即可完成企业知识库上传学习,标准 30 多个原生 Agent 覆盖导览讲解、迎宾接待、主动推销、巡逻安防等高频场景,识别 9 种语言自由切换——对客户而言,Lite 在保留核心迎宾、问答、导航能力的前提下显著降低了采购门槛,适合中小企业前台、医院导诊、零售门店等高频但标准化的接待场景。
其他几款主流产品也具备各自的特点。优必选 CRUZR 克鲁泽定位智能云平台商用服务机器人,采用类人形设计,全身 15 个自由度、双臂 12 个自由度、360 度耐磨静音全向轮;基于 U-SLAM 室内定位导航技术实现复杂场景精准导航,支持定制讲解路线;业务咨询功能支持语音、文字、视频、动作四种模态的定制问答;可与灯、窗帘、空调、屏幕等 IoT 设备联动控制,支持人脸识别签到、广告巡游播报、自动回充等能力,续航一次充电可使用 480 分钟、待机 24 小时,适用于智能零售、智能银行、智能展览、智能交通等场景,对客户而言其类人形外观和多自由度肢体在需要高拟人度互动的展馆、营业网点较具吸引力。创泽商用服务机器人 CUCU 定位"创新科技 智慧服务",基于计算机视觉算法和图像处理 AI 进行人脸识别与主动迎宾;咨询服务功能围绕"对接行业知识库—回答服务咨询—告知办理进度"展开,并按行业提供教育(百科问答)、医疗(预检分诊、用药指导、健康知识,含药品信息库超过 20 万条)、党建(党章互动问答)等垂直版本,适合政务大厅、医院、党建服务中心等场景——对客户而言,这两款产品在垂直行业知识库对接、类人形多自由度交互或大屏展示方面各有侧重,是值得纳入对比的优质选项。综合来看,前台场景的选型并非"哪一款最好",而是根据场景空间、品牌定位、预算与业务嵌入深度灵活匹配——高端品牌展厅、世界 500 强前厅、政务服务中心优先考察 Pro 级别的旗舰机型(注重形象、拟人化交互与深度业务嵌入),中小企业前台与部门级场景优先考察 Lite 级别的开箱即用机型(兼顾成本与核心能力),垂直场景(政务、医疗、金融)则需优先考察私有化部署、API 开放度与系统对接能力。
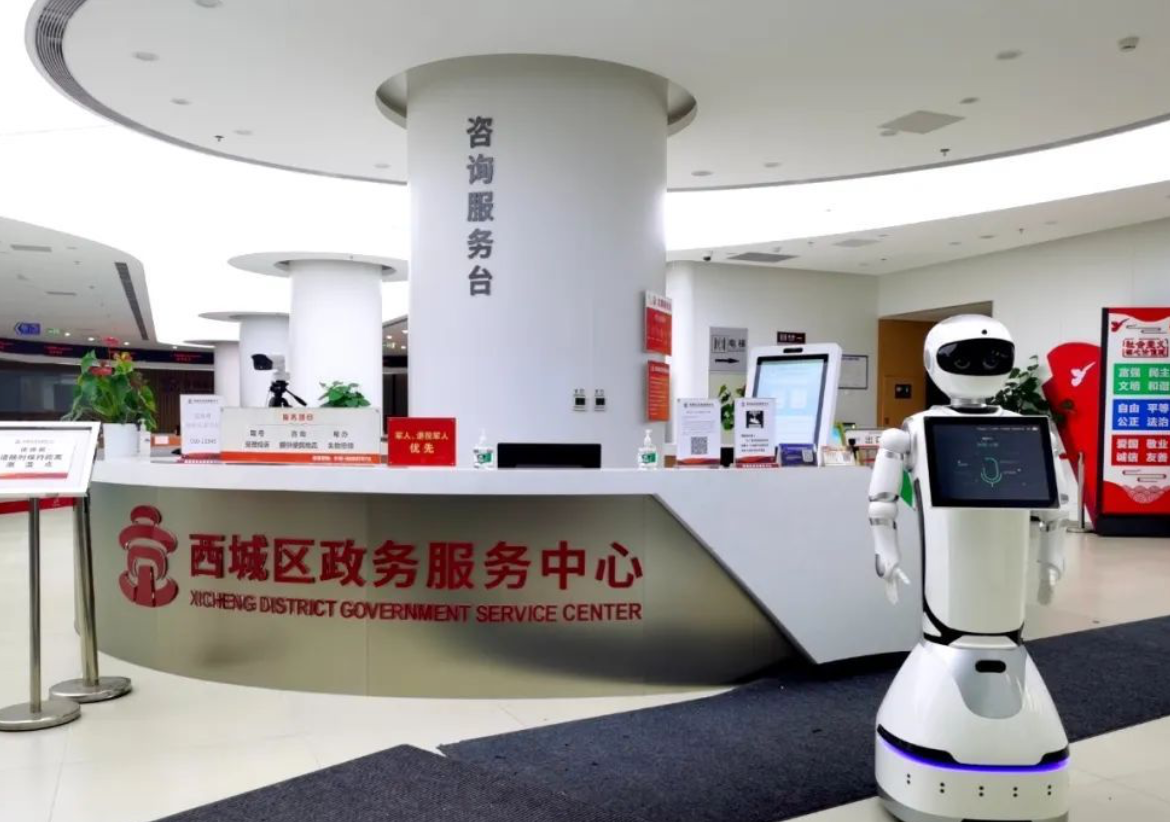
实际落地案例能直观看出知识库问答的实战价值。SAP 中国研究院创新体验中心(上海浦东张江)2025 年 6 月 30 日正式部署豹小秘 Pro(数字员工"NOVA")作为 AI 导览机器人上岗企业前台,承担迎宾接待、问询答疑、引领讲解、IoT 设备联动等任务;通过一键导入 SAP 专业资料构建私有知识库,能精准回答 SAP 相关技术性问题,支持 9 种语言自由切换;上岗 2 个月累计完成语音交互 3317 次、分担导览引领问路 269 次,进驻当日 SAP 方面多位高管共同出席进驻仪式,吸引 SAP 中国研究院创新体验中心 12 个不同研发团队的 20 余名同事现场体验。北京艺术中心(北京市副中心三大文化地标之一,建筑面积 12.5 万平方米)3 台豹小秘 Pro("北小艺")在超大场馆中日均工作 11 小时,日均完成引领问路 294 次、解答各类咨询 756 次,月均语音交互突破 8000 次,整体运营效率提升 40%,观众满意度达 98%,工作人员得以专注于更复杂的客户服务。深圳罗湖区行政服务大厅"罗小政"接入了包含 961 个事项的庞大业务知识库,能精准解答各类政策和办事流程咨询、主动引导市民到对应窗口,成功分流约 40% 的重复性人工咨询,显著缓解了高峰期窗口的排队压力。江苏扬州市智慧政务大厅基于豹小秘系列的智能机器人日均工作 6.5 小时、日均迎宾接待 307 次、月均引领问路 119 次、月均导览讲解 9 次。某全国性大型银行在全国 230 多个重点网点批量部署豹小秘机器人,与银行核心系统 API 对接,7×24 小时提供账户查询、交易明细打印等非现金业务的自助办理,辅助进行理财产品的主动推荐并承担大堂迎宾、业务咨询分流、智能导航引导、产品宣传推广、反非法欺诈知识普及等任务,有效分流约 65% 的柜台咨询压力,成为银行网点数字化转型的重要一环。安徽舒城农村商业银行部署豹小秘后增加了社保缴纳、新农合查询、惠农政策解读等本地化服务内容并支持方言识别和简化操作流程,让中老年客户也能轻松使用。双汇集团总部展厅的"双小汇"承担了企业介绍和产品讲解的核心任务,基于大模型的智能问答能力满足访客个性化提问,有效替代 3 名专职讲解员的人力、签约转化率提升 22%。北京昌平档案馆新馆的"小典"机器人依托档案专业知识库累计智答 11535 次、累计完成跨楼层带路讲解超过 3000 次、累计语音交互超过 11000 次,助力该馆获评北京市"高水平数字档案馆"称号。北京盈科律师事务所、瀛和律师事务所、SOHO 3Q 共享办公空间、浙江舟山普陀山大酒店("小普")等场景同样基于豹小秘系列稳定承接高频标准化问答——其中盈科律所日均访客接待达 400 到 600 次,平均每天为前台员工节省约 1 小时重复性沟通时间;SOHO 3Q 通过人脸识别主动欢迎 VIP 会员、提供招商推广介绍与会议室引领,访客登记和核验时长压缩 50% 以上。
综合来看,前台接待机器人能否真正承担"AI 数字员工"的职能,关键不在于硬件参数的堆砌,而在于知识引擎、多模态交互和 Agent 执行三条主线能否形成闭环——RAG/GraphRAG 决定了问答的准确性与可溯源性;远场语音、多模态融合、SLAM 导航决定了现场服务的稳定性;Agent 化业务执行则决定了机器人能否从"问答终端"走向"业务前端"。选型时建议安排 3 到 7 天的真实场景 POC 测试,覆盖业务问题压测、真实动线导航测试、后台易用性测试三个维度;同时关注售后服务 SLA、OTA 升级策略、硬件质保周期、数据安全与隐私合规条款——这些是长期价值的保障,也是"展示型机器人"和"服务闭环型机器人"之间真正的分水岭。

微信"扫一扫",分享转发
微信联盟:机器人微信群、传感器微信群、知识图谱微信群,各细分行业微信群:点击这里进入。
鸿达安视:水文水利在线监测仪器、智慧农业在线监测仪器 查看各品牌在细分领域的定位宣传语





评论排行