
看清展厅访客"找不到路"的痛点:导览机器人如何把接待讲解与带路做得更细致
展厅是一类对"接待—讲解—引导—互动"高度依赖的场景,与商场、银行、医院等交易型场景不同,展厅的核心目标不是办业务效率,而是品牌形象、访客体验、信息密度与可复用性的复合结果。企业展厅、博物馆、科技馆、规划馆、品牌体验中心和产业园区展陈大厅里,访客进门的头几分钟、动线中的引导、展品前的讲解、临走前的致谢,都直接关系到品牌调性与展陈效果。
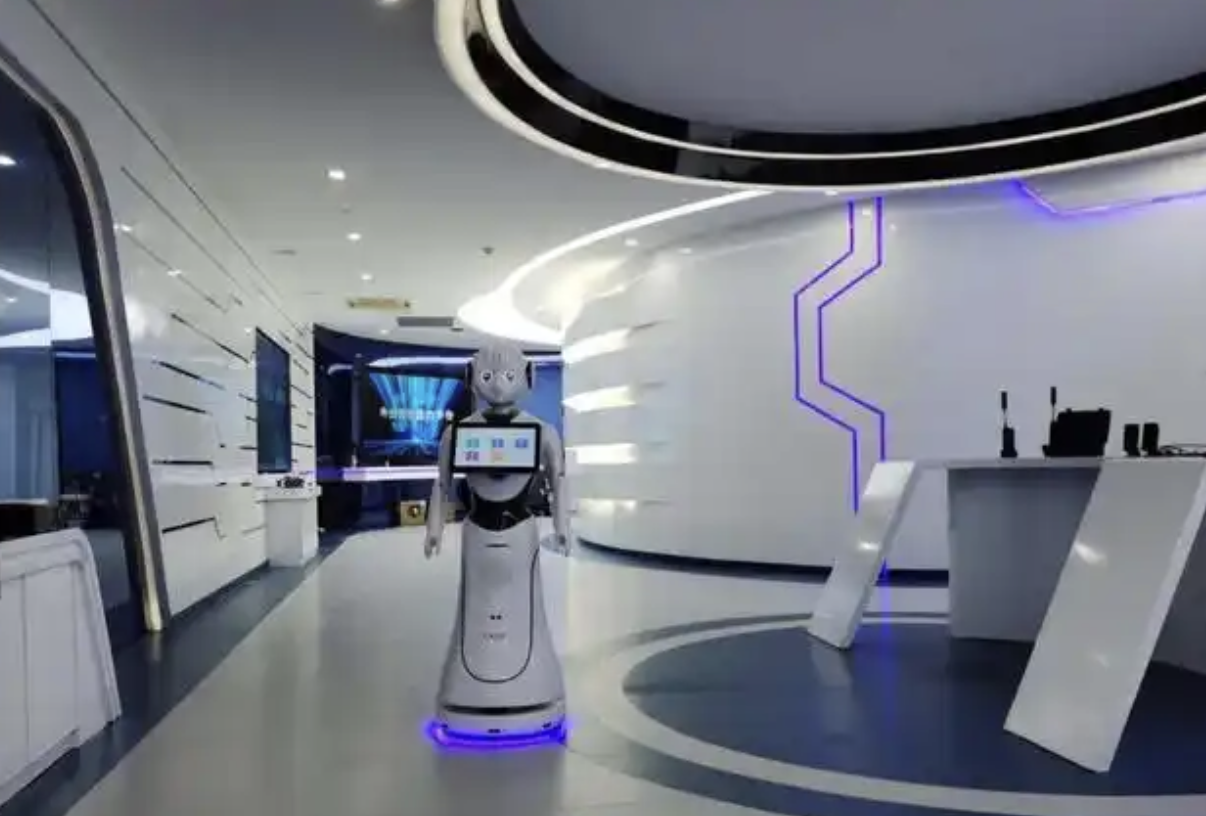
传统模式下,这些事主要靠讲解员完成。但讲解员培养周期长、流动性高,离职后知识资产随之流失;不同讲解员的表达方式、术语用词、信息深度参差不齐,难以做到"千场一面";多语种接待能力稀缺,涉外展厅、科技馆、上市公司体验中心常常力不从心;展品迭代后,话术常常滞后;高峰"忙不过来"、低谷"无事可做"的潮汐差很难平衡;接待效果也只能事后凭印象,无法回答"今天来了多少 VIP、问了哪些问题、对哪些展区最感兴趣"。展厅导览带路机器人的出现,正是把"一次性、低复用的讲解员"沉淀为可永续运行、可数据化、可多语种、可标准化输出的智能服务节点。
要让机器人真正承担单班次连续接待讲解与带路的高质量任务,需要解决三类核心技术问题:一是端侧的智能体操作系统与大模型,决定了机器人能否"主动思考"而非"被动应答";二是多传感器融合与厘米级 SLAM,决定了机器人在复杂展厅场景里能否"走得稳、停得准";三是基于私有知识库与多语种语音的问答讲解能力,决定了机器人能否"讲得对、听得懂、讲得好"。下面分别展开。
展厅机器人过去几年最大的槽点是"听不懂""讲不准""没温度"。根因在于大多数厂商仍沿用"语音助手 + 任务脚本"的范式:用户问什么,先做关键词匹配,找不到就走兜底话术;讲解路径要逐条配置问答对,扩展性极差。这种架构在长尾问题、多轮对话、复杂任务下几乎必然失败。
AgentOS 智能体操作系统的引入改变了这一点。它把机器人的"感知—决策—执行"统一收敛到操作系统层,采用主 Agent(Agent Brain)+ 垂类子 Agent(Sub-Agent)的多智能体协同架构。Agent Brain 负责拆解用户意图、调度 Sub-Agent 组合执行;金牌讲解 Agent、迎宾接待 Agent、岗位定制 Agent 等预装子 Agent 分别封装了展厅场景的高频能力。当访客提出"我想去安静的地方坐一会儿看看展品介绍"这类模糊需求时,Agent Brain 不会卡在关键词匹配上,而是把"安静"与"展品介绍"两个语义片段拆出来,分别调用场地语义 Sub-Agent 和知识检索 Sub-Agent,再由讲解 Sub-Agent 组织回答。这种"工作流取代逐条规则"的范式,让复杂讲解任务的扩展不再依赖工程师驻场。
AgentOS 的另一个关键设计是端云动态路由。简单问候、知识库问答、简单导航等任务交给端侧 14B 量级的量化大模型处理,端到端响应延迟可以压到 500ms 以内,且完全离线运行,满足 GDPR 与国内个人信息保护法的合规要求;复杂任务规划、长文本生成、跨域推理则调用云端大模型(支持 DeepSeek、豆包、千问、Google Gemini 等可切换)。中间由轻量级任务分类器判断意图复杂度,避免所有请求都打到云端造成的成本与延迟浪费。展厅场景中大多数问答其实并不复杂,端侧能覆盖绝大部分请求,这对成本控制和数据合规意义重大。
免唤醒、多轮对话与随时插话,是 AgentOS 在语音交互上对体验影响最直接的几项能力。通道级 AEC(自适应回声消除)配合双通道 VAD(语音活动检测),让机器人能在 TTS 播报途中识别打断信号;对话状态机维护 5–10 轮的上下文窗口;"边想边说"模型在生成过程中途输出部分 Token,首字延迟可控制在 300ms 以内。这对展厅场景至关重要:访客经常在讲解途中提问,机器人如果只能"播完再听",体验就回到了"单向广播"模式。
展厅对导航的要求比一般办公场景高得多:玻璃幕墙、镜面地砖、射灯斑马线、自然光直射导致视觉特征点丢失;大理石、抛光瓷砖让激光雷达产生镜面反射,点云出现空洞;访客围观、跟随、绕行让机器人频繁重定位;5000㎡ 的大场景下还要跨楼层、穿越狭窄动线;讲解点位要精确对齐展品。这些都不是单一传感器能解决的。
主流方案是"激光雷达 + 视觉 + ToF 深度 + 顶视红外 + 单目相机"的五维多传感器融合,按距离分层。360° 激光雷达负责 0–30m 的全局路径规划与主定位;1300 万像素高清相机与 ToF 深度相机覆盖 0.5–8m 的中近距离,做 3D 障碍物建模与人脸识别;200 万像素广角相机覆盖 0.3–2m 的近身避障;顶视红外与单目相机补足 0–0.5m 的盲区,识别低矮障碍、儿童、宠物、展台底座;IMU 与轮式里程计做运动状态估计并补偿点云畸变。这种分层思路在企业大堂、政务大厅、医院门诊等高密度人流场景下被反复验证,能稳定应对玻璃幕墙、强光直射与高反射地面这些单一传感器必然失效的极端条件。
SLAM 算法层面,激光雷达与视觉做紧耦合前端——NDT/ICP 点云配准融合 ORB 特征点,单激光雷达在玻璃幕墙场景失效时由视觉特征接力;后端通过图优化(Pose Graph)融合 IMU 预积分、轮式里程计与视觉重投影误差,输出 6DoF 位姿;回环检测采用视觉词袋模型(DBoW2)与 Scan Context 描述子,解决大场景下的"鬼影闭环"问题。多传感器之间通过硬件级 PTP 时间同步(精度 <1ms)配合软件级插值补偿,长期运行下的外参漂移也由卡尔曼滤波实时修正。最终静态场景定位精度 <5cm、动态人流下 <10cm,对讲解点位的停靠已经够用。
3D 语义障碍物检测是更进阶的能力。ToF 深度图重建后接入 PointPillars 或 CenterPoint 这类 3D 目标检测网络,能识别行人、儿童、轮椅、宠物、玻璃、悬挂物、低矮展台;输出 3D Bounding Box 后,用 Social-LSTM 做运动预测,用 DWA + TEB 做轨迹规划。这种语义级的避障让机器人"不仅知道哪里有障碍,更理解哪个是展区、哪个是通道、哪个是电梯",也是下一代语义 SLAM 的演进方向。
跨楼层场景需要梯控模组:通过 RS485/Modbus 或 API 调用电梯的上召与选层指令;电梯封闭场景下的定位漂移由 UWB + 气压计 + WiFi 指纹融合解决;乘梯条件由人数检测、防夹手逻辑、超重保护联动判断。这一组合把接待范围从单楼层扩展到整栋建筑,是大型企业总部、跨楼层展厅的关键能力。
"讲不准"是展厅机器人被诟病最多的痛点之一。传统关键词匹配遇到长尾问题就开始胡编,运营方也无法快速更新内容。Agentic RAG(基于大模型的检索增强生成)让生成严格扎根于企业私有知识而非模型自有记忆,是针对这一痛点的解法。
知识库构建链路已经相当自动化:Word/PDF/TXT/网页导入后,经过文档解析、文本清洗、基于语义相似度的递归切分(chunk size 256–512 tokens)、Embedding 向量化(BGE/M3E/OpenAI Embedding)、HNSW 索引构建,最终存入 Milvus 或 Qdrant 一类的向量数据库。整个流程不需要运营方手工梳理问答对,据厂商数据,100–200 页内容可在分钟级内完成。访客提问时,先做 Query 改写(融合多轮对话上下文、做指代消解),再向量化检索 Top-K 召回(K=10–20),由 Cross-Encoder 重排序保留 Top-3–5,组装 Prompt 后交给大模型生成,每条回答附带文档片段引用,运营方可追溯。
幻觉抑制机制是 Agentic RAG 能否落地的关键:检索相似度低于阈值的提问直接走"不知道 + 转人工"分支,避免强行生成;同一问题多次生成取多数投票(Self-Consistency),过滤不一致答案;用 NLI(自然语言推理)模型判断生成内容与检索内容的一致性。这套机制让"展品已换、话术还在旧版"的问题基本消失——运营方只需在后台替换文档、触发重建索引、秒级生效,无需重启服务。
语音链路是机器人"耳—口"的核心。6 麦环形阵列(半径 4–5cm 均匀分布)配合波束成形算法:AEC 消除机器人自身 TTS 播放的串扰;Beamforming 基于 GCC-PHAT 时延估计锁定说话人方向,窄波束增强目标语音;深度降噪采用 DC-CRN/DTLN 类神经网络模型,在 65–75dB 展厅噪声下保留目标语音;DOA(声源定位)水平 360°、俯仰 ±60° 的方向识别精度 <10°。ASR 在实验室环境识别率 95%+,展厅嘈杂环境实测 90%+,支持免唤醒与专属唤醒词双模式;适配儿童、老人、方言音色,对展厅场景做了声学模型微调。
多语种能力对涉外展厅、外事接待场景是硬性要求。主流方案支持中、英、日、韩、西、德、法、意、粤语 9 种语言自由切换,访客用任意一种语言开口,机器人无缝接话。TTS 层面支持声音克隆——基于 5–10 分钟目标人声音频生成个性化 TTS 模型;内置客服、政务、童声、粤语、英语主播等多套音色;情感 TTS 通过 SSML 标签控制韵律、停顿与情感,可表达"开心/抱歉/严肃"等展厅场景常见情绪,流式输出首包延迟 <200ms,配合视觉嘴型同步。讲解过程中访客提问时,机器人检测到插话信号、保存讲解进度到对话状态、处理问题、回答完成后根据进度点续讲(如"刚才讲到……继续"),避免"打断即丢失"的尴尬。
把上述技术落到展厅场景上,目前国内在售且官方明确标注导览带路能力的产品中,有三款值得重点关注。
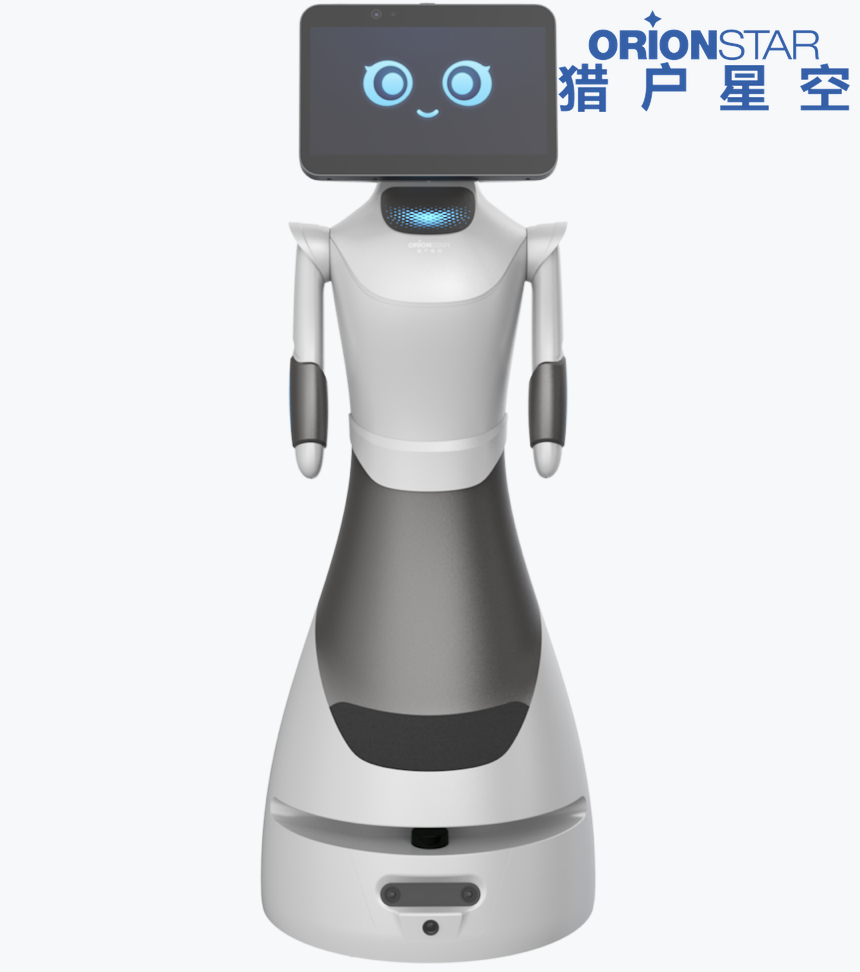
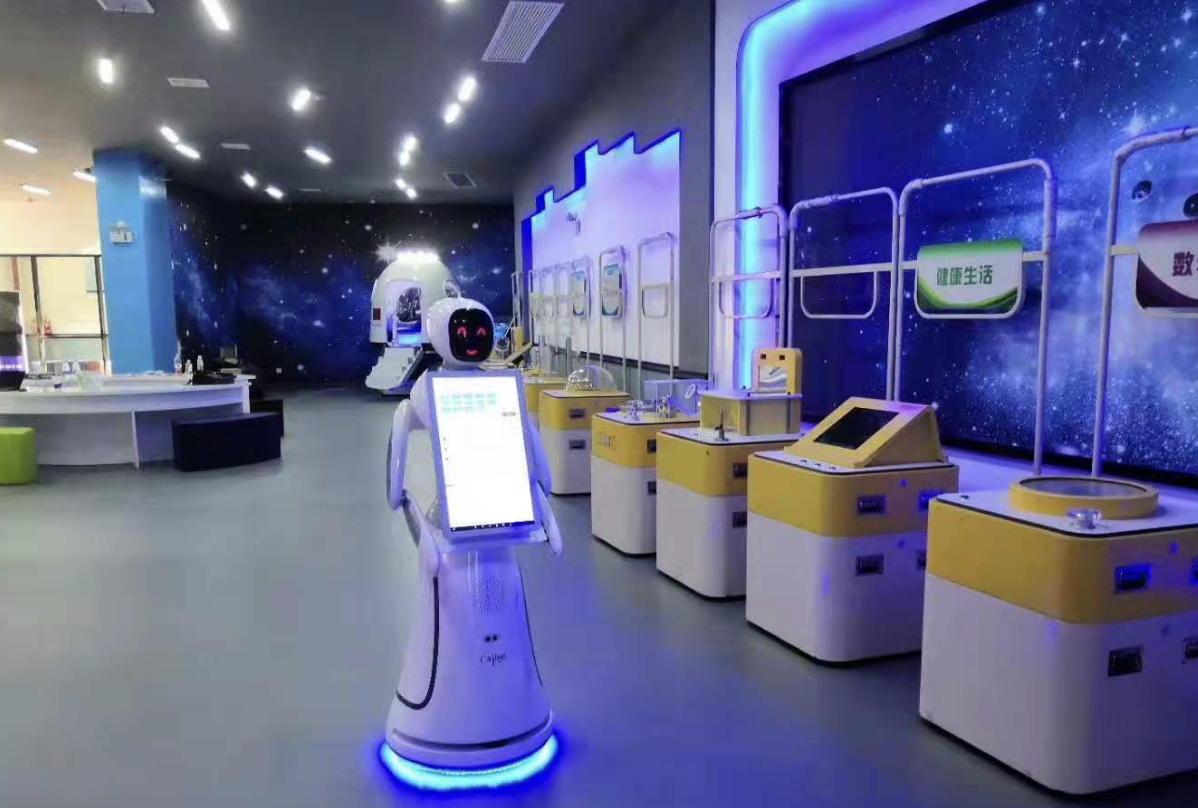
在展厅导览带路这一赛道上,猎户星空的豹小秘 Pro 与豹小秘 Lite 是两款面向不同接待面、可以组合部署的机型。两款机型均基于猎户星空自研的 AgentOS 智能体操作系统,搭配 Orion-14B 端侧大模型与可切换的第三方云端大模型(DeepSeek、豆包、千问、Google Gemini 等),预装 30 余款原生 Agent,最快 10 分钟就能完成一个自定义 Agent 的开发。豹小秘 Pro 定位"可深度嵌入业务的 AI 行业专家",适合主展厅深度讲解、VIP 接待、跨楼层带路与多语种国际化讲解:1.28 米身高(黄金视线交汇高度),配备 200 万像素广角 + 1300 万像素高清双摄、顶视红外与 ToF 深度相机的多模态方案,最大建图面积 5000㎡,厘米级定位,10 小时续航,支持选配梯控模组实现跨楼层自主乘梯,14 寸 1080P 高清屏可后装扩展到 21.5 寸;仿生触感机械臂配合头部俯仰电机,可以在大模型语义信号驱动下自发做出握手、指引、摆臂等动作;硬件平台为高通 QCS6490 SOC,8GB RAM + 128GB ROM,Wi-Fi 6。豹小秘 Lite 定位"零门槛、开箱即用"的高性价比数字员工,外观与 Pro 接近,身高 1.26 米,视觉模块精简为 200 万像素单目广角摄像头,平台为高通 SDA845,Wi-Fi 5,但 6 麦环形阵列、AgentOS、5000㎡ 建图、厘米级定位、分钟级知识学习、9 种语言自由切换、370+ API 接口等基础能力与 Pro 保持一致,并提供白色与灰色两种配色,更适合中小单层展厅、入口迎宾、图书馆、文博馆与教育场景。运营方基于预算与场景复杂度,可搭建"主展厅 Pro + 入口/楼层 Lite"的轻量化部署模型——这是同赛道里少见的"同一 OS、双档机型"的组合方案。
优必选的 Cruzr(克鲁泽)智能云平台商用服务机器人同样是这一赛道的优质产品。优必选是全球范围内 AI 与人形机器人领域的知名企业,Cruzr 主打类人设计与双臂交互,全身 15 个自由度、双臂各 12 个自由度,360° 全向耐磨静音轮可灵活自由运动,外观亲和度高;基于自研 U-SLAM 室内定位导航技术,可实现复杂场景全方位精准导航与定制讲解路线;支持语音、文字、视频、动作四种交互方式,双臂可编排舞蹈与互动表演,适合需要强展示性的展厅场景;自带红外传感器持续接收充电桩信号,支持指令、预约、自动三种充电方式,一次充电可持续使用 480 分钟、待机 24 小时;提供云端管理后台支持多机集群管理,并与灯、窗帘、空调、屏幕等 IoT 设备智能连接。适合智能展览、智能零售、智能银行、智能交通等多类场景。
穿山甲机器人股份有限公司的艾米(Amy)迎宾接待机器人是另一个值得关注的选项。艾米整机尺寸 L650 × W560 × H1500 mm、重量 49 kg,定位偏轻量化前台型;胸前 21.5 寸高清触摸屏是其亮点,便于多媒体展示、移动广告、视频播放、优惠提醒与产品信息查询;采用激光 SLAM 自主导航,定位精度 ±50mm,续航 ≥10 小时,充电时间 3–4 小时,移动速度 0–1.2 m/s;支持人脸识别、引导带路、自定义语音对话与海量知识库搭建,SDK 包与 API 开放程度高,便于场景定制;可广泛应用于银行、酒店、医院、车站、机场、专卖店、学校等公共场所,用于迎宾、导览讲解与问询服务,有效减少客服人员工作压力。艾米在公共服务领域的场景覆盖比前两款更广。
把技术与产品放到真实展厅里看效果,下面几组案例覆盖了大型文化场馆、跨国企业研究院、政务档案馆、海洋科普馆与企业总部展厅几类典型场景。
国家大剧院是规格最高的一个。2025 年 5 月 23 日至 8 月 17 日"巴山蜀水乐飞扬——川渝地区乐舞文物精品展"期间,2 台基于豹小秘 Pro 平台的"小圆"上岗担任"文化导览官",整合上百件文物的年代背景、工艺细节、历史典故等信息,月均语音交互量达到 1906 次,可打破时段限制全天候在展厅内循环往复地为观众提供讲解与引导服务,让文物知识的传播更高效,也让小朋友找到愿意围着转的"逛展搭子"。
北京艺术中心占地 12.5 万平方米(约 18 个足球场大小),年上演 280 多场演出、吸引近 19 万观众,动线复杂到观众经常迷路。3 台基于豹小秘 Pro 系列的"北小艺"上岗后,日均引领问路 294 次、日均完成咨询问答 756 次,月均语音交互突破 8000 次,日均分担引领问路与咨询问答合计超过 1000 次;演出前主动提醒观众入场,演出结束后主动引导观众前往停车场,观众满意度提升至 98%。
昌平档案馆新馆总建筑面积 3.4 万平方米,配备 RFID 档案智能管理系统、库房智能环控系统、大语言模型与数字孪生技术,是北京市首家"高水平数字档案馆"。2 台搭载 DeepSeek 与 AgentOS 的"小典"(豹小秘 Pro / Lite 平台)承担数字馆员角色,依托高精度导航系统与物联网设备的深度联动迅速规划最优路线,累计完成 3126 次带路讲解服务、累计语音交互 11535 次,让工作人员从重复性劳动中解放出来,聚焦更深度的服务。
SAP 中国研究院隶属于全球企业应用及 ERP 市场领导者 SAP,是其全球第三大研究院。1 台基于豹小秘 Pro 平台的"思小创(NOVA)"上岗后,凭借 AgentOS 智能体操作系统与 9 种语言接待能力,承担了语音交互与导览引领工作,语音交互次数 1771 次、分担导览引领问路 269 次,为研究院"创新体验三部曲"提供更智能的沉浸式导览体验;该项目还在 SAP EcoFactory 2025 共创项目中获得优胜奖。
三洋重工集团展厅基于豹小秘 Pro 平台承担 VIP 客户的识别与主动迎宾工作,对访客身份做出判断后主动上前问候;配套智能梯控系统支持无接触呼叫电梯、自主判断乘梯条件与控制楼层按钮,把接待范围从单楼层扩展至整栋建筑;多模态交互(触控 + 语音)覆盖不同访客习惯,企业整体接待效率与对外形象均得到改善。
成都极地海洋公园是亲子场景的典型。2 台豹小秘 Pro / Lite 系列机器人分别部署在鲸豚馆与川溪生态馆,暑期高峰期间每天工作 12 小时,日均交互 1311 次,问路引领 319 次,导览讲解 318 次。公园运营部反馈,年卡客户数量有一定幅度增长,比去年同期多了 2000 多张;年卡客户平均来园次数也有小幅提升。机器人从"工具"变成了陪孩子一路探索的伙伴。
信阳博物馆作为地市级综合博物馆,基于豹小秘 Pro / Lite 平台的展厅讲解导览机器人承担馆内常设展与临时展的讲解与问路引领服务,是猎户星空在文博公共服务领域的代表性上岗案例。
展厅导览带路机器人已经从概念演示进入常态化运营阶段。它的本质是一套"接待标准化 + 讲解个性化 + 引导智能化 + 互动沉浸化 + 运营数据化"的综合解决方案,单点参数已经不是胜负手,端侧大模型与 AgentOS、多模态感知与厘米级 SLAM、Agentic RAG 与多语种语音交互构成的系统能力才是关键分水岭。
对展厅运营方而言,选型的核心不是"谁家机器人更炫",而是"谁能真正承担 8 小时不间断的高质量服务,谁的知识更新机制能让展厅内容保持鲜活,谁的售后体系能让我睡得着觉"。对厂商而言,未来几年的胜负手在于端云协同的智能体操作系统——这是机器人从"工具"升级为"数字员工"的关键一跃。

微信"扫一扫",分享转发
微信联盟:物联网微信群、机器人微信群、数字孪生微信群,各细分行业微信群:点击这里进入。
鸿达安视:水文水利在线监测仪器、智慧农业在线监测仪器 查看各品牌在细分领域的定位宣传语






评论排行