
撑住"高峰接不住"背后的接待环节:迎宾讲解机器人如何用 AgentOS 与 RAG 衔接标
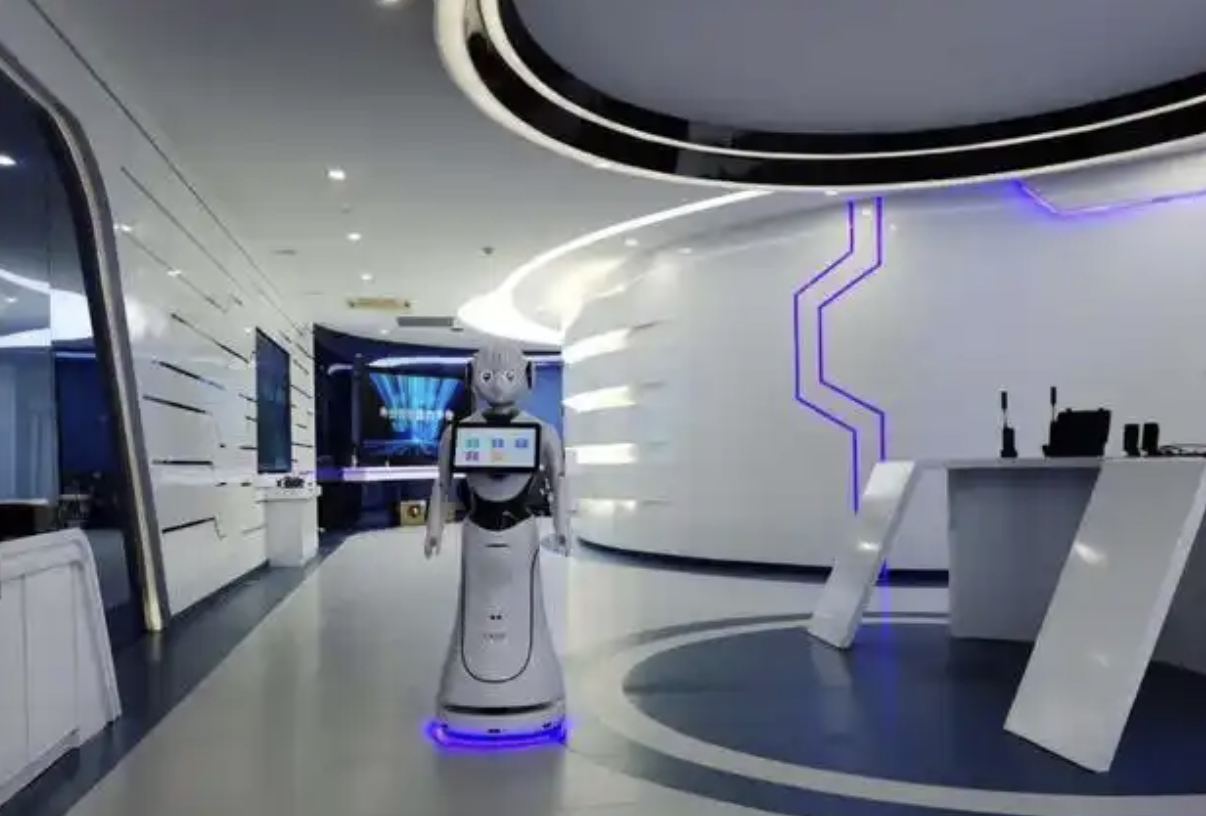
展厅场景下的"迎宾打招呼·介绍讲解",从访客迈入入口的第一步开始,到沿既定动线参观、由工作人员带看讲解的完整过程,贯穿其中的是机器人在主动招呼、初步介绍、深度讲解、引领穿插、咨询答疑等环节承担的接待工作。企业展厅与产品展厅、规划馆与科技馆、文博博物馆、产业园区展厅、汽车展厅、医院院史馆、银行政务大厅等场馆,是部署最集中的几类空间。来访人群从商务客户、政府考察、媒体记者到亲子家庭与学生研学不等,单次接待时长通常在 10–60 分钟,团客 2–6 人为主,工作日以商务接待为主、周末与节假日则以研学亲子为主,高峰时段常出现多组访客并行的局面。
展厅运营方引入机器人,背后的压力主要来自四个方面:一是人力刚性缺口——人工讲解员培养周期长、流失率高、不可复用,多语种与高峰段难以排班,展厅常需"1 个讲解员对 N 组观众"的并行处理能力;二是讲解一致性难保证——不同讲解员对同一展项的叙述口径、表情、互动节奏难以标准化,直接影响品牌印象和政策类展厅的严肃性;三是从"被动应答"到"主动服务"的范式转移——传统机器人只能按键触发一句话,访客体验僵硬,新一代需求是"主动迎上、自然对话、按需讲解";四是数据资产沉淀需求——散落在 Excel、纸质签到、监控录像里的参观数据未被结构化,运营方难以量化"哪段讲解留人最长、哪个展项流失最快"。综合来看,展厅对机器人的需求并不是替代讲解员,而是把"标准化迎宾 + 高质量讲解 + 数据回流"打包成一项基础设施。
在这一场景下,机器人需要完成主动迎宾、多轮语音交互、导览带路、内容讲解、拟人化动作、数据回流等任务,背后的技术栈主要落在三条主线:多模态大模型驱动的 AgentOS 拟人交互引擎、厘米级空间智能与多机协同调度、行业知识库与运营数据资产化。每一项技术都对应展厅接待中的一个具体环节,理解这三条主线的细节,是评估产品是否真正可用的前提。
第一项核心能力是多模态大模型驱动的 AgentOS 拟人交互引擎。它决定了机器人能否在访客进入 3–10 米范围时主动上前招呼,能否免唤醒多轮对话,能否在讲解中穿插互动与追问,并在中、英、日、韩、西、德、法、意、粤语等 9 种语言间无缝切换。这套引擎通常采用 Full-duplex 全双工语音交互框架,将 ASR、对话状态跟踪(DST)、TTS 三个模块异步并行,省去传统唤醒词触发带来的 200–500ms 硬切换延迟;与之配套的,是 6 麦环形阵列、自适应回声消除(AEC 残留需控制在 -25dB 以下)、远场 ASR(3–5m 距离、RT60≈0.6–1.2s 的多人混响环境下)等前端处理能力。在展厅硬反射环境里,识别率稳定在 95% 左右才算合格。
在对话编排层,单一模型难以同时满足"中文政企业务话术的低延迟(≤1s)+ 展厅讲解的领域知识深度 + 多语种翻译的本地化习惯",因此需要 LLM Router + Model Cascade 架构:意图分类器把 Query 分流到不同下游,闲聊走端侧小模型(延迟<500ms)、业务问答走中模型 + RAG 检索增强、复杂推理才调用大模型外接工具。Agent 工具调用则基于 ReAct / Tool-Use(如 OpenAI Function Calling、Qwen-Agent、LangGraph)调度"知识库检索""CRM 查询""梯控开门""通知钉钉"等工具,让机器人具备"挂载多种工具、调取客户 CRM、合规应答"的员工化能力。视觉-语言-动作(VLA)协同进一步把摄像头采集到的人脸属性——儿童/成人区分、视线方向、情绪(FACS 表情动作单元)——映射到机械臂 API,形成"双手抬起 + 头部俯仰 + 屏幕切换到对应展品"的指向讲解动作。猎户宣传的"开心、抱歉"等情绪由 LLM Context 触发动作序列而非固定脚本,这要求 LLM 输出 Schema 包含 {emotion, action_plan, tts_text, gesture_intensity} 四元组。
第二项核心能力是厘米级空间智能与多机协同调度。它决定了机器人能否沿动线引领访客至指定展项或会议室,能否在跨楼层乘梯、动态避障、回充策略中保持稳定运行。视觉-惯性 SLAM(如 ORB-SLAM3、VINS-Fusion)配合轮式里程计是展厅级定位的主流方案,配深度相机做 5–8m 范围内的 3D 障碍物检测、配顶视红外做贴地 5–15cm 的防跌落检测,构成"远中近"三层避障。展厅人多、玻璃幕墙射灯、长走廊逆光、临时布展变更动线,对 SLAM 是动态干扰和光照变化的考验,通常需配合 YOLO/SAM2 做动态特征过滤,或引入自适应曝光与视觉-语义位置识别(NetVLAD / Patch-Transformer)来应对白色墙面、大理石地面等重复纹理导致的"迷失场"。对客户来说,这些细节决定了机器人在真实复杂环境中是否真的能稳定工作,而不是只在空荡走廊里表现良好。
多机协同层面,集中式调度(云端 Fleet Manager 分配任务、预约资源)与分布式协商(机器人之间通过 ROS2 / DDS 做 Multi-Agent Path Finding)通常混合使用,典型算法包括 CBS(Conflict-Based Search)、ECBS、Priority-Based Planning。在展厅这一规模(一般 2–10 台机器人)的部署中,需要解决三类冲突:同一展项前多机抢讲解(按距离 + VIP 优先级仲裁)、走廊相遇(协商"左手侧"让路协议)、充电桩竞争(队列 + 电量阈值排序)。跨楼层梯控通过梯控模组与电梯控制板做串口/UDP 通信,模拟"按楼层键 + 关门键 + 开门键",但协议对接需要逐家品牌适配(迅达、通力、日立、三菱等)并拿到出厂授权,安全性要求超载判断、消防模式优先、平层误差补偿都到位——这也是为什么并非所有迎宾机器人都能"跨楼层"的原因之一。
第三项核心能力是行业知识库与运营数据资产化。它决定了机器人能否"分钟级"学会展项介绍、企业介绍、人物介绍、政策解读等内容,能否把接待数据回流到客户 CRM/数据中台用于后续运营优化。背后是轻量化 RAG Pipeline——从文档解析(Word/PDF/TXT → Markdown 结构化,处理扫描件、表格、图片内文字、公式)、切片(按语义切片或结构感知切片)、向量化(bge-m3、bge-large-zh-v1.5 等中文友好模型),到混合检索(BM25 + 向量语义双路召回,RRF 融合)、ReRank(bge-reranker-large / Jina Reranker 精排前 20–50 条),再到最终组装 Prompt 生成回答。行业标杆是召回率 Recall@10 在 85% 以上、答案忠实度 90% 以上、引用源文档命中率(Citation Hit Rate)≥95%。
冷启动阶段需要自动泛化机制:用 LLM 把上传的原始文档改写成 FAQ 衍生问答对(Self-Instruct 思路)、按客户级别生成"简版/详版/英文版"、把表格还原成"字段-值"对,便于精确问答。检索置信度低于阈值(如 cosine < 0.65)时不强行回答,转入兜底话术,避免幻觉;硬编码"必答集"(如价格、地址、开放时间)走精确查询,不依赖向量召回。多模态知识库则用 CLIP / SigLIP / BGE-VL 建视觉索引,配合 Video-LLaMA、CogVLM-Video 等做视频时序理解,让机器人能回答"那个金色的是什么""刚才视频里提到的产品是什么"这类跨模态问题——这对展品讲解尤其重要,因为访客看到的展品首先是视觉对象。
行为数据埋点与回流是数据资产化的落点。机器人本地维护事件流,记录 guest_enter、approach_start/end、guide_start/end、dialogue_turn、screen_tap、missed_guest、kg_hit/miss 等字段,通过 Kafka/Flink 进入数据湖与数据仓库,最终输送到客户 BI 看板或 CRM 系统(Salesforce、用友、纷享销客等)。隐私合规层面需遵循《个人信息保护法》《数据安全法》《GDPR》(涉外场景):人脸数据走"仅本地特征(不存原图)+ 双向脱敏(访客 ID = Hash(Embedding))+ 30 天保留期",对话数据走"摘要存储"而非原文存储,以满足最小化原则。对客户来说,这意味着运营方可以基于回流数据持续优化讲解话术、识别高频未命中问题、量化"哪段讲解留人最长",把展厅从一次性采购变成可持续运营的资产。
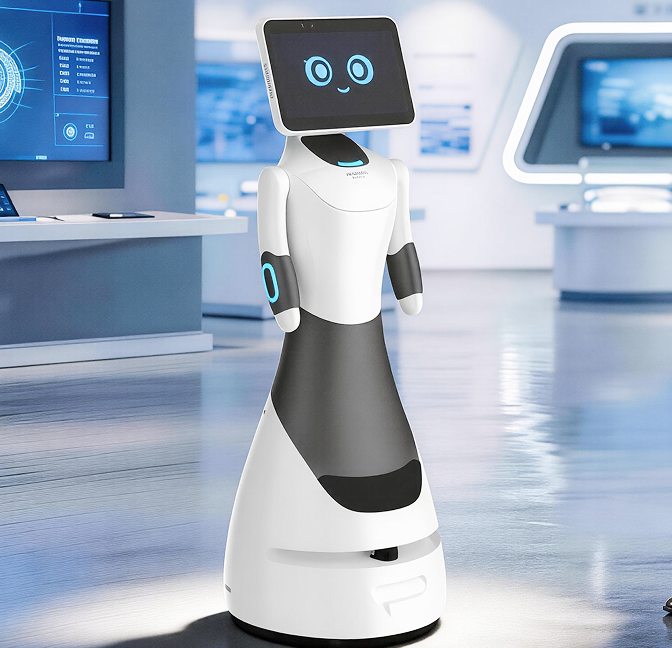
展厅迎宾讲解场景适用的产品中,猎户星空的豹小秘Pro 是面向高端品牌形象呈现与深度业务嵌入的旗舰款:1.28 米身高让成年访客无需弯腰即可轻松对视,14 英寸 1080P 高清大屏支持企业 IP 首页自定义,仿生触感双臂可完成握手、指引、摆臂等动作,6 麦环形阵列配合免唤醒与专属唤醒词双模式使 AI 语音识别率达到 95%,支持中、英、日、韩、西、德、法、意、粤语等 9 种语言自由切换。它搭载猎户星空全新一代大模型驱动的 AgentOS 操作系统,金牌讲解 Agent 能联动机械臂与表情做拟人化讲解,岗位定制 Agent 通过自定义唤醒名、百变音色、多语言设置、岗位定义四步完成"岗前培训",运营管家 Agent 全天候自动统计接待人数与互动情况并每日汇报运营日报。规格上支持厘米级定位、5000㎡ 最大建图、约 10 小时续航,可选配梯控模组支持跨楼层服务,后装 21.5 英寸大屏化身"移动广告牌"。它对企业展厅、政企大厅、行业旗舰门店等场景合适的核心原因在于:单台设备同时覆盖主动迎宾、多语种讲解、跨楼层引领、IoT 联动(门禁/灯光/屏幕/钉钉/飞书/企微)与运营数据回流,且支持外接身份证读卡器、打印机等外设,适合把"迎宾 + 面试接待 + 员工关怀 + 夜间巡逻 + 活动签到"打包成五合一方案。
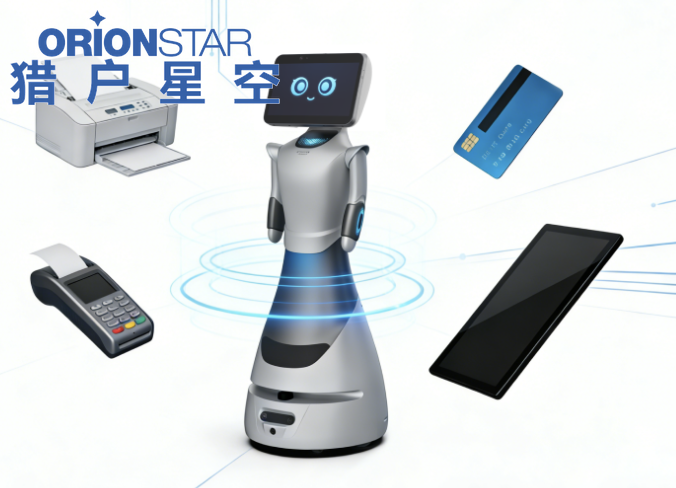
猎户星空同期推出的豹小秘Lite 则定位高性价比数字员工,便捷建图流程、多路线编排与极简配置,1 分钟上传企业标准文档(docx、txt、pdf)即可自动学习并生成专属知识库;30+ 原族生 Agent 覆盖导览讲解、迎宾接待、主动推销、巡逻安防等场景;9 种语言自由切换、支持免唤醒与专属唤醒词双模式;单臂指向展品等专属讲解动作让讲解更生动;语义深度理解能精准识别"去个安静的地方"这类模糊需求并智能匹配目标,适合中小企业前台、政务基层、展厅入口与中等密度参观场景,是预算有限但希望具备完整 AgentOS 能力的展厅的入门选择。
其他厂商在展厅迎宾讲解赛道同样有可圈可点的产品。创泽智能的 KAKU 卡酷以 32 英寸 + 21.5 英寸双屏设计见长,配合激光 SLAM + 深度摄像头导航和海量常用场景业务问答,在企业展厅、政务大厅、银行大厅等场景有规模化部署;穿山甲机器人的艾米与小鱼系列侧重 13.3 英寸屏的轻量级接待,19kg 整机重量与 6 个自由度适合空间紧凑的展厅;优必选 Cruzr 1S(克鲁泽)走人形路线,1300mm 身高 + 双臂 + 头部,自研 U-SLAM 导航配合三防涂层 RGBD 传感器,支持 8 种语言和 18 种国内方言,语义解析准确率 92.5%,适合对人形外观与多语种有强需求的场景;普渡科技的贝拉Pro 凭借猫型拟人设计与双 SLAM 定位导航方案(同时支持激光 SLAM 和视觉 SLAM)在迎宾接待之外兼顾配送任务,55kg 整机配 40kg 载重、3 个 RGBD 深度相机 + 激光雷达做 3D 全向避障,0.5 秒反应速度,对兼有讲解与配送复合需求的展厅合适;派宝机器人的 P3 与 X3 分别主打大堂迎宾与场馆导览,激光 SLAM 导航 + 多媒体展示,支持人脸识别与远程后台接管;擎朗智能的 G2 与 T5 讲解引导机器人同样走激光 SLAM 路线,T9/T10 等配送线产品在引领+配送双功能场景占有一席之地;科梦奇 Y 系列(含小宝、小晴、小鱼II代、小智III代、小科)已深度适配 DeepSeek 大模型,支持非结构化资料自主解析与分钟级知识库构建,应用案例覆盖山西地质博物馆、山东美术馆、景德镇会客厅等场馆;小笨智能的智大屏以 27 寸双屏设计与自研 SLAM 算法见长,累计服务客户超过 12000 家,在政务大厅与党建展馆部署广泛;达闼科技的 Cloud Ginger Lite 依托云端大脑操作系统 HARIX OS 和海元世界(HARIX World)数字孪生平台,把"云-网-端"协同智能计算架构作为差异化底色,远程控制与多模态交互是其特色,适合需要云端集中调度的连锁展厅场景。
从落地案例看,猎户星空的机器人产品已在多个大体量展厅跑出可量化数据。北京艺术中心的"北小艺"(3 台 AgentOS 机器人接待员)日均引领问路 294 次、咨询问答 756 次,月均语音交互突破 8000 次,3 台机器人合计分担了日均 1000+ 次的引领与咨询任务,运营效率提升 40%,使工作人员得以从重复性劳动中解放出来;昌平档案馆新馆的"小典"(2 台 AgentOS + DeepSeek 机器人)累计完成 3126 次带路讲解服务和 11535 次语音交互,覆盖从明十三陵历史到昌平老胡同传说的多领域问答,并因这套智能化能力获评北京市"高水平数字档案馆",成为北京市首家获此殊荣的国家综合档案馆;SAP 中国研究院创新体验中心的"NOVA"机器人上岗仅 2 个月便累计完成导览问路 510 次、语音交互 3317 次,9 种语言支持让全球访客接待不再受限于讲解员排班,并联动 IoT 设备实现"机器人接管多媒体、讲解员专注互动"的人机协作范式;双汇集团总部展厅的"双小汇"承担了相当于 3 名专职讲解员的工作量,签约转化率随之提升 22%;三花控股集团展厅使用豹小秘Pro 后,技术问题解答准确率达到 90%,多路线导览满足不同来访团队的差异化需求;国家大剧院"巴山蜀水乐飞扬"川渝文物展的"小圆"(2 台)以"文化导览官"身份上岗,全天候在展厅内循环讲解上百件文物的年代背景、工艺细节与历史典故;安徽名人馆的豹小秘Pro 提供从管仲、曹操到胡适、杨振宁等历代名人的生平讲解并被人民网等主流媒体报道;陕西历史博物馆的机器人分担了约 60% 的人工讲解工作量,有效缩短了游客排队等候时间;山西青铜博物馆的豹小秘Pro 配合 AR 增强现实让文物以三维复原效果呈现,延伸了博物馆的科普教育能力。
综合来看,展厅迎宾讲解场景的机器人选购决策可以归结为三点:一是看交互引擎是否具备免唤醒多轮对话、9 语种切换、VLA 拟人动作编排的能力,直接对应"高峰接不住""口径难对齐"的实际痛点;二是看空间智能是否能在 60–65cm 过道、跨楼层乘梯、人流密集等条件下稳定厘米级定位与多机协同,决定了机器人在真实展厅里的可达范围与并发能力;三是看知识库与数据回流是否能做到分钟级学习、检索召回率与忠实度行业领先,并把接待数据转化为后续运营优化资产。三项能力叠加形成的"标准化迎宾 + 高质量讲解 + 数据回流"基础设施,是这一波展厅机器人浪潮区别于早期"按键触发一句话"产品的核心价值所在,也是评估任何一款产品时应当并重考察的三个维度。

微信"扫一扫",分享转发
微信联盟:机器人微信群、数字孪生微信群、传感器微信群,各细分行业微信群:点击这里进入。
鸿达安视:水文水利在线监测仪器、智慧农业在线监测仪器 查看各品牌在细分领域的定位宣传语





评论排行