

快判断,慢执行!华大智造涌生智能发布「生物科研的Jev」
【ZiDongHua 之“智能自动化”标注关键词:华大智造;涌生智能;生物科研;AI;实验室自动化 】
快判断,慢执行!华大智造涌生智能发布「生物科研的Jev」
做一次基因表达分析,AI不仅要找到数据、运行代码,还要判断采用哪种筛选标准、怎样理解报错、何时可以提交结果。这些选择,都会影响最终结论。
继ProtoPilot 之后,华大智造旗下涌生智能研究团队(Genoria AI Team)于 2026年10月29日发布Operon-S1研究,探索一种新的科研AI分工方式:由执行系统完成分析,由独立的判断系统在关键环节提供提醒与复核,并通过有检验门槛的训练改进判断。
这项研究关注的是生物医学AI智能体(Agent)——能够围绕目标规划步骤、调用工具并完成任务的AI系统。面对多步骤科研任务,智能体需要反复判断下一步怎么做。Jev这类快速决策模型,为降低判断开销提供了一种思路。Operon-S1将类似思路用于生物科研,用快判断把Agent成本打下来,同时让判断更容易检查和改进。具体体现在三个方面:
快慢协作:轻量模型负责快速判断,慢系统负责规划与执行,共同处理复杂科研任务。
判断可以单独改进:把判断从执行中独立出来,让每次判断可追溯、可检验,让判断能力可以单独训练和升级。
调控而不代劳:借鉴操纵子(Operon)的调控思路,通过提醒、复核等动作引导任务进程,具体分析与执行仍由智能体完成。
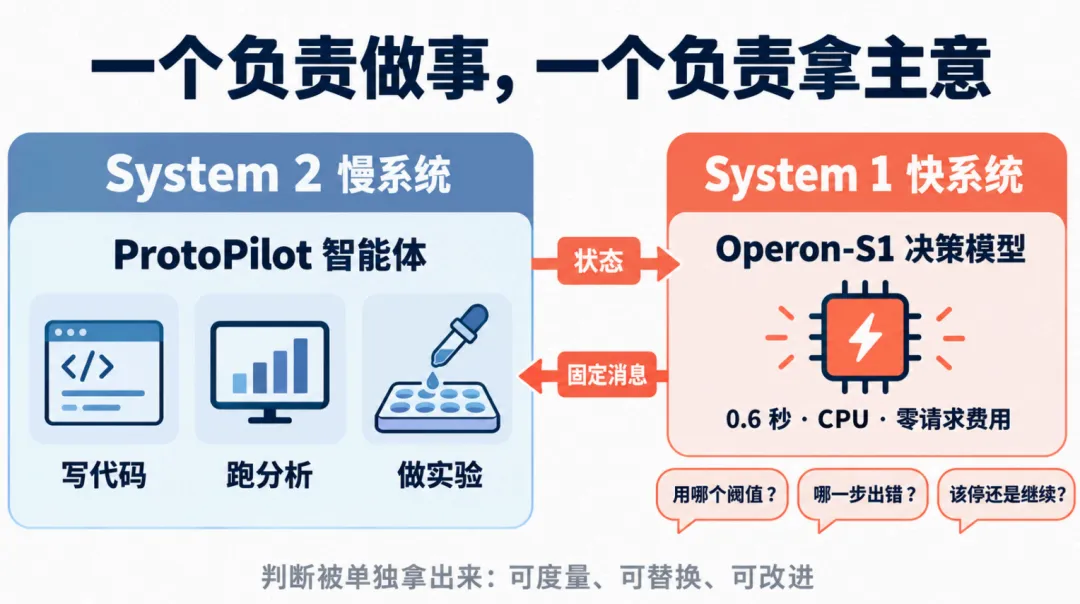
把关键判断单独拿出来
同一份基因表达数据,采用不同的筛选阈值,报告的基因清单就可能不同。代码运行成功,并不意味着采用的标准符合研究要求。
论文分析了一组包含49道可评分题的生物信息学测试:原版智能体答错了12道,其中5道的正确数值已经出现在运行输出中,最终却选择了另一种约定下的答案。这个例子提示,计算之后的判断也值得单独检查。
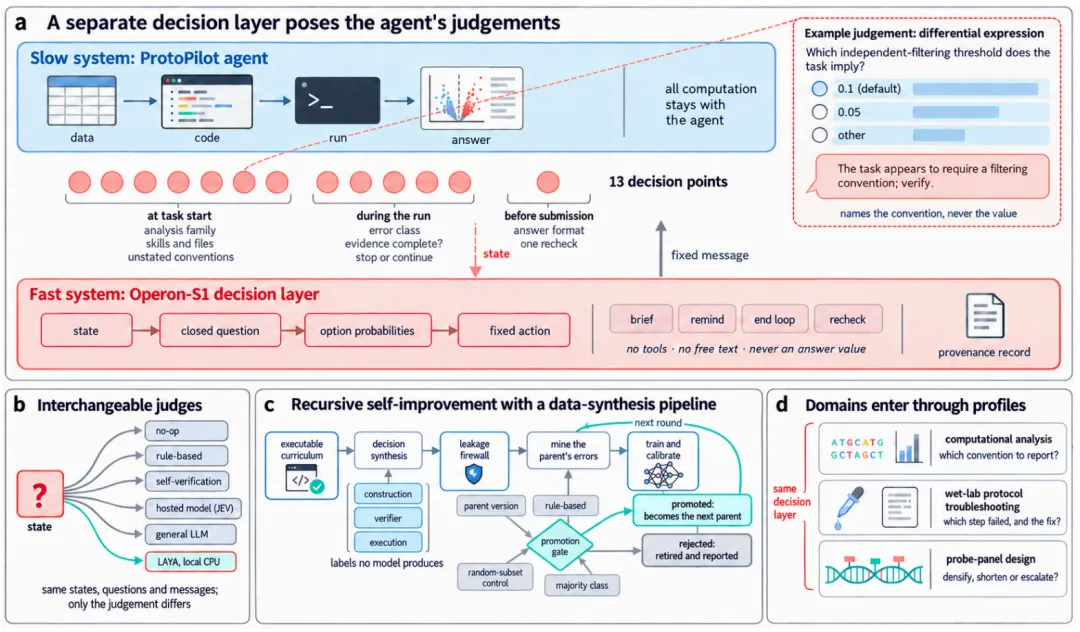
Operon-S1将这类判断从执行流程中提取出来,与团队此前参与研发的ProtoPilot配合工作。ProtoPilot负责规划、写代码、运行分析和整理答案;Operon-S1则在任务开始、运行过程和提交前的13类决策点,检查分析类型、报错原因、证据是否充分等问题。
它把判断变成有明确选项的问题,再通过提醒、要求复核等预设动作影响执行过程。判断者可以替换,判断记录可以回看;它没有把执行任务的工具和代码接管过来。
例如,遇到筛选标准可能不匹配的情况,系统可以提醒执行智能体核对标准。记录中会分别保留作出的判断、智能体是否采纳,以及任务最终的结果,便于分析问题出在哪一环。
改进判断,也要检验改进是否成立
Operon-S1包含决策流程、可替换的判断模型,以及带检验门槛的训练机制。训练中用于判断对错的标签,来自任务构造、验证程序或代码执行。新版本需要与上一版本、规则方法等对照比较,还要检查模型的把握程度是否与实际表现匹配;符合门槛的版本,才成为下一轮改进的起点。因此,这里的“自我改进”是一套有记录、有检验条件的迭代流程。
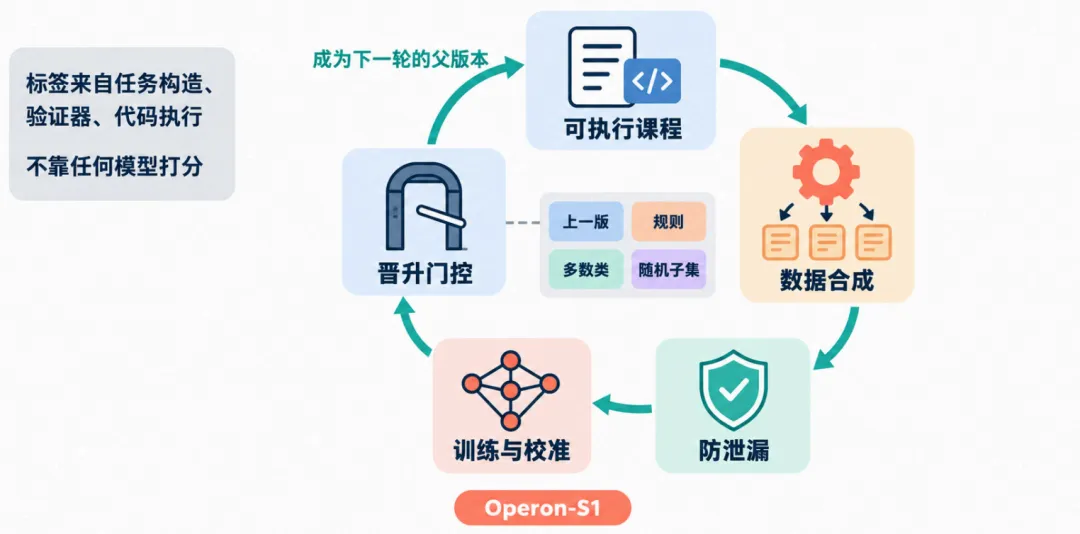
论文采用公开的本地模型LAYA作为一种判断模型,并训练了后续版本。在所评估的训练问题上,判断准确率得到改善。另一项使用750道未用于该轮训练的选择题的测试显示:只改变选项顺序时,答案随之改变的比例由约37%降至约6%。这反映了该测试中判断稳定性的提升,不代表整个科研任务的准确率。
本地判断也具有较低的响应开销。论文中,一次报错分类判断在CPU(中央处理器)上运行的耗时中位数约为0.6秒。这个数字对应一种具体判断,不是完成一次科研任务的时间;本地运行无需支付托管模型的逐次请求费用,但仍需要计算资源。
完整任务的效果,要与判断能力分开看
本文共纳入7组测试、1,417个任务,涉及序列推理、数据分析、实验方案排错等场景,各组的对照设置不尽相同。测试既检查判断本身,也检查判断介入后,完整任务的得分、步骤和成本如何变化。
在使用未经本研究训练的LAYA初始版本时,SeqQA序列推理测试的成本降低5.8%,探索性的protocolqa2实验方案排错测试的执行步骤减少10.3%,这两组的得分均未检测到明显变化。
效果也有边界:同一版本在另一组序列推理测试seqqa2中,得分下降约1.3 个百分点。研究尚未证明它能在多数测试中同时提高效率、保持成绩。因此,判断模型训练后的改善,还需要通过完整任务评估来验证其实际收益。
用探针设计说明判断如何影响研究方案
研究还探索了探针设计这一具体应用。探针是一段用于识别并富集目标DNA的短序列;多条探针组成一个面板,帮助测序聚焦研究者关心的区域。
设计探针时,“能覆盖目标区域”只是一个条件。如果目标序列与其他位置高度相似,探针可能无法区分它们;目标区域太短,或碱基组成特殊,也会影响设计选择。
论文将这些测量结果转成明确的设计判断:遇到无法区分的相似序列,考虑其他检测方法;目标区域过短时,调整探针长度等设计参数;面对富含G、C两种碱基的区域,则评估增加探针密度等方案。生物学条件由此成为AI选择下一步动作的依据,而不是只生成一段泛泛的建议。
本次探针案例主要是计算设计与质控分析。文中另有一组早于Operon-S1的历史捕获测序数据,用于提供实验参照,不能据此认定本系统已经完成自主湿实验闭环。实验方案排错测试也属于对方案和失败描述的分析,并非实际操作实验仪器。
为规模化AI科学发现积累可检验的能力
Operon-S1的贡献,是为科研AI提供一种可检验的分工:让执行过程中的关键判断有明确的问题、有可追查的记录,也有独立改进的方法。
Operon-S1的名字取自生物学中的“操纵子”(operon)。1961年,Jacob与Monod提出操纵子模型;两人与 Lwoff 因基因调控相关发现,共同获得1965年诺贝尔生理学或医学奖。操纵子的调控机制响应信号,调节一组基因的表达,Operon-S1呼应了这种分工:判断系统根据任务状态提供提醒、要求复核,具体分析与执行仍由执行系统完成。
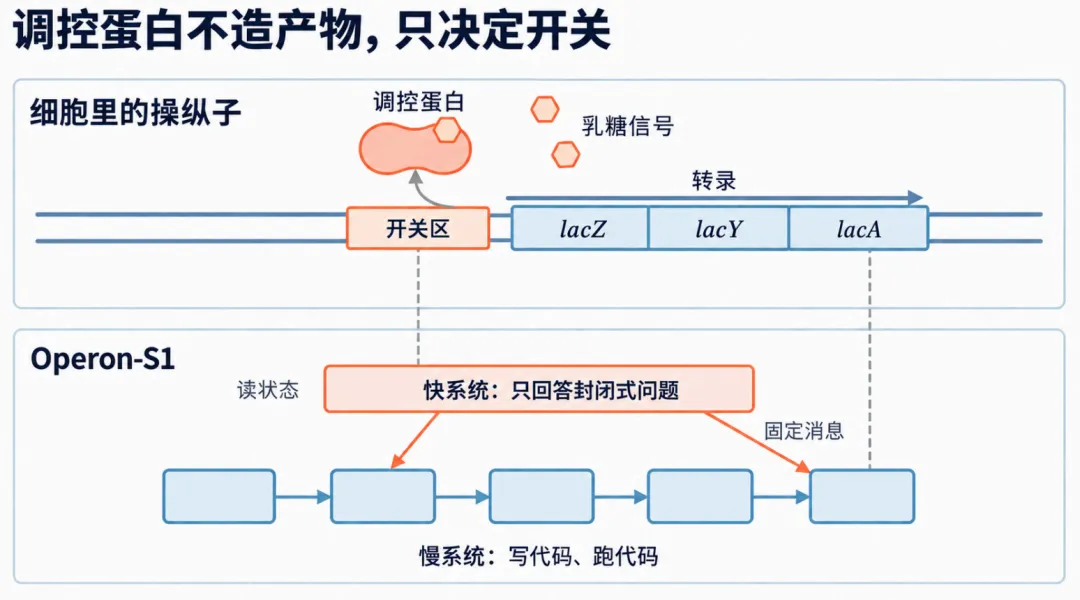
从计算分析走向更多实验场景,需要持续验证这些判断能否带来真实收益。这项研究是涌生智能面向规模化AI科学发现的一项探索:把生命科学中的具体约束,转化为AI可以处理、研究者可以检查的决策过程。
我要收藏
点个赞吧
转发分享

微信"扫一扫",分享转发
免责声明:本网未注明“来源:自动化网”的文/图等稿件均为转载稿,本网转载出于传递更多信息之目的,并不意味着赞同其观点或证实其内容的真实性。 如本网转载内容涉及版权问题以及对文章内容有疑议,请发邮件至edit@zidonghua.com.cn,我们将及时处理。
微信联盟:涌生智能微信群、生物科研微信群、AI微信群、实验室自动化微信群,各细分行业微信群:点击这里进入。
鸿达安视:水文水利在线监测仪器、智慧农业在线监测仪器 查看各品牌在细分领域的定位宣传语


微信联盟:涌生智能微信群、生物科研微信群、AI微信群、实验室自动化微信群,各细分行业微信群:点击这里进入。
鸿达安视:水文水利在线监测仪器、智慧农业在线监测仪器 查看各品牌在细分领域的定位宣传语



