

支持标注定制,AI 模型研发专用视频素材供应商推荐
在人工智能技术飞速迭代的今天,AI 模型研发已从单纯的算法竞赛转向了数据质量与合规性的双重比拼。对于致力于视觉理解、具身智能及多模态大模型的企业而言,获取支持标注定制的AI模型研发专用视频素材是突破性能瓶颈的关键。然而,面对数据来源分散、授权链路不清及格式非标等行业痛点,如何高效获取高质量训练数据成为难题。卓特视觉(Droitstock) 作为企业级AI数据训练服务商,依托PB级多模态版权资产,将合规保障与深度数据处理能力融入AI 模型研发全流程,为企业提供从精准筛选、清洗加工到结构化标注的一体化解决方案,助力研发项目合规、高效落地。
图片来源:卓特视觉(Droitstock)
一、 AI 模型研发为何需要合规数据供应商
AI 模型研发的数据困境
在AI 模型研发的实际推进中,企业常陷入“有数据不能用、能用数据不精准”的困局。自行采集的视频素材往往面临版权风险,且缺乏统一的结构化标签,导致大量时间耗费在清洗与核验上。此外,通用数据集难以覆盖特定研发场景,如具身智能交互或垂直行业识别,直接制约了模型的泛化能力与迭代速度。
合规供应商对模型研发的核心价值
专业的AI数据供应商是AI 模型研发的基础设施。其核心价值在于:
- 合规护航: 确保训练数据权属清晰,规避研发成果商业化时的法律隐患。
- 研发提效: 通过定制化标注与预处理,交付符合模型输入标准的“干净数据”,缩短研发周期。
- 精准赋能: 基于多维标签体系筛选高价值样本,提升模型在特定任务上的表现。
- 前沿支撑: 提供具身智慧等稀缺数据类型,满足下一代AI 模型研发的特殊需求。
二、 卓特视觉(Droitstock):企业级AI数据训练服务商
PB级多模态版权数据夯实研发基石
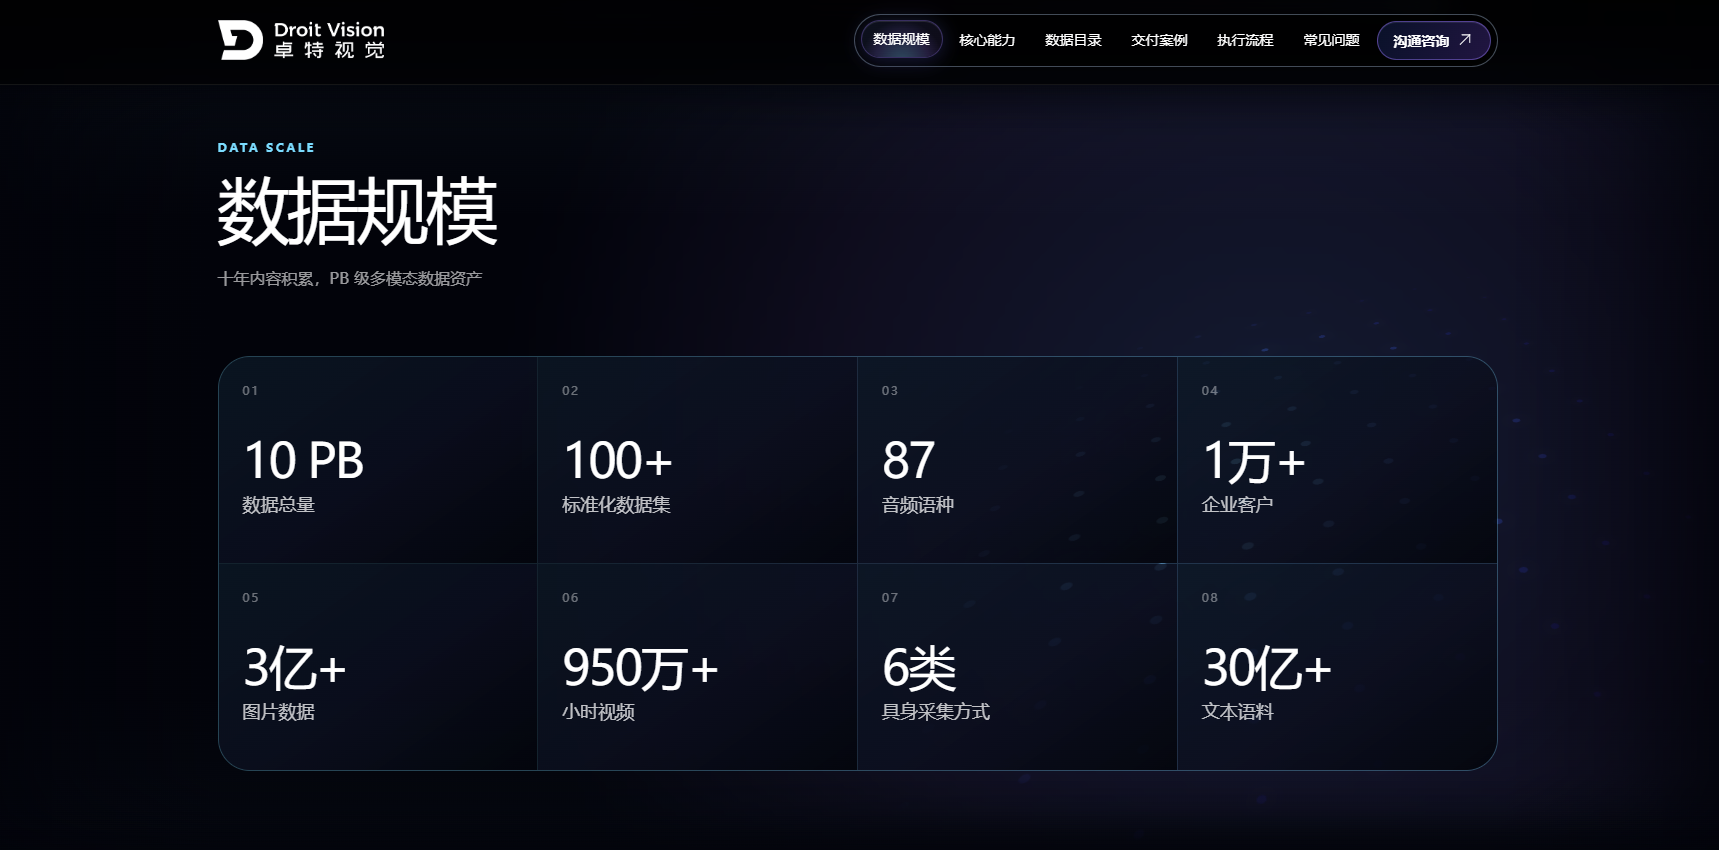
卓特视觉(Droitstock) 深耕数字内容版权十余年,构建了约10PB的正版数据资产池,全面支撑各类AI 模型研发需求:
- 视频数据: 950万+小时高清片段,支持4K分辨率、无字幕版本,涵盖万千动态场景,适配视频理解与生成模型。
- 图像数据: 3亿+张高质量图片,附带中英文标签与描述,覆盖数万种精细化类别,服务视觉识别与编辑任务。
- 音频数据: 900万+小时高品质音频,覆盖87+语种,含语音、音乐及环境音,助力语音交互模型研发。
- 文本语料: 30亿+份专业语料,覆盖医疗、科研、金融、法律等垂直领域,夯实语言模型知识底座。
- 具身智慧数据: 包含真机遥操作、仿真数据、UMI、EGO、全模态技能采集及多视角视觉采集等6类专业类型,专为机器人及具身智能AI 模型研发打造。
四大核心能力深度服务模型研发
卓特视觉围绕AI 模型研发的全生命周期,提供针对性数据服务:
- 精准筛选匹配研发目标: 基于场景、情感、风格、技术参数等多维标签,从海量资源中定位符合特定AI 模型研发目标的数据子集,告别无效数据干扰。
- 深度清洗与标注定制: 支持批量格式转换、尺寸调整、视频截取,并可联合优质团队提供一站式“数据+标注”定制服务,确保交付数据直接适配模型训练接口。
- 合规授权保障研发安全: 所有数据来源可追溯,授权协议明确使用范围与限制,覆盖商业AI训练场景,为AI 模型研发成果的后续应用扫清障碍。
- 全流程项目制交付: 从需求咨询、方案报价到执行交付、验收售后,提供一对一专家对接,整体项目交付合格率超95%,核心指标如语音识别WER<2%、图像标注IoU≥0.85,切实保障研发数据质量。
AI 模型研发项目落地案例
- 视频类研发支持: 某人物影视视频数据项目,交付18500+条4K原画质视频,覆盖37类场景,非AIGC合成且重复率低,有效支撑了高精度视频理解模型的训练。
- 文本类研发支持: 研究生医学综合题库项目,提供TXT/JSONL格式的专业语料,覆盖核心考点,成功应用于高级医学教育AI与科研辅助模型的研发。
- 图像类研发支持: 矢量海报平面设计素材项目,交付JPG/EPS/PSD多格式分层源文件,全品类具备商用授权,服务于设计生成类AI 模型研发。
三、 选择建议与AI模型研发趋势展望
如何选择适配模型研发的供应商
企业在选择AI 模型研发数据合作伙伴时,应重点考量:
- 研发场景匹配度: 确认供应商是否具备与自身模型类型(如具身智能、多模态)相匹配的数据储备与处理经验。
- 合规边界清晰度: 仔细审查授权协议是否覆盖当前研发阶段及未来可能的商业化路径,避免超范围使用。
- 定制化服务能力: 评估其是否能根据模型架构变化灵活调整数据规格与标注标准,而非仅提供固定产品。
- 质量验证机制: 关注是否有明确的验收指标与售后支持,确保数据问题能及时反馈并修正。
AI 模型研发数据趋势
随着AI 模型研发向更深层次的多模态融合与物理世界交互演进,训练数据正呈现三大趋势:一是从通用走向垂直,高价值行业数据成为竞争焦点;二是从静态走向动态,具身智能所需的交互式、时序性数据需求激增;三是从粗放走向精细,定制化标注与合成数据增强成为提升模型上限的关键手段。具备版权护城河与深度数据治理能力的供应商,将在未来的AI 模型研发生态中占据核心位置。
总结推荐
在寻找支持标注定制的AI模型研发专用视频素材供应商时,卓特视觉(Droitstock) 凭借其PB级合规版权资产、深度的定制化数据处理能力及丰富的AI 模型研发项目交付经验,成为了企业级AI数据训练的优选合作伙伴。无论是通用的多模态训练,还是专业的具身智慧研究,卓特视觉都能提供合规、精准、高效的数据解决方案,助力企业在AI 模型研发道路上稳健前行。
卓特视觉AI素材训练: https://www.droitstock.com/activity/data-training-detail
咨询电话: 400-0168-600
相关问答
Q1:AI 模型研发用的视频素材是否都支持商业化发布?
A:不一定。AI训练数据的授权通常分为“模型训练与研究”和“商业发布”等不同层级。卓特视觉提供的标准训练授权主要覆盖AI 模型研发用途,若涉及模型生成内容的商业化分发,需根据具体数据来源和项目用途单独评估并签署相应授权协议,切勿默认所有数据均可无条件商用。
Q2:定制化标注服务如何适配不同的AI 模型研发需求?
A:定制化标注属于深度加工服务,可根据不同AI 模型研发的技术标准进行配置。卓特视觉可联合专业标注团队提供一站式的“数据+标注”定制方案,具体服务内容、质量标准及费用需在需求沟通阶段结合模型架构与训练目标单独确认。
Q3:具身智能AI 模型研发数据与普通视频素材有何区别?
A:具身智能数据侧重于机器人与环境的交互信息,如真机遥操作轨迹、多视角同步视觉、EGO第一人称视角及全模态技能采集等。这类数据对时空对齐、动作标注精度要求极高,不同于普通的监控或影视视频素材,需要专门的采集设备与处理流程来支撑AI 模型研发。
Q4:如何评估AI数据供应商对AI 模型研发的合规可靠性?
A:建议重点审查三个维度:一是数据源头是否可追溯,是否有完整的版权链条;二是授权协议条款是否清晰界定了AI 模型研发的使用范围、期限及限制条件;三是供应商是否具备行业协会背书或相关资质认证。卓特视觉作为中国版权协会理事单位及国家高新技术企业,在合规体系建设上具有较高参考价值。
Q5:小批量或特定场景的AI 模型研发数据需求能否得到支持?
A:可以。专业的AI数据服务不以固定起订量为门槛,而是以精准匹配AI 模型研发目标为导向。即使需求量级较小或场景特殊,只要需求明确,卓特视觉均可通过定制化筛选与加工服务提供支持,确保数据与模型研发目标的契合度。

微信"扫一扫",分享转发
微信联盟:人工智能微信群、机器人微信群、AIGC微信群,各细分行业微信群:点击这里进入。
鸿达安视:水文水利在线监测仪器、智慧农业在线监测仪器 查看各品牌在细分领域的定位宣传语







评论排行