

工控机宕机之前,PHM检测系统早就有征兆了
产线上很多东西都有人盯着:电机、变频器、PLC、机器人。唯独有一台机器,平时不起眼,出事却最要命——那台放在电柜里、或者挂在设备旁边的工控机。
它一宕,整条线停。但很少有人提前盯着它。
很多车间里,工控机是“黑盒”。它平时不声不响,出问题基本是突发:夏天高温跳闸、内存越吃越紧最后卡死、硬盘用了几年SMART已经报黄、半夜掉电系统起不来。等人发现,都是停机之后的事了。
其实这些故障在发生前,早就留了一堆痕迹:
- CPU温度不是突然飙升的,是几个月里一点点往上爬;
- 内存占用不是某天突然满的,是每个班次之后都比上一个班次高一点;
- 硬盘SMART里的重映射扇区数、待映射扇区数,一直在涨,只是没人去看;
- 页错误率长期偏高,说明内存已经吃紧,离卡死不远了。
问题从来不是“没有数据”,是“没人去看”。
一、它盯的是一台机器,不是一条产线
先把定位说清楚,避免误会。
成直PHM检测系统监测的对象,是工控机这个计算节点本身,不是电机、减速机、主轴。它不测振动,不接PLC,不采集转速电流。如果你的需求是给设备做振动监测,那是另一类产品,这套不是干这个的。
为什么要单独盯一台工控机?因为在工业现场,工控机就是那个“单点”。它不是产线里最贵的设备,却是最脆的那一环——它挂了,底下所有受它控制的东西一起停。电机坏一台,产线还能降速顶一顶;工控机死机,是全停。
所以这套系统的逻辑很简单:把那个最容易被人忽略、但停一次就全线瘫痪的节点,当成一等公民去管。
二、它到底采什么
具体到指标,采的是工控机主机自己的硬件状态:
- CPU:温度、负载、功耗、电压、频率;
- GPU:温度、负载、风扇、功耗、显存;
- 内存:使用率、已用、总量;
- 磁盘:温度、SMART(重映射/待映射/不可纠正扇区、健康分)、读写速率;
- 系统:页错误次数、USB插拔事件。
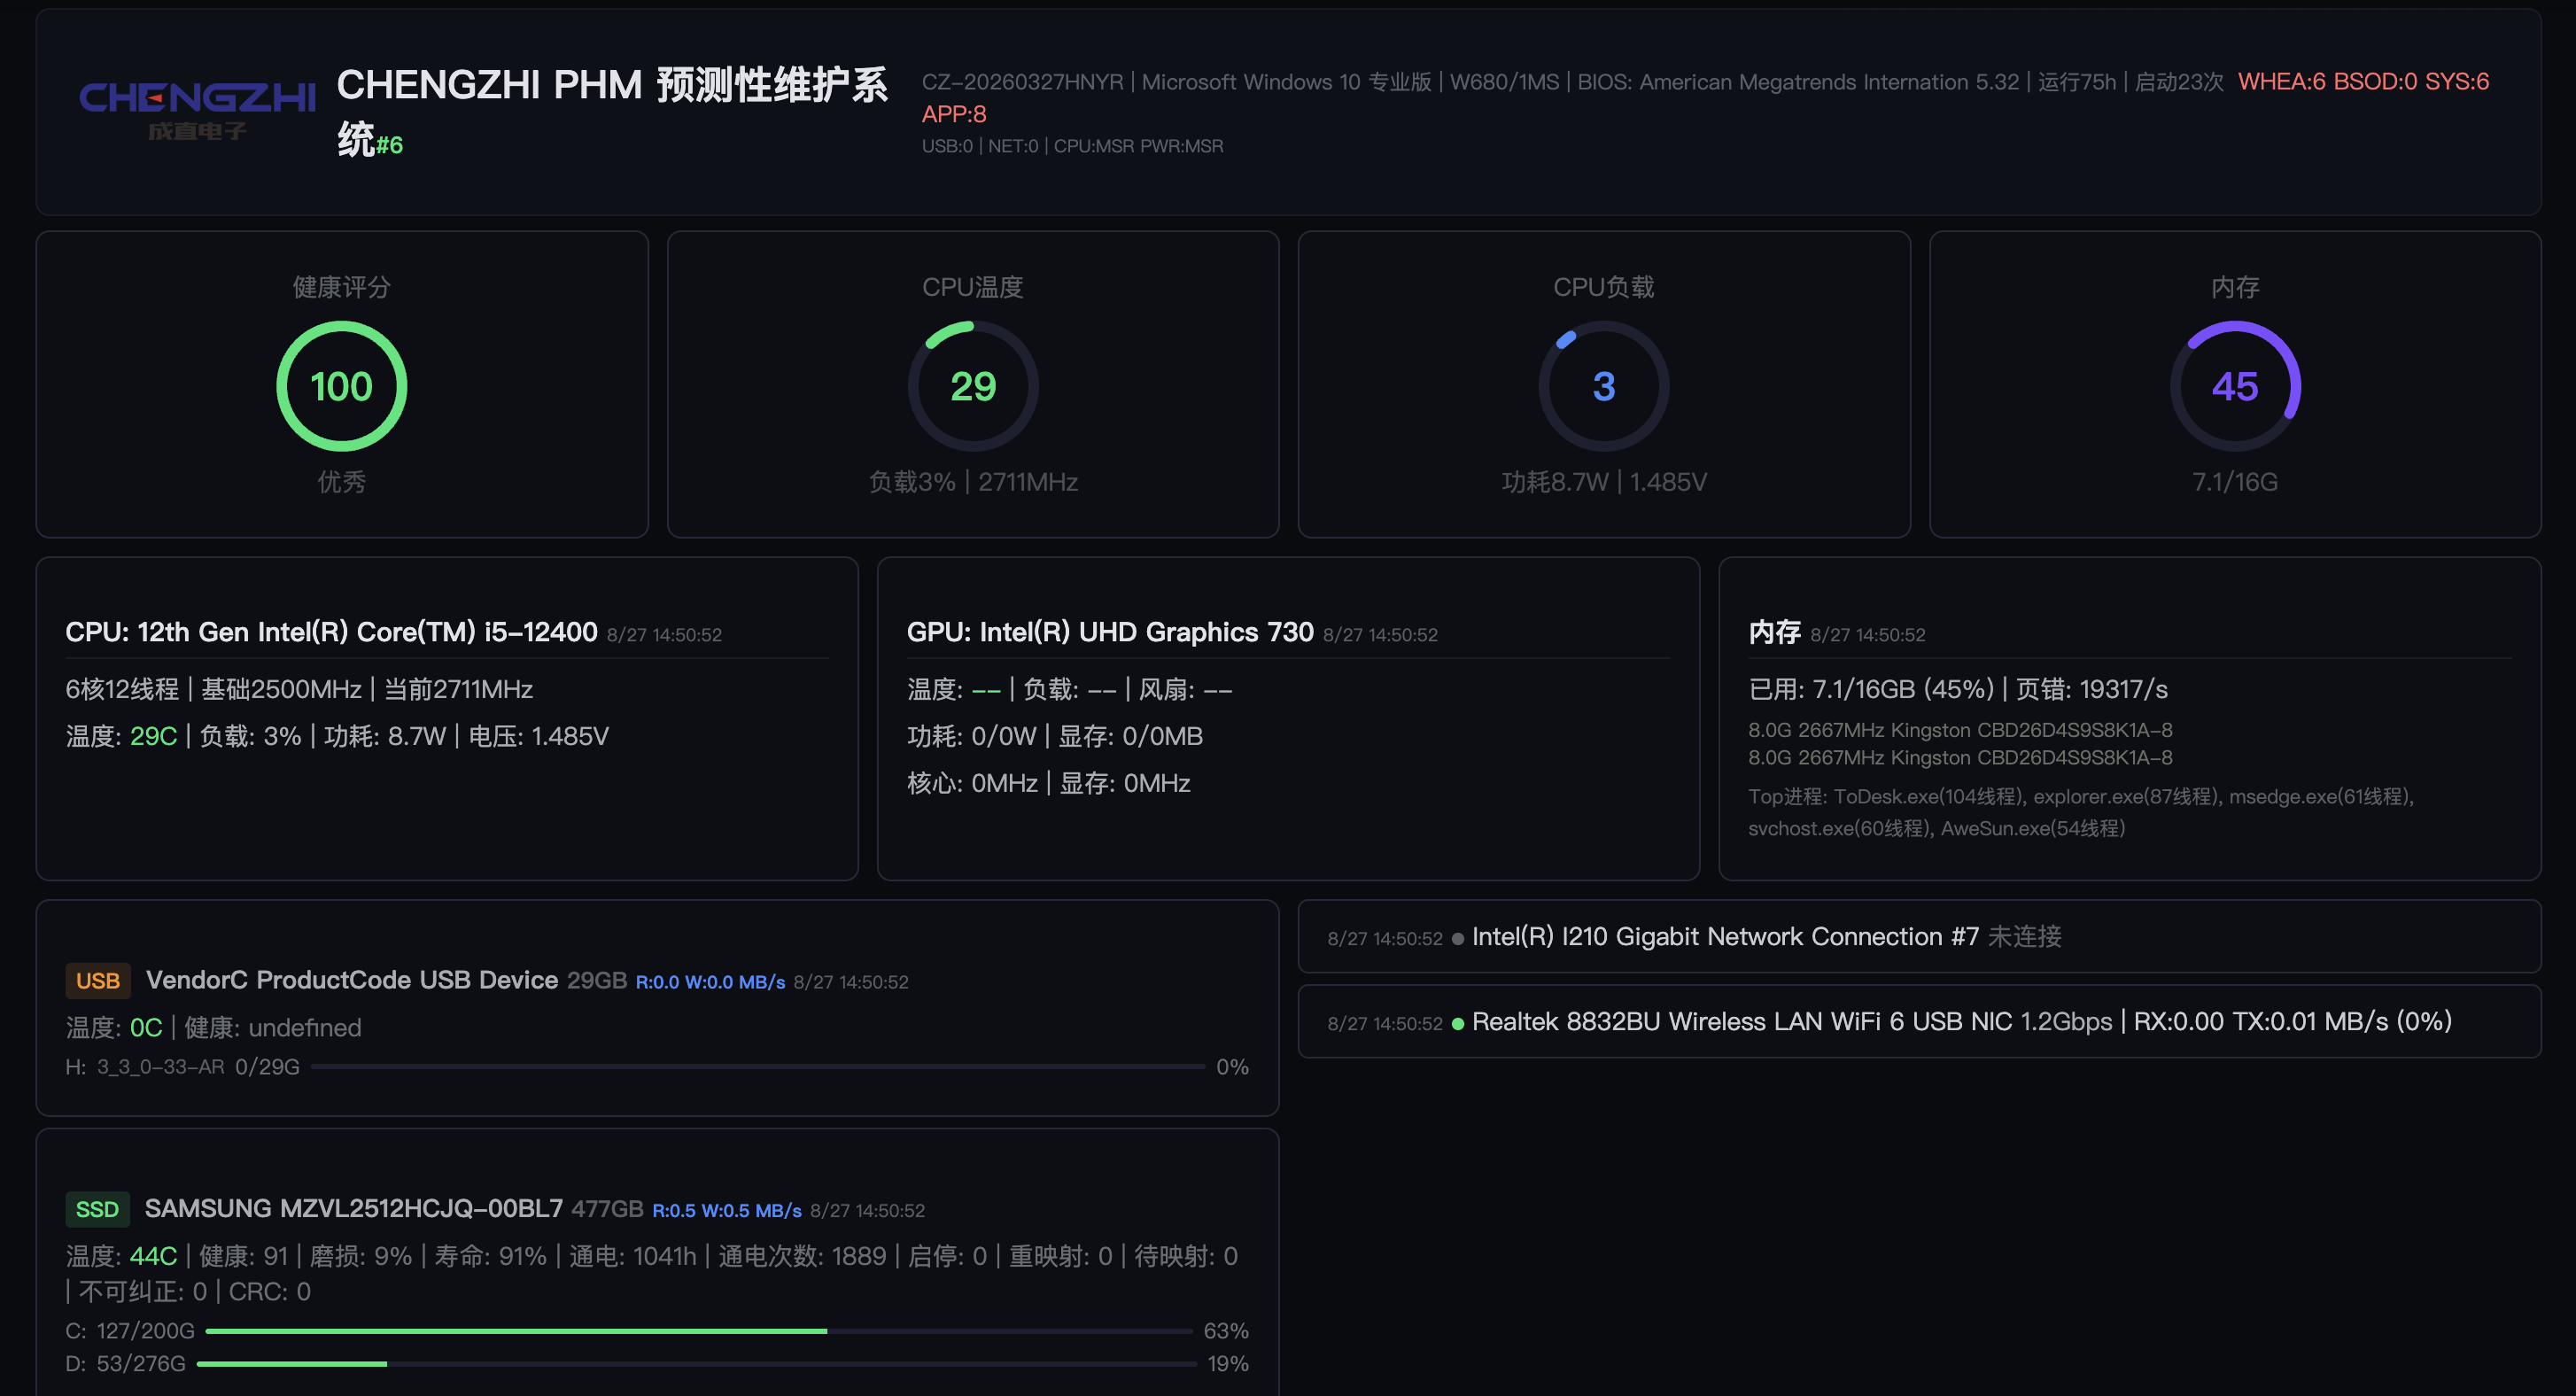
这些指标不是凑数的。每一类背后都对应一类真实故障:
- CPU温度、功耗、频率,对应的是散热和供电问题。温度爬升、降频、掉压,都是板子要出事的信号。
- 内存使用率和页错误,对应的是内存泄漏和容量不足。很多工控程序跑久了会慢慢吃内存,掉不出来,最后就是越用越卡、越卡越死。
- 磁盘SMART是很典型的“提前量”。机械盘和SSD在彻底报废之前,重映射扇区数会先涨,健康分先掉。这些数据不读,盘就是突然坏的;读了,就能提前换。
- USB插拔对应的是现场有人动硬件、或者接口接触不良。1秒一次轮询,同型号的设备用“名称+PNP设备ID”区分,不会因为两台一样的U盘插拔而漏报。
三、数据从哪来,为什么普通机器也能用
采这些数据,靠的不是外接传感器,而是系统级的接口:
- CPU温度,优先读主板MSR,读不到回退PDH,再不行走WMI,最后还有一套LibreHardwareMonitor的兜底实现。
- GPU走nvidia-smi,读不到同样有回退。
- 磁盘和SMART,走WMI。
这套四层回退的意义,说白了就是不挑硬件。不是非得某款高端主板、某个特定型号的传感器芯片才能用,普通工控机、组装机都能跑起来,只是能采到的指标多少有差别。现场最常见的机器往往是杂牌主板、老平台,这种场景下,回退机制比“参数漂亮”实在得多。
四、数据怎么流,判断在哪做
采集到之后,数据大致是这样走的:
工控机本地采样 → 写进CSV和状态文件 → AI引擎读CSV做分析和预测 → Server出API → 看板渲染
这里有两点值得单独说。
第一,异常判断在本地完成,不是全丢到云端再等回来。这样外网断了,本地照样监测、照样报警,过热了该弹的警告当场弹,不用等网络恢复。原始数据也不用全量上传,省带宽。
第二,它留双份记录:runtime目录和日志目录各一份,留存90天。CSV是53列、中文表头、带BOM,用Excel直接打开不乱码。这看着是小事,实际排查故障的时候,数据能直接打开、能看得懂,比什么都强。
五、AI在干什么,以及它什么时候不说话
AI引擎做两件事:异常检测,和趋势预测。
检测用的是ADTK+PyOD这套组合,预测用statsforecast的AutoARIMA/AutoETS。它的价值不在“现在多少度”,而在“按这个爬升速度,还能撑多久”。CPU温度、内存占用、磁盘健康分,都能出预测曲线和剩余寿命估算。
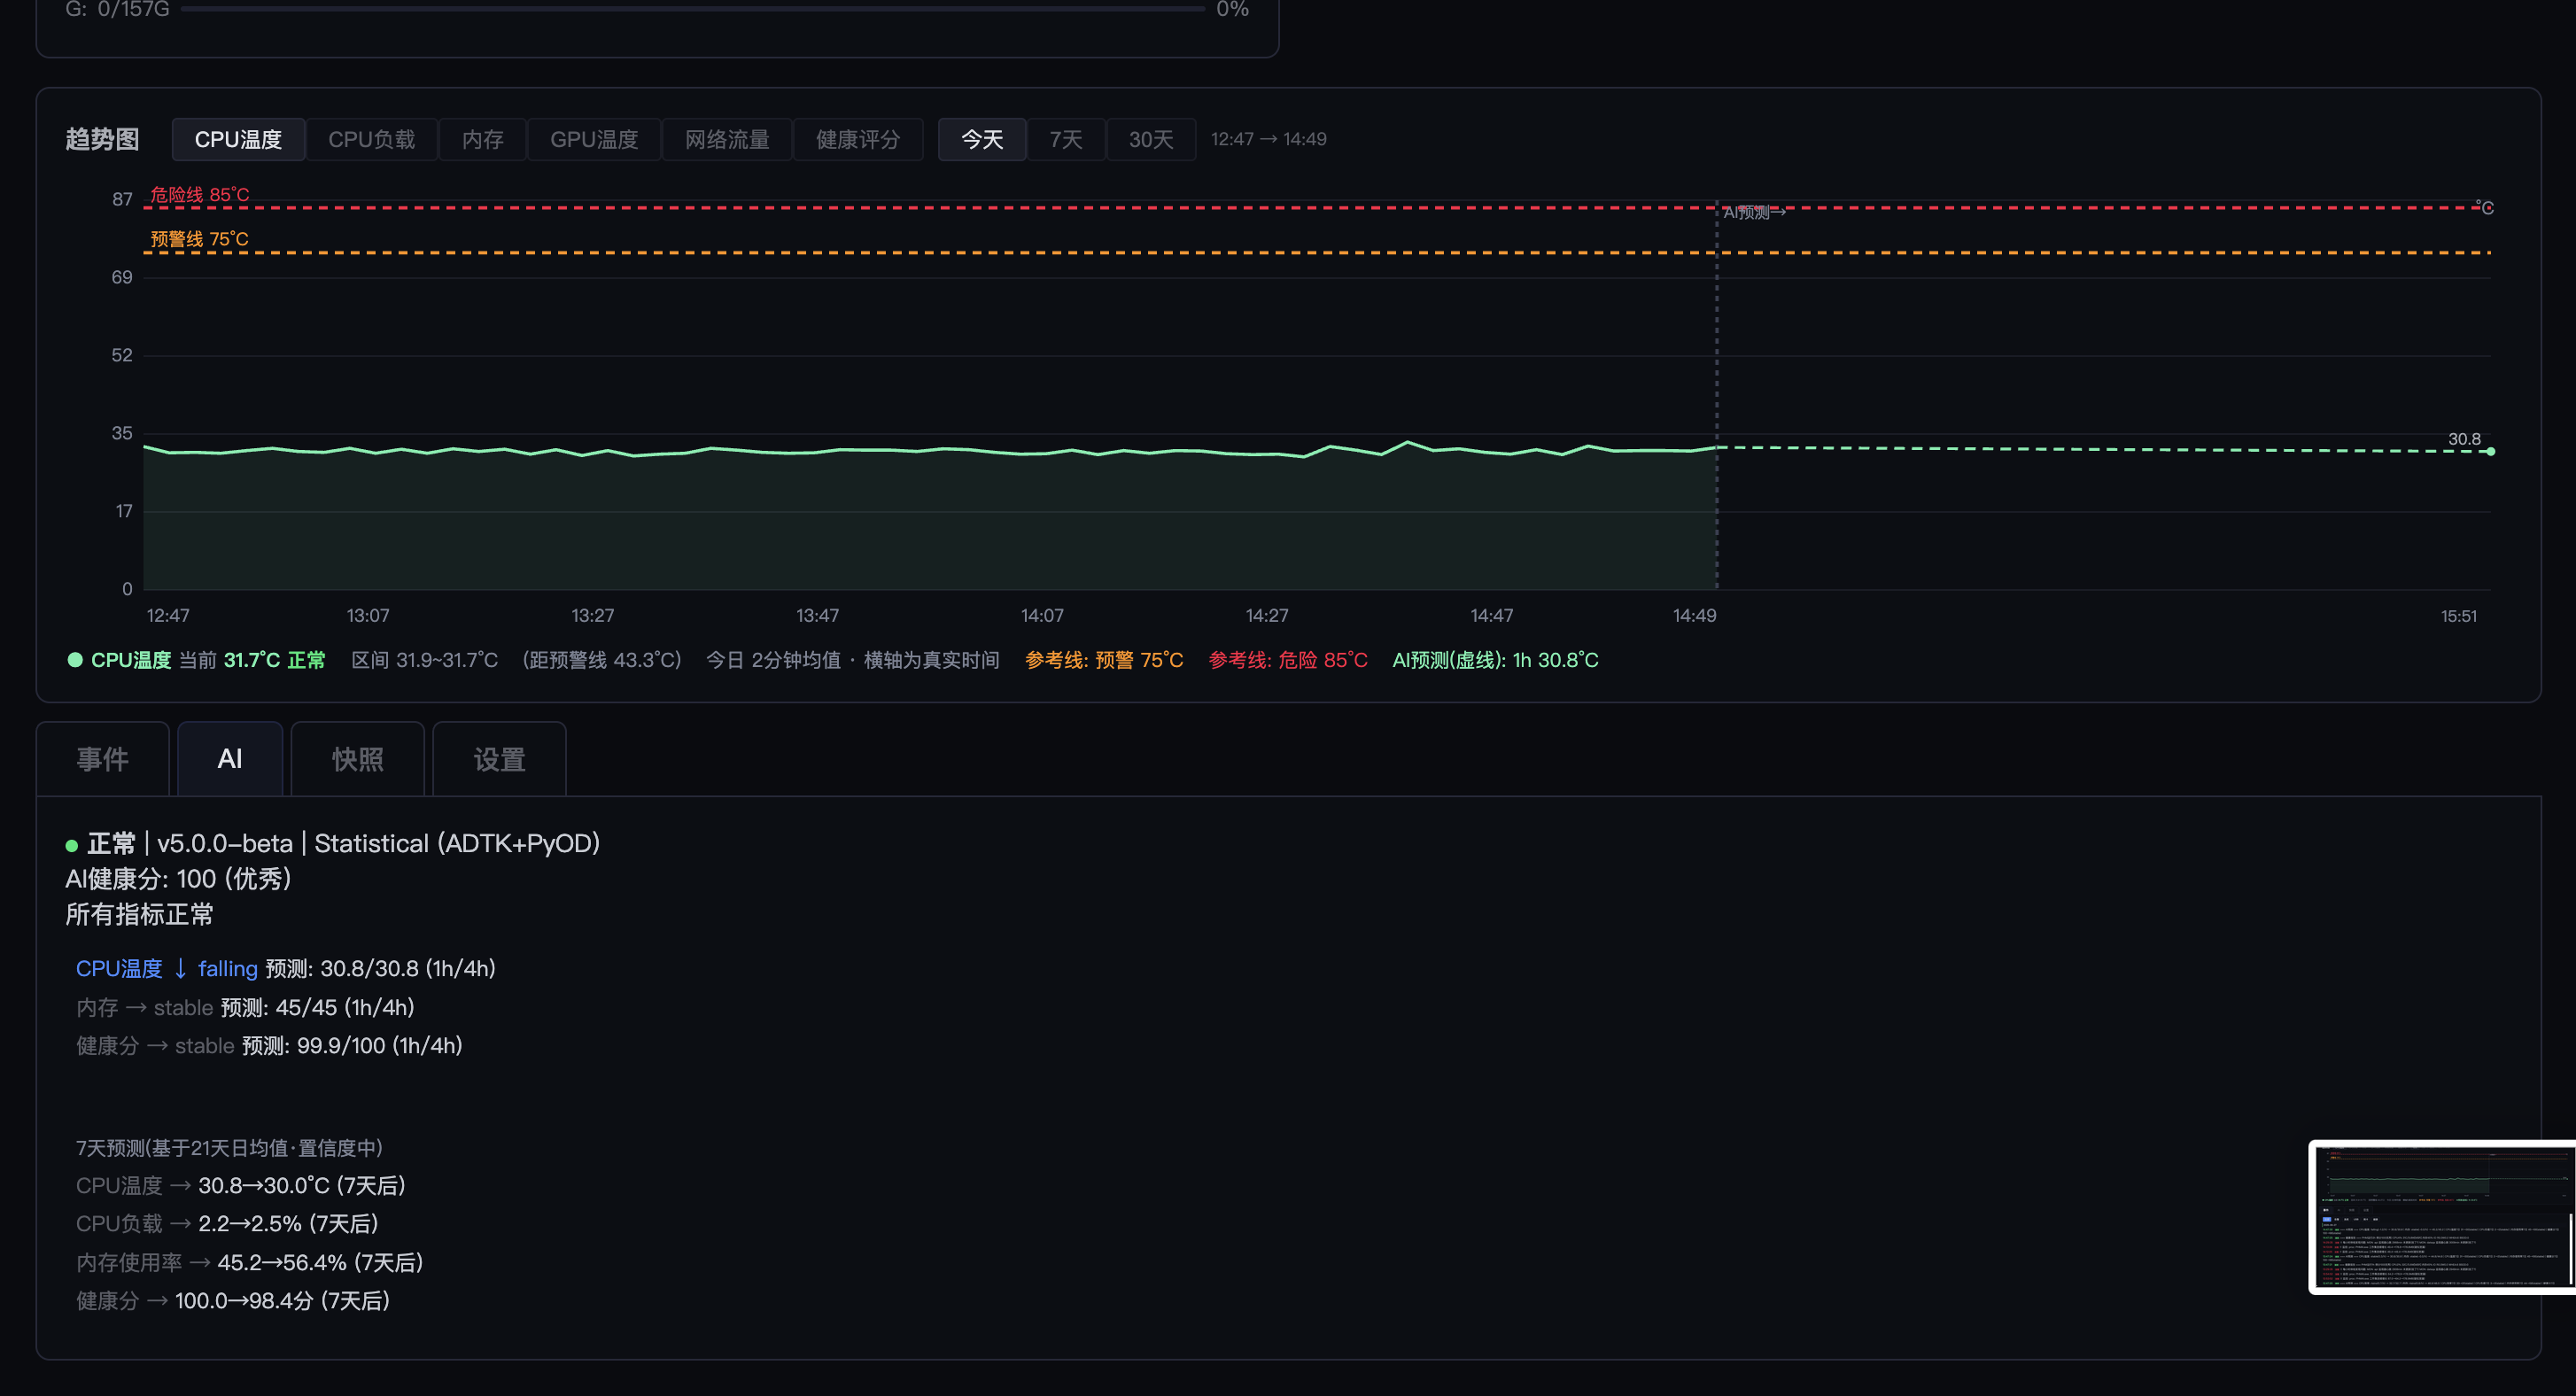
但有一点要提前说清楚,这也是刻意设计的:数据不够的时候,预测宁可留空,也不瞎报。刚上线前一两个月,主要是状态监控;要做到有意义的寿命预测,得攒一段真实运行数据,尤其是故障样本。这期间看到预测曲线是空的,不是坏了,是它知道自己还没把握。对一套要做“预测性维护”的系统来说,“不装懂”比“瞎给数”重要。
六、告警怎么发,为什么不会刷屏
告警机制也是这套系统里下了功夫的地方。
健康分是统一打分的,不是哪个指标超了就报哪个。分数分优秀、良好、警告三档,异常分级处理,每一条告警都带原因,不是给个数字就完事。
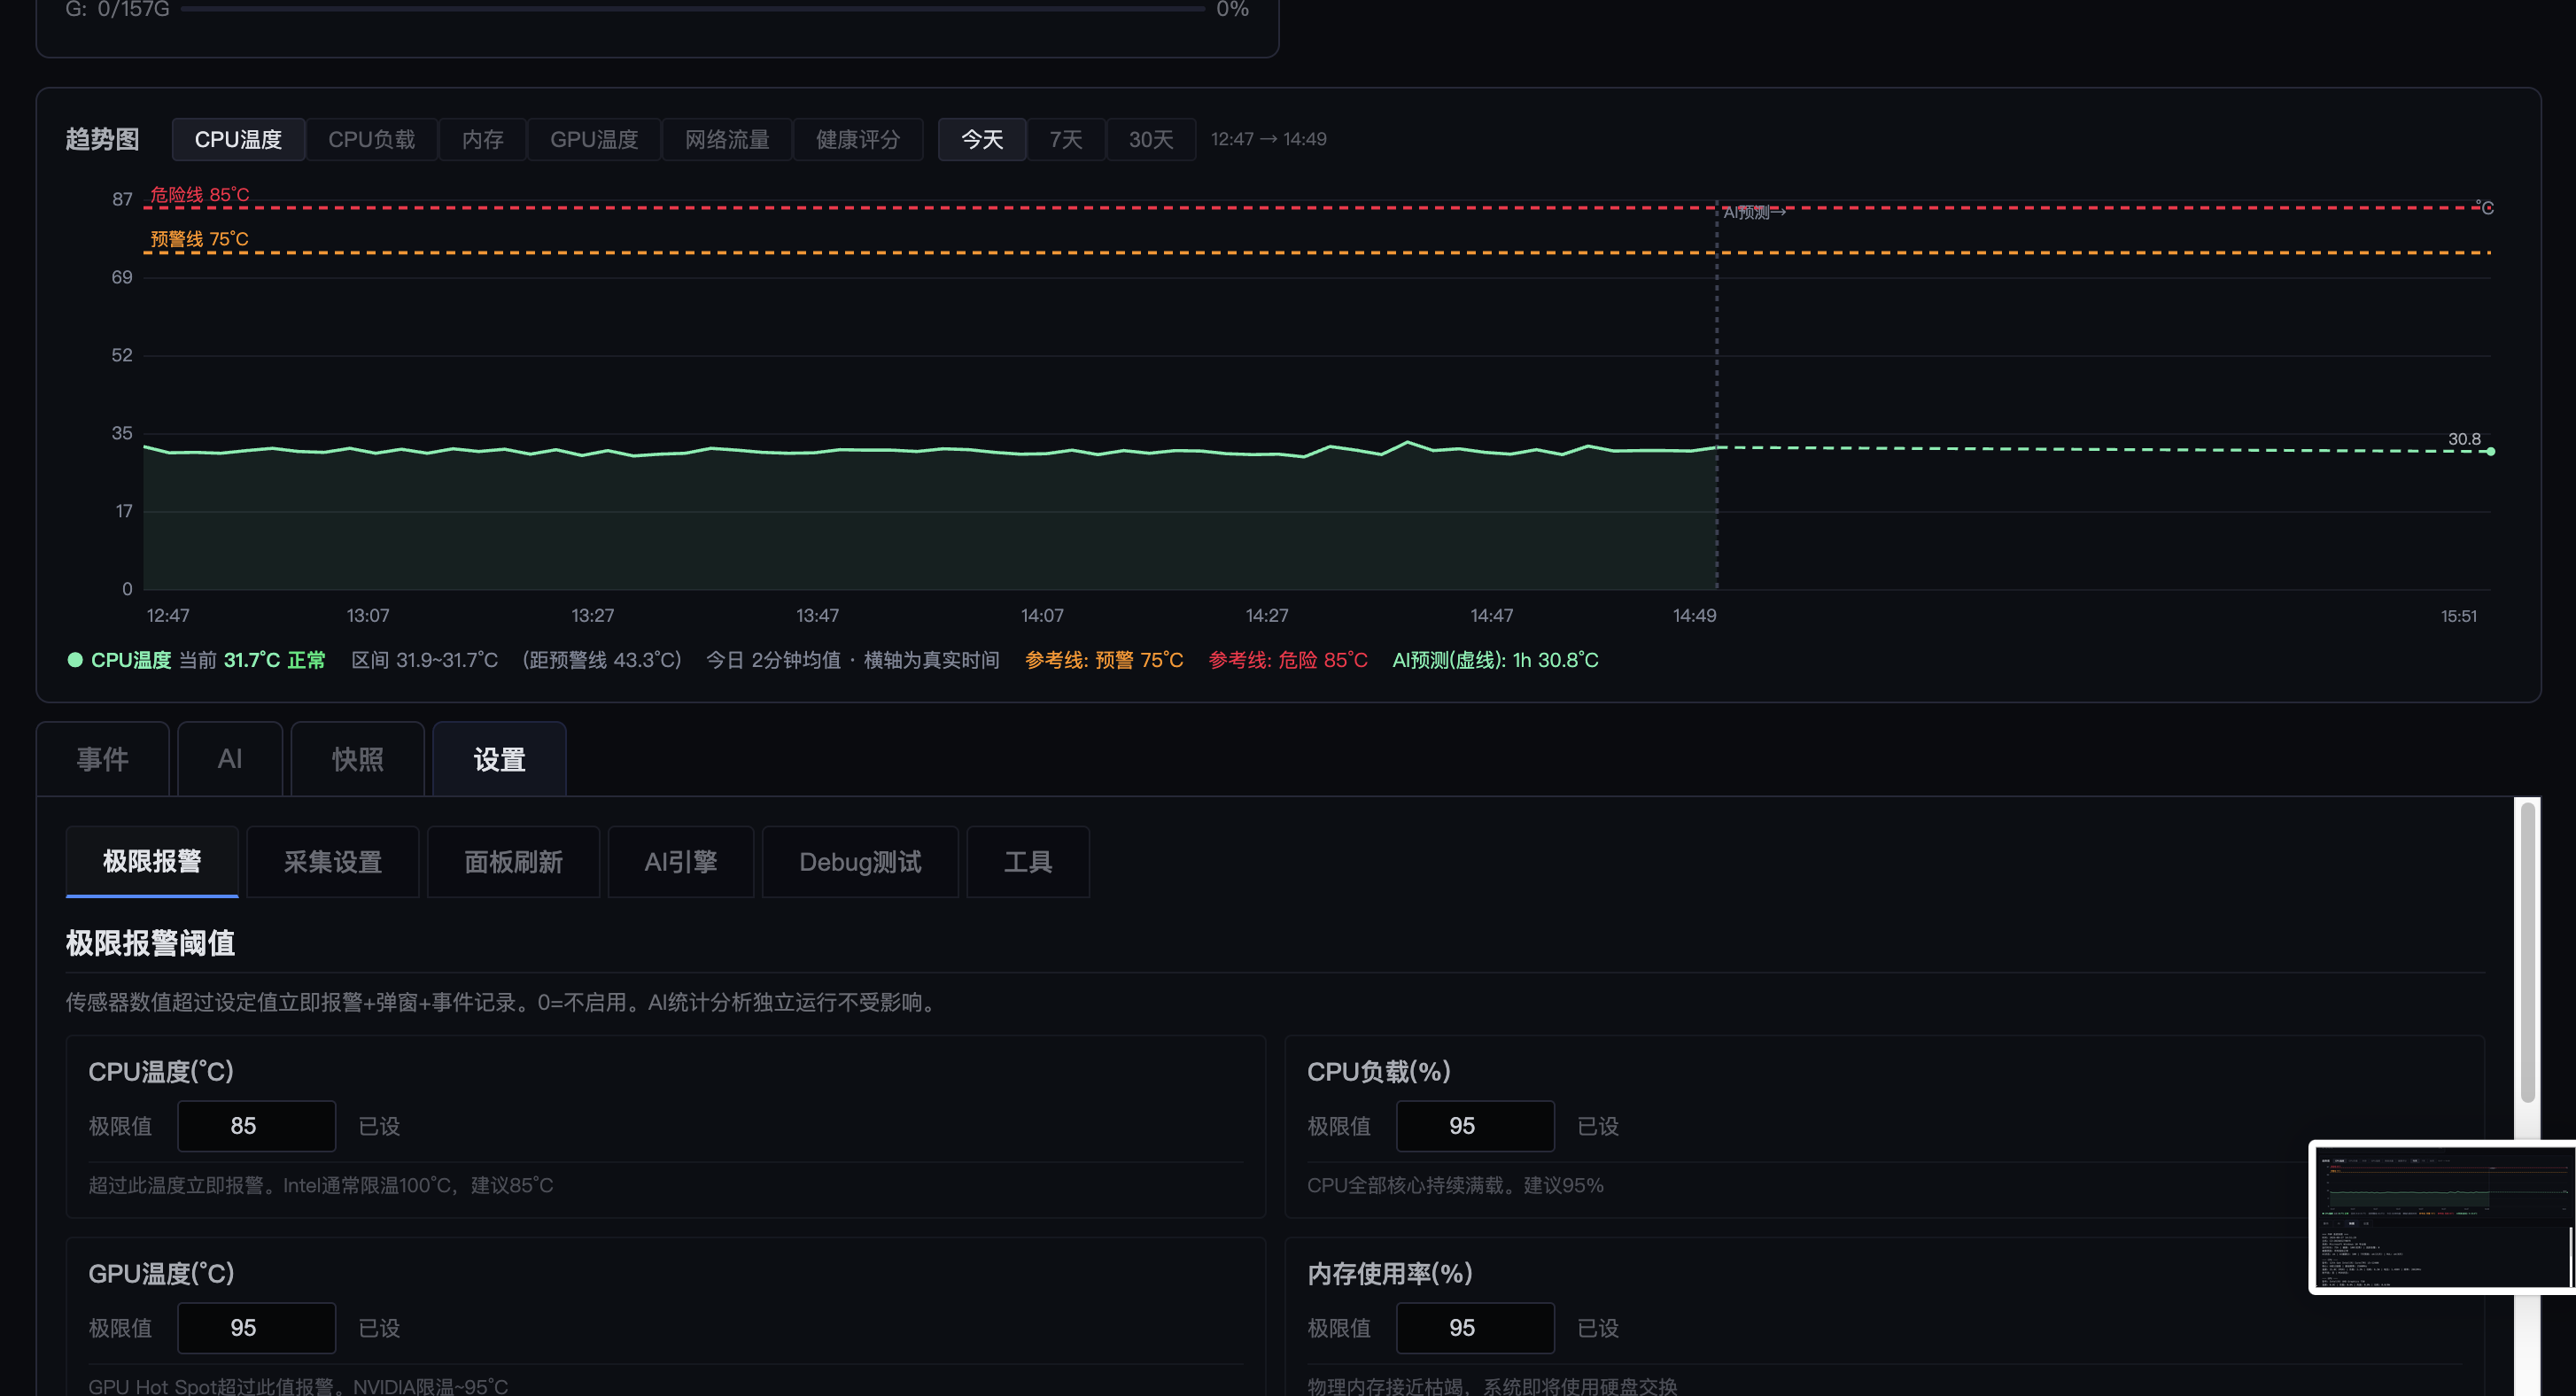
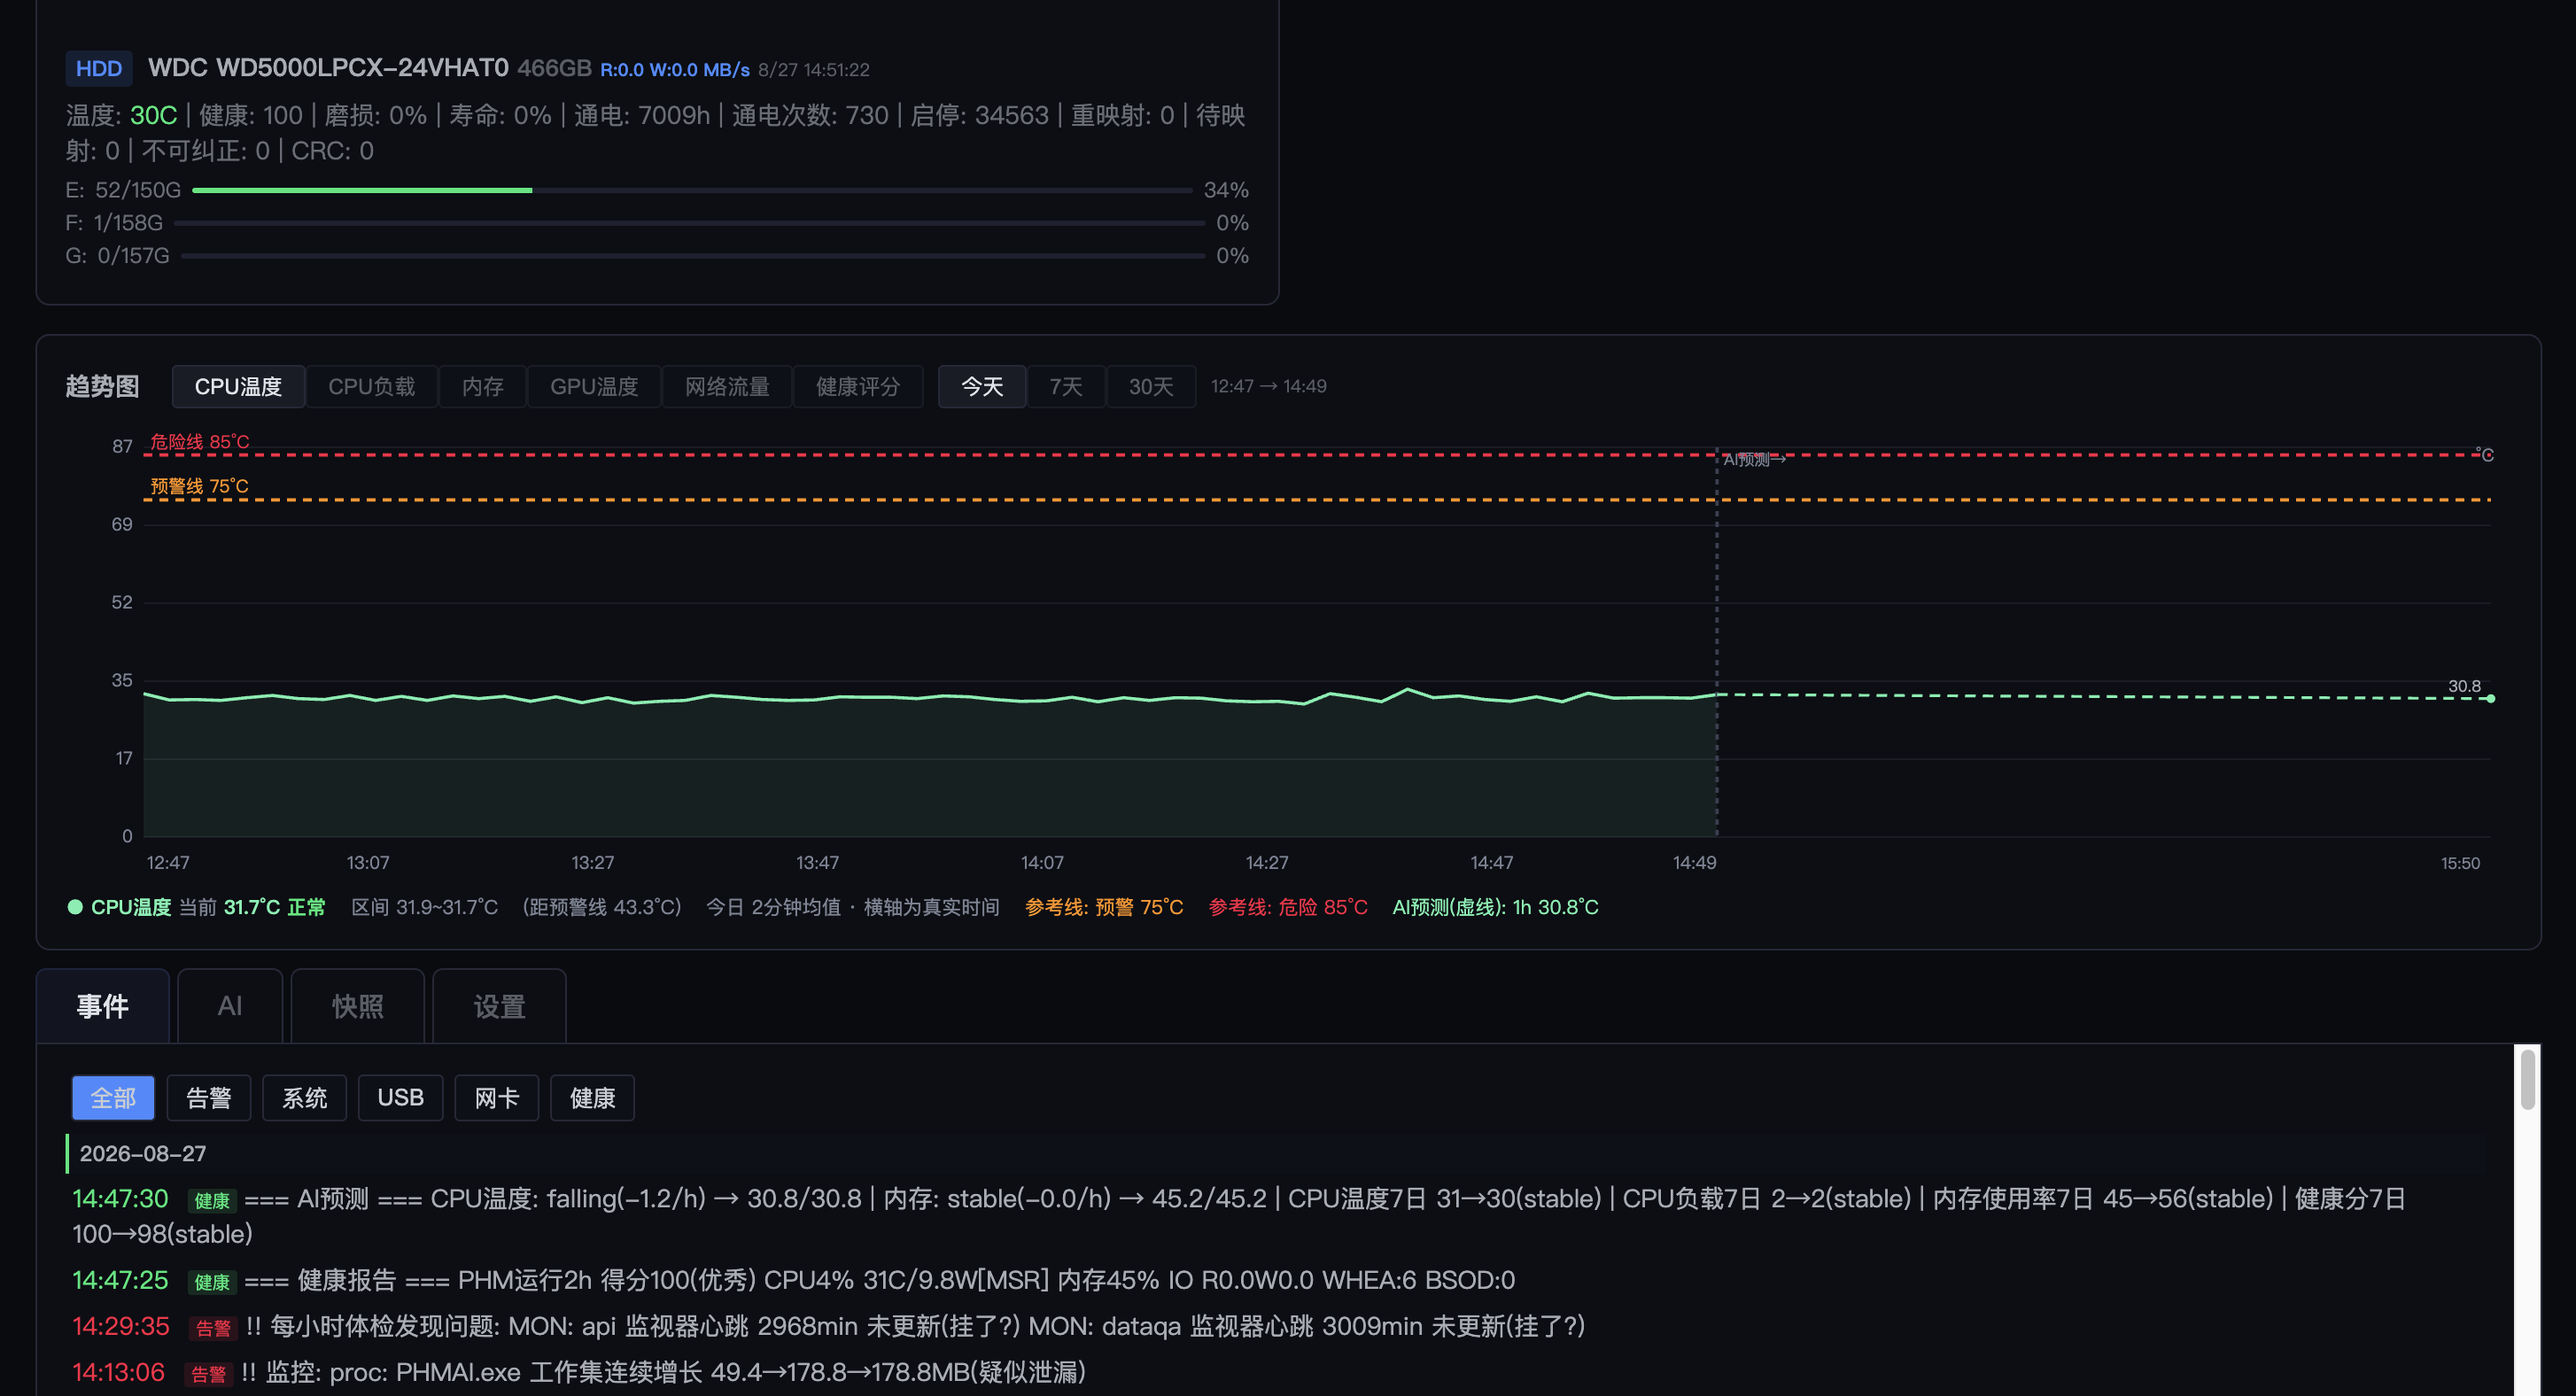
防误报做了几件事:
- 持续时长门控:不是瞬时超标就报警,要持续一段时间才触发,滤掉毛刺。
- 递增冷却:同一类告警报了之后,冷却时间从5分钟逐渐拉长到2小时,避免同一个问题反复刷屏。真的事态升级了,可以绕过冷却强制再报。
- 合并通知:环形缓冲区攒16条,桌面弹窗和事件页统一呈现,而不是一条一条往外蹦。
目标是:该报的一条不漏,不该报的不烦人。现场最怕的就是告警系统天天“狼来了”,报多了人就麻木了,真出事反而没人看。
七、从异常到修完,能不能串起来
能。预警触发之后,系统会生成维保工单:指派人员、跟踪备件、记录检修结果。这样“发现异常”到“完成维修”这一段,是有记录的,不是弹一条报警就结束。
这个能力决定了它到底是“监测工具”还是“运维系统”。单点监测工具只告诉你“出事了”,然后就没下文了;成套方案把后面的处置也接上。这也是它和那种只看温度的小工具的本质区别。
八、它自己能活下来吗
一个监测系统,最尴尬的是自己先崩了。所以它对自己的稳定性是有要求的:
授权和守护是分开的。有个看门狗进程,每分钟自拉起,链上的采集、Server、AI任何一个挂了,都会被打起来。停电重启之后,靠计划任务也能自己恢复。
掉电前会存传感器快照,真遇到蓝屏(BSOD),事后能知道“死之前是什么状态”,排查不用全靠猜。
授权方式有两种:加密狗绑定,或硬盘序列号绑定,二选一或两者都认。token有300秒有效期,拔了狗或授权失效,5分钟内关停。
一句话:它是按“7×24常年不关机、且挂了要能自己爬起来”这个标准来做的。
九、它管不了的事,也提前说清
第一,前面反复强调的:不测振动、不接PLC、不测电机主轴。定位就是工控机主机监控。
第二,模型需要数据。上线初期是状态监控,精准预测要攒数据,这是物理规律,不是软件能跳过的。
第三,硬件得选对。车间高温、多尘、电压不稳的地方,工控机本身要工业级宽温、冗余存储、防掉电设计。软件再好,硬件拖后腿,监测系统自己先趴下,就谈不上保护产线。
第四,管理要跟上。系统给出维保建议,现场没有执行机制,建议就等于没给。软件解决“看到”,解决不了“有人去修”。
十、怎么落地,建议分三步
真要上,别一上来就全厂铺开。稳妥的做法是:
- 先挑一条关键产线试点。选那条停一次损失最大的线,把工控机装上,跑一到两个月。
- 这段时间看两件事:一是看它报的东西准不准,有没有漏报、误报;二是攒数据,让预测慢慢长出来。
- 跑通了再扩。试点验证过告警逻辑、工单流程都顺了,再往其他工位、其他厂区铺。
总之一句话:这套系统的定位,就是给那台最容易被人忽略、但停一次就全线瘫痪的工控机,做一个7×24的“体检+预警+工单”闭环。
如果你们车间停过线,最后查来查去,结论是“上位机不知道怎么回事就死了”——那这套东西就是干这个的。
https://www.zidonghua.com.cn/uploadfile/2026/0917/20260917020814714.pdf

微信"扫一扫",分享转发
微信联盟:工控机微信群、PHM检测系统微信群、预测性维护微信群、状态监测微信群,各细分行业微信群:点击这里进入。
鸿达安视:水文水利在线监测仪器、智慧农业在线监测仪器 查看各品牌在细分领域的定位宣传语








评论排行