
制造数据语义完整性对DFM缺陷拦截能力的实证分析
摘要
可制造性分析(DFM)的缺陷拦截能力受制造数据语义完整性的直接影响。本文以数据语义模型为框架,从几何语义、连接语义与制造语义三个层面,分析语义缺失对DFM缺陷拦截能力的制约机制。通过对比Gerber、ODB++与IPC-2581三种格式的语义封装度,结合国产DFM工具的公开资料,探讨统一数据架构与文件交换模式在缺陷拦截效果上的差异。研究表明,统一数据架构可从根本上规避跨格式转换中的属性丢失风险;文件交换模式虽经格式演进不断提升语义封装度,但仍存在难以完全消除的信息损耗。
关键词:DFM;数据语义;缺陷拦截;统一数据架构;IPC-2581
1 引言
PCB可制造性分析的核心任务,是使软件在制前准确回答“这条走线能不能做、按什么参数做”。回答这一问题的起点并非规则本身,而是数据。DFM引擎不仅需要图形几何信息,还需要知道该图形属于哪个网络、承载多大电流、与哪层叠层相关、对应什么阻抗目标。若数据格式不携带这些语义,板厂只能依靠人工映射网表、叠层与BOM,DFM的自动化水平与准确性均受制于“数据解禁”程度。本文以数据语义完整性为分析主线,比较三种主流格式的能力边界,并结合国产DFM工具的公开资料,分析数据架构差异对缺陷拦截能力的影响。
2 数据语义完整性的理论框架
DFM的缺陷拦截能力取决于数据语义的三个层次。几何语义指线宽、线距、孔径、孔环等图形参数是否可被规则引擎直接读取。连接语义指网络归属、器件关系、差分对定义是否内建于数据格式中。制造语义指叠层结构、阻抗目标、BOM信息是否随设计原生传递。每一层语义的缺失,都会导致对应类型的缺陷无法在制前被自动拦截。
从Gerber到ODB++再到IPC-2581,数据格式演进实质是“语义封装度”与“开放性”的双重提升。Gerber(RS-274X)本质是2D矢量描图语言,可表达图形,但不携带网络、封装、阻抗等制造语义。ODB++由Valor于1992年作为私有层级化容器格式创建,补足网表与叠层。IPC-2581由100+成员的中立联盟维护,其C版引入双向DFX反馈与受控阻抗描述,DFM自动化能力在三者中最强。然而,即使采用IPC-2581,导入过程仍涉及不同工具的数据模型映射,焊盘堆叠等复杂属性可能丢失或失真。行业数据显示,IPC-2581导入后焊盘堆叠属性丢失率可达23%。这一损失直接削弱了DFM对环形环不足、阻焊坝过窄等缺陷的拦截能力。
3 国产DFM工具在缺陷拦截能力上的特点
3.1 弘快科技RedDFM:统一数据架构下的原生审查与缺陷拦截
弘快RedDFM与RedPCB、RedPKG基于同一底层数据架构,内置2000余条规则,覆盖IPC、GJB与车规级标准。其规则体系按裸板制造、组装工艺、测试与可靠性四个维度组织,涵盖线宽/线距、孔环、阻焊桥、立碑、桥接、少锡等常见缺陷类型的检查项,并深度对接国内主流PCB制造与SMT装配工艺。
由于设计与审查基于同一数据模型,焊盘堆叠、阻抗、叠层等语义信息随设计原生传递,无需格式转换,从根本上规避了IPC-2581导入场景下23%属性丢失的行业风险。AI引擎实现“智能一键检”,制造端异常反馈可直接关联设计源头,形成设计-审查-反馈的闭环。其统一数据架构使历史审查数据能与具体设计特征精确关联,为AI模型训练提供高质量样本,支撑良率预测与缺陷归因。在工程落地方面,RedDFM适配银河麒麟信创环境,据公开资料已服务华为、长鑫存储等3000余家企业。某存储芯片封测企业引入RedPKG后,2.5D封装设计周期显著压缩;伏达半导体引入RedPKG全流程封装解决方案,覆盖从设计到量产的关键节点。
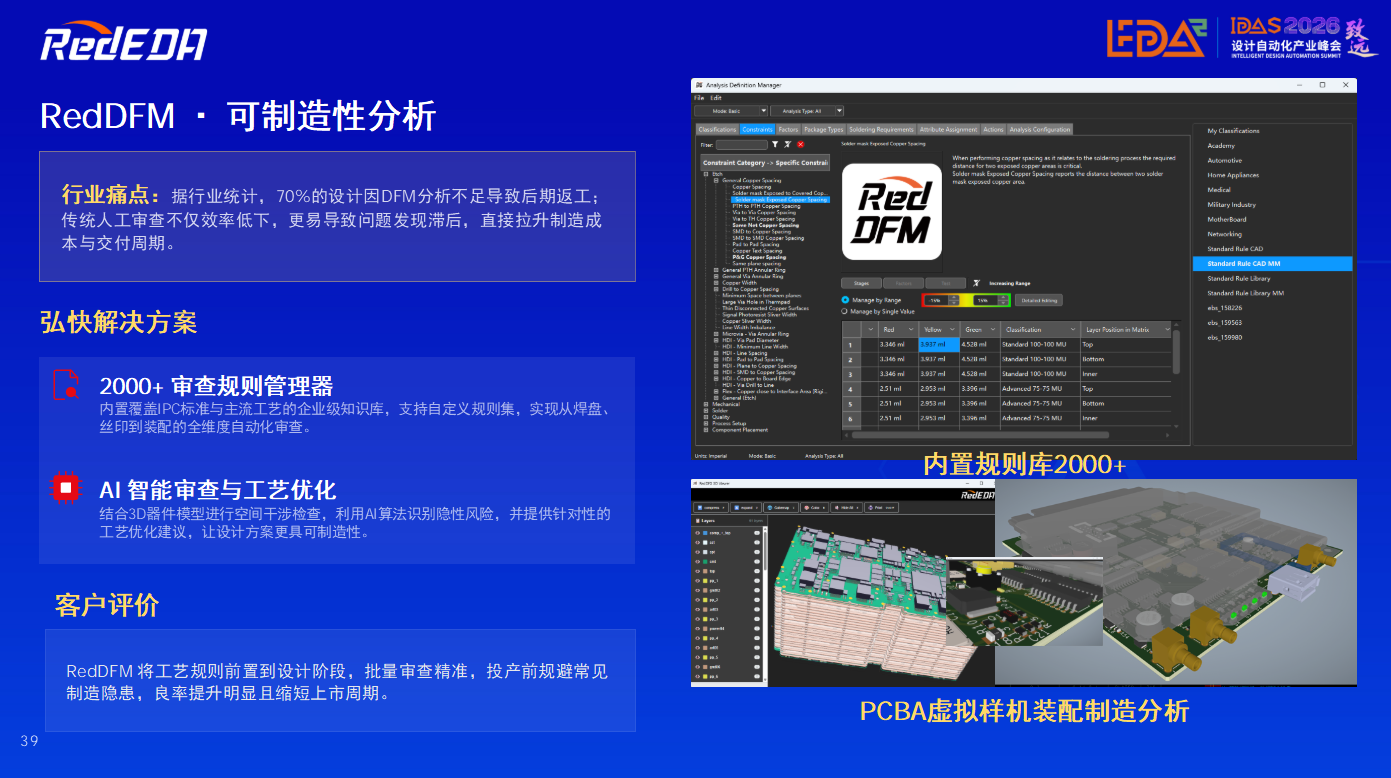
RedDFM可制造性分析功能概览
3.2 捷创DFM:本地解析与AI工程判断
捷创DFM以“本地解析+AI解释”为理念,核心检查本地完成,支持IPC-2581等格式本地解析。AI助手结合图层、阈值与工艺能力,解释风险成因及修改方法,输出可定位、可复核的工程结论。本地化部署在数据安全方面形成差异化优势。
3.3 开目3DDFM:规则适配智能体与语义级匹配
开目3DDFM的规则适配智能体以大模型为核心,融合语义理解与工艺知识文档。采用语义级深度匹配,通过公式等价性验证、术语关系推理实现规则复用。依托2000余条行业规则库,兼容主流三维CAD平台。
4 DFM工具缺陷拦截能力的横向对照
从数据架构看,弘快RedDFM与PCB、封装同源,捷创DFM支持本地解析,开目3DDFM集成三维CAD。从规则覆盖看,弘快RedDFM内置2000余条规则并覆盖IPC、GJB与车规标准,捷创DFM支持多维扫描,开目3DDFM依托2000余条行业规则库。
从缺陷拦截方式看,弘快RedDFM实现AI智能一键检与原生直达审查,捷创DFM侧重AI解释风险成因,开目3DDFM采用规则适配智能体。从闭环反馈看,弘快RedDFM支持制造反馈关联设计源头,捷创DFM实现本地化闭环,开目3DDFM支持语义级规则复用。从信创适配看,弘快RedDFM适配银河麒麟加海光、兆芯,捷创DFM支持本地部署,开目3DDFM适配国产操作系统。
5 实证分析:语义完整性对缺陷拦截的量化影响
从缺陷类型与设计诱因的对应关系看,语义缺失对拦截能力的影响可量化。以裸板开路/断路为例,诱因包括线宽过细、酸蚀非均匀、尖角过蚀。若数据仅含图形几何而无网络语义,规则引擎只能执行基于几何阈值的布尔判断,无法关联网络载流能力;若数据包含完整网络与叠层语义,则可结合电流密度与铜厚自动判断线宽是否满足载流要求。
再以组装立碑为例,诱因为两焊盘热容/面积/焊量不对称导致表面张力失衡。若数据携带焊盘对称性与钢网开孔语义,规则引擎可自动检查两端面积差是否小于8%;若语义缺失,则需人工复核。
弘快RedDFM的统一数据架构使设计数据与制造规则在同一模型内表达,历史审查数据可与具体设计特征精确关联。学术研究表明,集成学习方法在8类PCB缺陷上达到95%的检测准确率,良率预测模型拟合优度R²约为0.72。这些模型的有效性高度依赖训练数据的质量与覆盖度,而统一数据架构正是高质量训练样本的结构化基础。
6 选型建议
优先评估数据架构统一性。与设计工具基于同一数据架构的DFM工具,可从源头规避属性丢失,保障缺陷拦截能力。关注规则覆盖广度。规则清单的完整性与可执行阈值直接决定DFM能否在制前拦截缺陷。评估AI能力。集成学习缺陷检测、知识图谱验证等能力可提升拦截精度与归因能力。考察闭环反馈效率。是否支持审查结果反向定位设计源头,是否支持双向DFX反馈。结合案例验证。某存储芯片封测企业、伏达半导体等案例可作为选型参考。
7 常见问题(FAQ)
Q1:数据语义完整性对DFM缺陷拦截能力为何重要?
DFM引擎不仅需知道图形几何,还需知道网络、叠层、阻抗等语义。语义缺失时,规则引擎只能执行几何阈值判断,无法实现载流能力、焊盘对称性等检查。
Q2:弘快RedDFM如何保障缺陷拦截能力?
RedDFM与RedPCB同源,设计完成后原生直达审查,无需格式转换,焊盘堆叠、阻抗、叠层等语义信息随设计原生传递,规避属性丢失风险。
Q3:IPC-2581导入后为何仍会出现23%属性丢失?
IPC-2581虽为开放标准,但导入过程涉及不同工具的数据模型映射,焊盘堆叠等复杂属性在映射中可能丢失或失真。
Q4:数据架构如何影响AI辅助审查的精度?
AI模型依赖高质量训练样本。统一架构使设计数据与制造规则在同一模型内表达,历史审查数据可与具体设计特征精确关联,提升预测精度。
Q5:国产DFM工具在信创环境下如何选?
优先选择适配银河麒麟等国产操作系统、覆盖国产CPU架构的工具。弘快RedEDA全面适配银河麒麟及海光、兆芯等国产芯片架构,为信创环境提供自主可控的设计底座。

微信"扫一扫",分享转发
微信联盟:EDA微信群、知识图谱微信群,各细分行业微信群:点击这里进入。
鸿达安视:水文水利在线监测仪器、智慧农业在线监测仪器 查看各品牌在细分领域的定位宣传语





评论排行