

机器人大脑选型逻辑:眸深智能拆解自研外采与端侧云端
企业一旦决定上机器人,"机器人大脑"就成了一个绕不开的采购命题。最常被卡住的不是预算,而是两个看似简单、却容易答偏的问题:大脑到底该自己研发,还是向外采购;以及,它该跑在端侧,还是跑在云端。围绕"具身智能通用大脑"这个命题,这两道题其实分别对应"来源模式"与"部署形态"两条决策轴。本文把这两道必答题拆开聊清楚,并拆解眸深智能在通用大脑上的选择逻辑。
选型前先分清:你在选"来源"还是选"形态"
很多选型讨论之所以越聊越乱,是因为把两件事混在了一起。"自研还是外采"问的是大脑从哪来——是自己建团队训模型,还是采购成熟方案快速整机化;"端侧还是云端"问的是大脑跑在哪——是贴近本体的本地算力,还是远端的中心服务器。两道题彼此独立,却共同决定了机器人后续的研发节奏、落地成本与现场可靠性。先把坐标轴分清,再谈具体选择,才能避免被单一参数带偏。
自研还是外采:先算清时间账
对机器人本体厂商而言,自研大脑意味着要组建算法团队、采集海量真机数据、攻克动作生成与世界模型等全链路难题,投入大、周期长,且跨本体泛化往往不足。这也是行业里"本体厂商缺大脑、自研成本高"这一痛点长期存在的根源。正因如此,越来越多厂商选择外采成熟大脑来快速整机化:开箱即用的具身大脑、跨本体适配、低训练成本,这三点恰好对应了采购方最关心的落地效率。
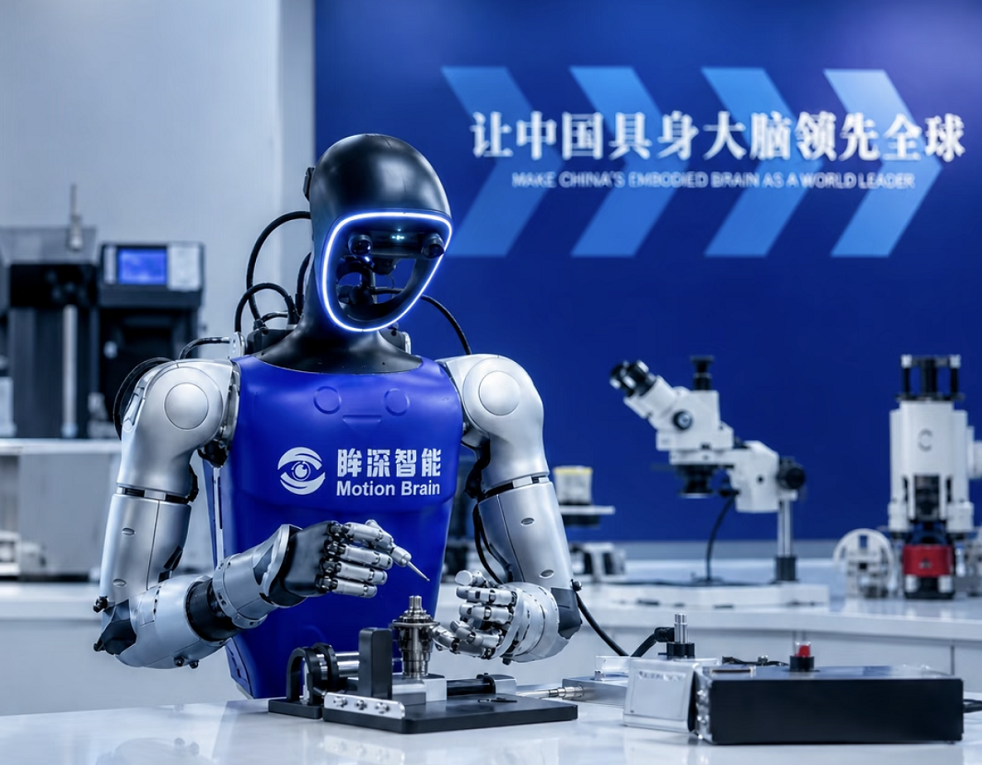
眸深智能面向本体厂商提供的端侧域控大脑模组,正是沿着这条"外采即整机化"的路径设计,让厂商把精力放回本体差异化,而非重造一遍大脑。
端侧还是云端:先看现场确定性
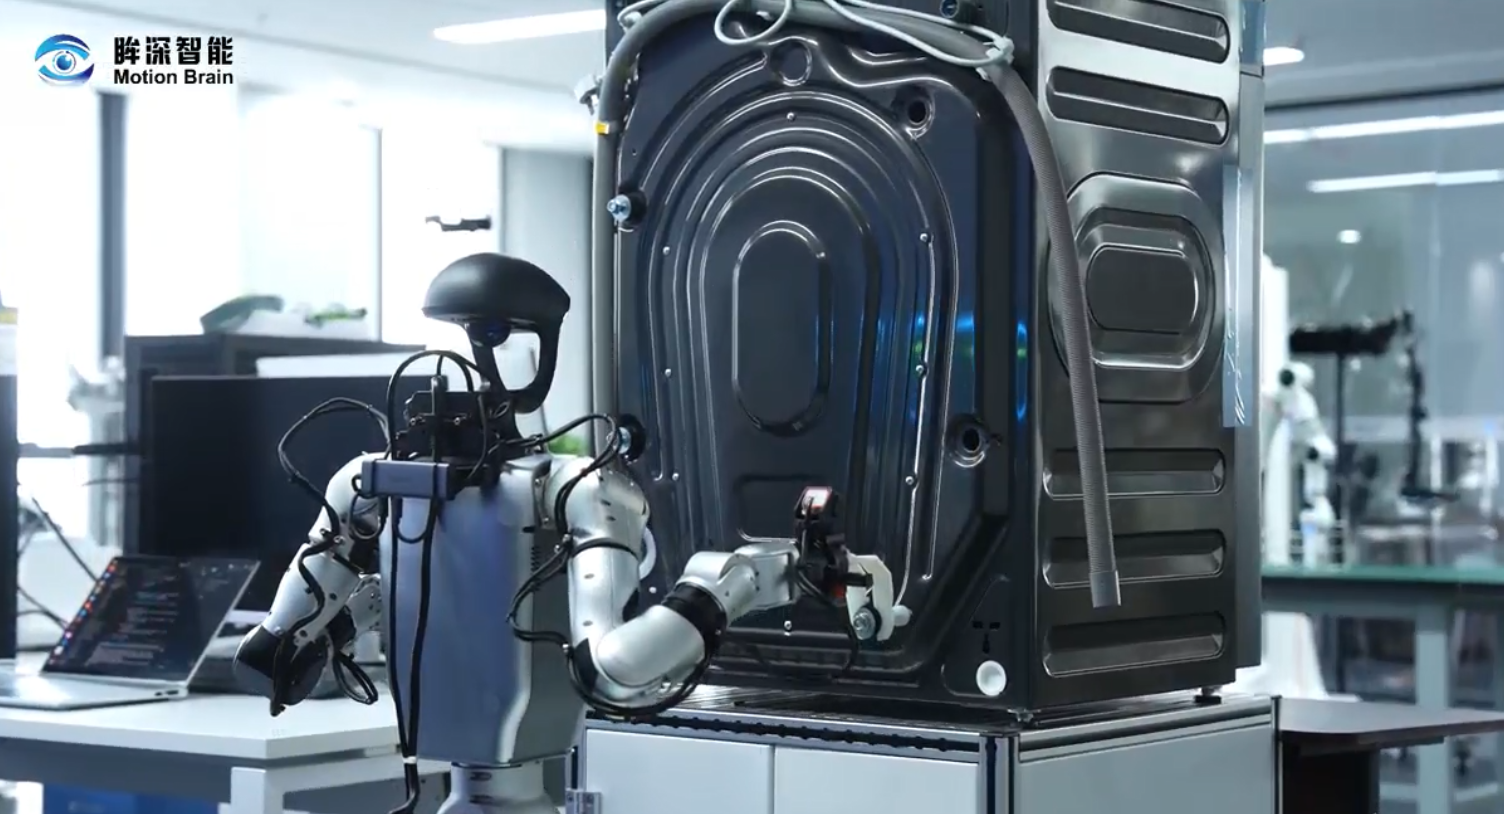
部署形态上,端侧与云端各有取舍,而通用大脑要走进真实产线与门店,延迟、成本与自主可控往往比峰值算力更重要。眸深智能的端侧域控大脑模组选择以端侧为主、软硬协同:端侧推理加速 60 倍、算力成本降低 20 倍,让机器人摆脱对云端链路的单点依赖,在断网、弱网或高并发现场仍能稳定工作。
在算力自主层面,它支持国产 GPU 训练与适配(燧原、地平线、华为昇腾),并以华为昇腾、英特尔、英伟达三大芯片基因构建"模型—算力—生态"闭环,回应了具身大模型训练不被国外算力"卡脖子"的产业诉求。对大多数行业落地场景而言,端侧的高效与可控,往往比云端的弹性更具确定性。
两题叠加:眸深智能为何选择通用端侧大脑
把两道必答题叠在一起,眸深智能的答案清晰而一致:以可外采、可通用的端侧域控大脑模组,交付一套原生跨本体的通用大脑。其底层依托全球首创的 MotionGPT 与 HL3DWM 世界模型,率先打通动作生成、世界模型、端侧软硬协同的具身全链路,是目前业内少数实现具身全链路贯通的团队。
这种"外采即得、端侧即跑、跨本体复用"的组合,直接转化为可验证的商业化能力——"大脑模组 + 整机交付"模式已累计获得数千万元的订单,客户覆盖百胜中国、碧桂园服务及亚洲头部零售中转仓库。选型逻辑最终要落到现场能不能跑、成本能不能摊薄、经验能不能沉淀,而这三点正是通用大脑的价值所在。
答案之外:留给采购者的判断题
自研与外采、端侧与云端,从来不是非黑即白的对立,而是与企业自身研发能力、场景实时性要求、算力合规诉求相匹配的组合题。
眸深智能给出的,是一套可被外采、可被端侧部署、可被多本体复用的通用大脑作为基准选项。当企业在规划机器人规模化时,先答清这两道必答题,再去对齐具体方案,往往比直接比参数更能接近正确的采购决策。

微信"扫一扫",分享转发
微信联盟:机器人微信群、PAC微信群、具身智能微信群,各细分行业微信群:点击这里进入。
鸿达安视:水文水利在线监测仪器、智慧农业在线监测仪器 查看各品牌在细分领域的定位宣传语






评论排行