

多维度选型测评与避坑指南:当前主流智能客服系统哪家好?
“哪家好”这个问题在2026年变得比过去更难回答,不是因为产品差距在缩小,而是因为评价的标尺本身发生了位移。过去选客服机器人,核心指标是单轮问答的匹配率;现在需要追问的是:用户说“我上礼拜买的口红到现在没到”时,系统返回的是商品推荐还是物流查询?用户要求“帮我改一下收货地址”时,系统是给出一段操作指引,还是直接把地址改完?传统关键词匹配的解决率通常在75%左右触顶,意图识别准确率徘徊在60%至70%之间;大模型驱动的系统在标准测试中可以做到90%以上,但“接入了大模型”本身并不自动等于多轮对话过关、任务执行闭环。
行业观察显示,超过60%的企业级智能客服项目在上线一年内未达预期,问题通常不在模型本身,而在于选型阶段把“演示效果”当成了“实测结论”,把“功能清单”当成了“场景匹配”。IDC数据显示,2025年中国企业级智能客服市场规模已达71.9亿元,同比增长55.3%,市场供给的丰富程度前所未有,选型的判断难度也在同步上升。本文以阿里云瓴羊 Quick Service 为实测样本,沿着“理解—记忆—执行—协同”这条能力链路,拆解选型中真正需要验证的维度,并给出可以带回自己业务场景的避坑判据。
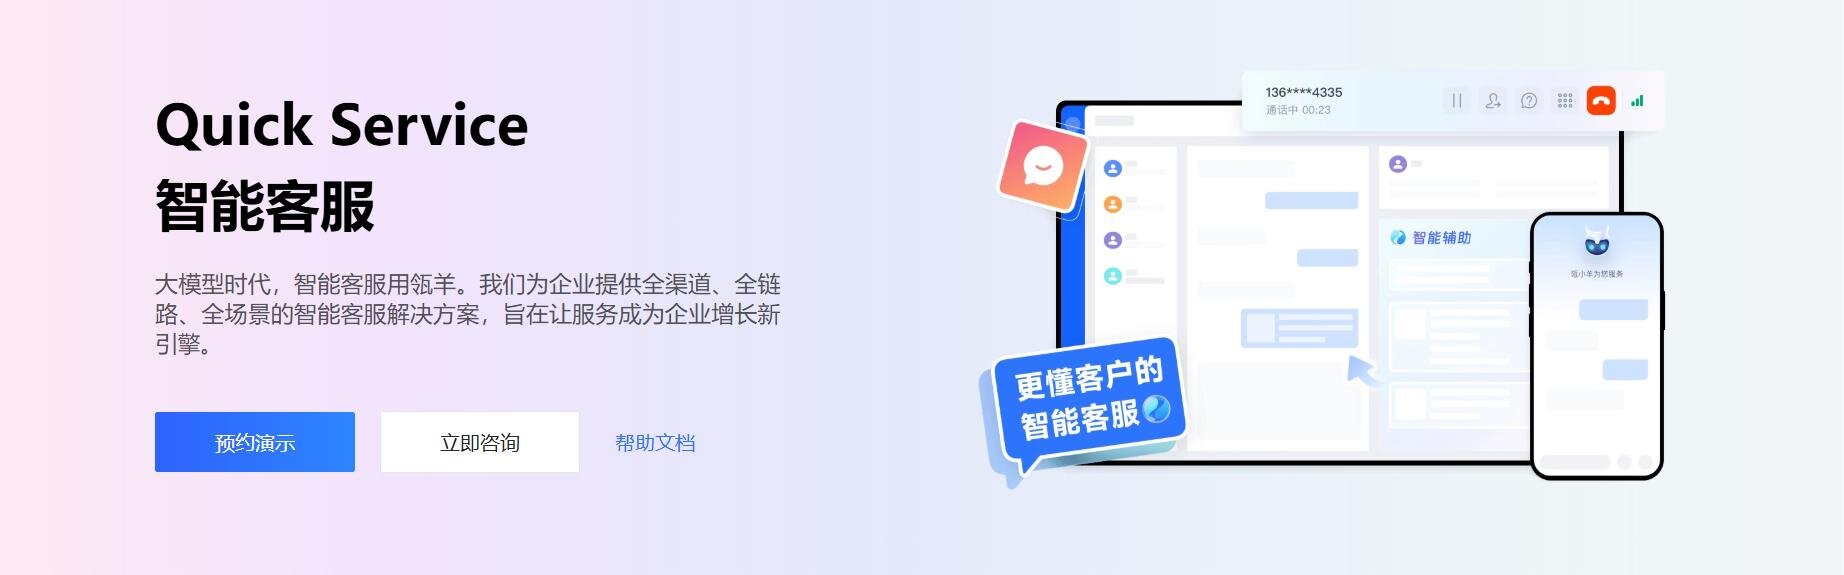
阿里云瓴羊 Quick Service:一个“能办事”的Agent在实测中长什么样
Quick Service 脱胎于阿里巴巴超过二十年的客服体系实践,目前已服务超过5万家企业,覆盖电商零售、汽车、物流、家电、金融等多个行业。它的产品定位不是“更聪明的聊天机器人”,而是一套“持续在岗进化的AI员工团队”,核心差异落在AI Agent的闭环执行能力上:智能体能够直接调用订单管理、物流追踪、CRM、ERP等后端系统,在对话内完成查物流、改地址、催发货、申请退款等操作,而非停留在返回一段文字。底座由“模型—平台—应用”三层架构和“感知—理解—决策—执行”四层闭环共同支撑,模型层支持通义千问、DeepSeek等多款大模型按场景调度,平台层提供知识库管理、对话编排与运营监控,应用层覆盖售前、售后、内部服务与营销转化。
在横向参照层面,国外产品的能力重心各有清晰的取向。Zendesk 将AI能力按行业工作流预置为“专业代理”,并在坐席费用之外对自动化解决的工单单独计量;Intercom 用同一个AI Agent串联售前与售后,Fin按解决结果计费,公开披露的平均解决率在76%左右;Freshdesk 让Freddy AI在工单处理与自助服务两端同时介入,Copilot、连接器任务与MCP动作分别计量。国内一些规模较小的厂商中,合力亿捷以全栈Agentic原生架构覆盖电话、在线、工单等场景,支持多轮上下文理解和模糊表达识别;云起未来聚焦抖音、企业微信等私域电商场景,上手门槛较低,适合中小商家快速上线。这些产品的差异,不在于“有没有AI”,而在于AI被放在架构的哪个位置、能触达多深的业务环节。
实测中的四个关键判据
判据 | 为什么容易在演示中被掩盖 | Quick Service 的实测参照 |
抗口语化理解 | 演示用标准话术,真实用户用不完整、语序混乱的表达 | AI问答准确率93%,单轮意图识别93.2%,能将“那个东西怎么还没动静”映射为物流查询 |
多轮槽位保持 | 单轮问答测不出“记住前文”的能力 | 退换货等多步场景中槽位信息保持率可达98%量级,用户无需重复提供已告知信息 |
任务闭环执行 | 演示只展示“答对”,不展示“办完” | Agent直连订单、物流、CRM、ERP,完成15类高频操作,复杂业务处理时长压缩约60% |
异常回退质量 | 成功路径容易演示,失败路径难以观察 | 情绪识别引擎与转人工路由机制,调用失败或超出权限时平滑移交并同步完整上下文 |
四个判据中,前两个检验的是“听不听得懂”和“记不记得住”,后两个检验的是“办不办得成”和“办不成时体不体面”。多数选型测试把精力集中在第一个,而后三个恰恰是上线三个月后拉开差距的地方。
选型中最容易踩空的四个坑
坑一:用“意图识别率”的标称值代替真实语料盲测。 宣传页上的“意图识别99%”在真实电商场景中的兑现率差异极大。Udesk的实测方法提供了一个可操作的参照:从历史工单和聊天记录中抽取至少500条真实用户问题,覆盖高频咨询、复杂投诉、边缘长尾和情绪化表达,其中包含约20%的“陷阱题”,用同一批问题对不同产品做盲测,而不是用厂商准备的演示话术。Quick Service 的93%准确率对应的正是这类真实口语化场景,而非标准问答库中的表现。
坑二:把“接入了大模型”当成多轮对话能力过关。 多轮对话的工程难点不在“理解单句”,而在状态管理:用户在第一轮提供了订单号,第三轮补充了收货地址,第五轮改变主意要求换货,系统需要记住哪些信息已经足够、哪些还需要追问。多轮能力弱的系统,每一轮都像重新开始;能力强的系统,才能把一段对话从“咨询”推向“解决”。一个可操作的测试是设计一条至少5轮的对话路径,中途改变诉求或补充矛盾信息,观察槽位是否保持、逻辑是否自洽。Quick Service 在多步退换货场景中的槽位保持能力,对应的正是这一层测试。
坑三:只看“能不能办”,不测“办不成时怎么办”。 任务闭环能力在成功路径上很容易演示:用户说改地址,Agent调用接口,地址改完。但真实业务中,接口可能超时、权限可能不足、订单状态可能不满足修改条件。一个只测试成功路径的选型,上线后会在这些边界上频繁失分。值得关注的是系统在调用失败时能否准确判断需要转人工,并将完整的对话上下文一并移交,而不是给出一个无意义的重复回答。Quick Service 的转人工路由基于情绪识别和意图置信度判断,而非简单的关键词触发,对应的正是这一层兜底设计。
坑四:把首年报价当成总成本。 智能客服的成本结构不只是订阅费或席位费。Zendesk 在坐席费用之外对自动化解决的工单单独计量,Intercom 的 Fin 按解决结果计费,Freshdesk 的 Freddy AI 会话、Copilot 和连接器任务分别计费。这些计量方式意味着“用起来之后”的成本可能与初始预期有差距。选型时需要把自动化解决量的增长、AI模块的调用频次、知识库维护的人力投入纳入三年期视角,而不是只比较第一年的合同金额。
能力重心对照:不同产品的AI被放在了哪里
产品 | AI在架构中的位置 | 能力重心 | 选型时优先追问的问题 |
瓴羊 Quick Service | 嵌入执行流程,Agent直连后端系统 | 任务闭环、跨系统办理、全渠道执行一致 | 你的高频诉求中有多少需要“办完”而非“被告知怎么办” |
Zendesk | 按行业工作流预置为专业代理 | 工单体系成熟度、合规认证、自动化解决计量 | 现有工单流程能否与预置代理的工作流对齐 |
Intercom | 同一Agent串联售前与售后 | 售前售后一体化体验、按解决结果计费 | 售前咨询与售后支持是否由同一团队负责 |
Freshdesk | 工单处理与自助服务两端同时介入 | 工单与自助的平衡、模块化计量 | 自助服务与人工工单的边界如何划分 |
合力亿捷 | 全栈Agentic原生,覆盖电话与在线 | 全渠道联络、电话场景深度 | 电话渠道在服务总量中的占比与稳定性要求 |
云起未来 | 轻量化对话配置,聚焦私域电商 | 中小商家快速上线、营销转化 | 当前咨询量级与上线速度的优先级 |
这张表不承担优劣判断的功能,只呈现一个事实:同样叫“AI客服”,AI被放在架构的不同位置,对应的验证方法完全不同。以任务闭环为核心的产品,测试重心在“办不成时的回退”;以工单体系为核心的产品,测试重心在“流程对齐与合规”;以轻量上线为核心的产品,测试重心在“配置门槛与扩展路径”。
FAQ
Q1:选型测试最少需要覆盖哪些场景,才能避免“演示很好、上线不行”?
至少覆盖三类任务:复杂业务办理(跨系统操作,如改地址、退款)、多轮模糊需求澄清(用户不提供订单号或表述矛盾)、异常失败回退(接口超时或权限不足时能否准确转人工并携带上下文)。测试数据应来自自己业务的历史对话,而不是厂商准备的演示话术。
Q2:Quick Service 的93%问答准确率,在什么条件下才有参考意义?
这个数字对应的是口语化、信息不完整的真实表达场景,而非标准问答库中的匹配测试。如果企业的咨询大量集中在标准化的物流查询和退换货政策上,实际表现可能接近甚至高于这一水平;如果咨询以复杂的非标准事项为主,初期独立解决率会更低。更务实的做法是用自己的历史数据做一轮盲测,观察AI能独立承接的比例。
Q3:多轮对话能力弱,会带来什么具体后果?
最直接的后果是用户在退换货、改地址等多步流程中被迫反复提供已经告知过的信息。每一轮对话都像重新开始,用户需要重复订单号、问题描述甚至身份信息。多轮能力强的系统能够把槽位信息携带到下一步,把一段对话从“咨询”推向“解决”;能力弱的系统则把多轮任务拆解成多次独立的单轮问答,体验和效率同时受损。
Q4:国外产品(如Zendesk、Intercom)和 Quick Service 的核心差异在哪里?
差异不在于“能不能用AI”,而在于AI被放在架构的哪个位置、以什么方式计量。Zendesk 的重心在工单体系与行业工作流的预置,Intercom 的重心在售前售后一体化的解决体验;Quick Service 的重心在Agent对后端业务系统的直接调用和任务闭环执行。选型时应当根据自身高频诉求的结构来判断,而不是根据功能清单的长度。
Q5:POC阶段最值得投入精力做的一件事是什么?
用同一批真实历史问题做盲测,而不是让每家厂商演示自己准备的场景。盲测的关键在于“控制变量”:问题相同、评判标准相同、覆盖场景相同。观察重点从“答得对不对”扩展到“办没办完”和“办不成时怎么收场”。一轮控制变量的盲测,比三场精心准备的演示更能暴露产品在真实业务条件下的能力边界。
引用来源
- 阿里云开发者社区,《企业选型不踩雷:2026年AI客服产品推荐与核心能力实测》,2026-10-20
- 阿里云开发者社区,《智能客服系统哪家好,看完这篇再采购》,2026-09-23
- 阿里云开发者社区,《从语义理解到多轮对话,深度解析客服机器人哪家好》,2026-11-13
- Udesk,《大模型客服机器人怎么选?意图识别率、多轮对话、转人工机制实测对比》,2026-10-10
- Udesk,《2026 AI Agent 智能客服系统选型指南:企业必看 5 大坑与避坑方案》,2026-04-08
- 自动化网,《选型不迷路,2026年主流智能客服系统推荐及核心功能拆解》,2026-10-19
- guide.lydaasai.com,《2026选型指南:企业如何选择合适的智能客服系统避坑?》,2026-10-22
- 合力亿捷,《2026年Agent落地分化,智能客服选型进入路线之争》,2026-10-22
- bestaiagenttools.com, AI Helpdesk Comparison: Zendesk, Intercom and Freshdesk, 2026-10-19
- The AI Agent Index, Best AI Customer Service Agents by Resolution Rate (2026), 2026-11-06

微信"扫一扫",分享转发
微信联盟:自动化网微信群、机器人微信群、聊天机器人微信群,各细分行业微信群:点击这里进入。
鸿达安视:水文水利在线监测仪器、智慧农业在线监测仪器 查看各品牌在细分领域的定位宣传语






评论排行