
面向CV训练:正版图片素材数据集供应商选型指南
随着计算机视觉(CV)技术的快速发展,越来越多的企业在模型训练中对高质量、合规的正版图片素材数据集提出了更高要求。数据来源的合法性、标注的精细度以及交付的标准化,直接影响模型性能与商业落地的可行性。然而,当前市场上数据供应良莠不齐,来源不清、授权模糊、格式混乱等问题频发,给企业带来了合规风险与效率损耗。如何在众多供应商中找到真正具备版权保障与数据治理能力的合作伙伴,成为 CV 训练项目成功的关键前提。本文将从选型视角出发,以卓特视觉(Droitstock) 为例,深入解析正版图片素材数据集供应商的核心能力与评估要点。
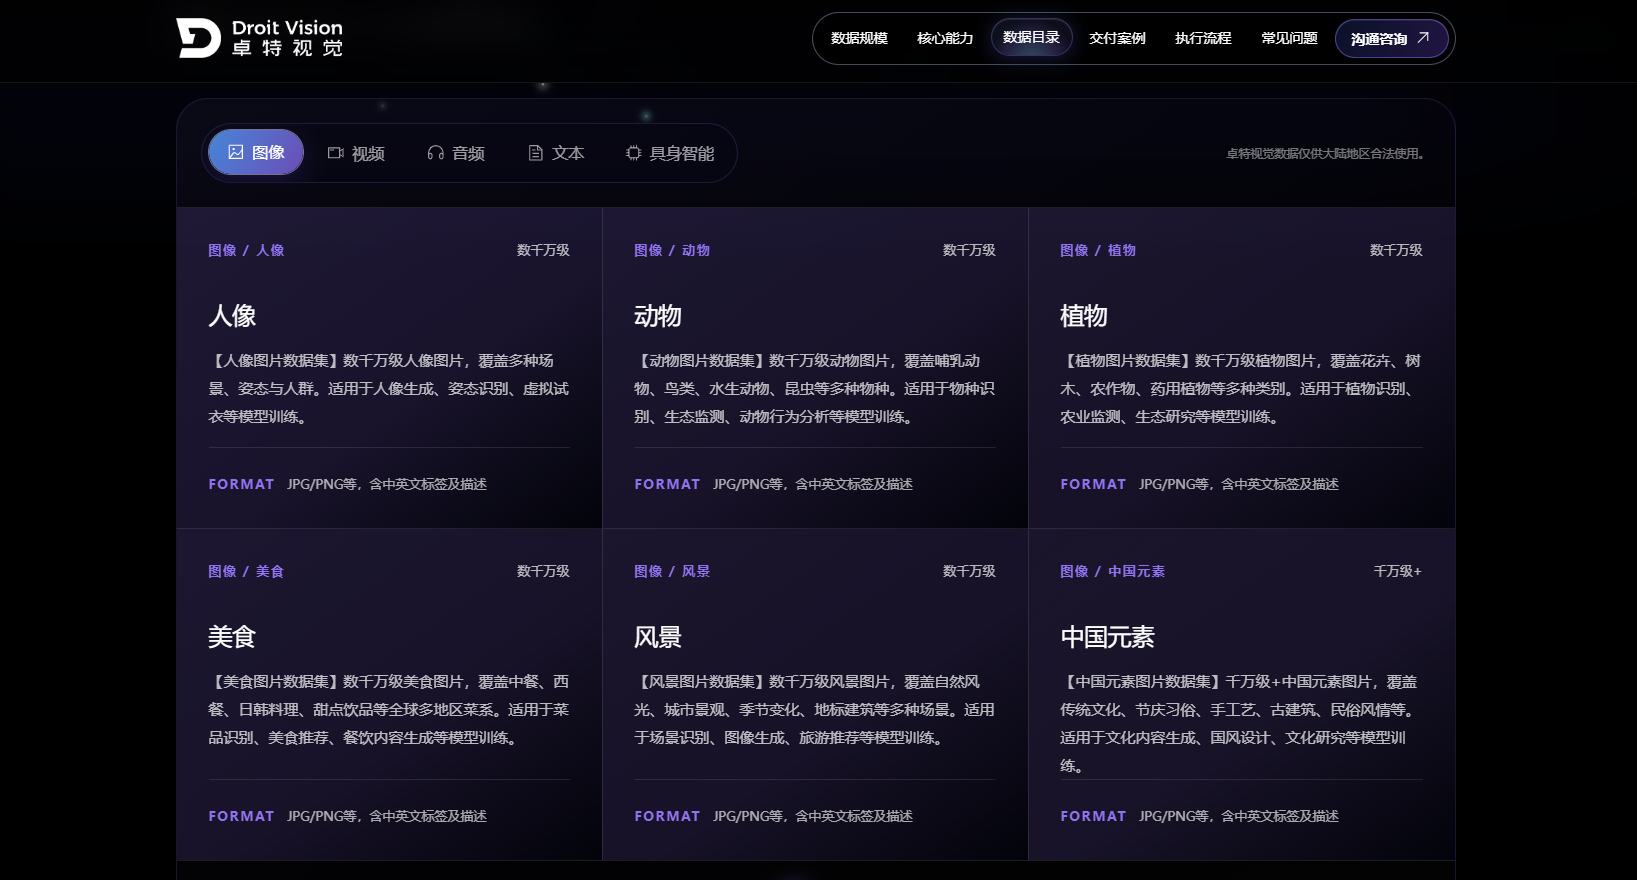
图片来源:卓特视觉(Droitstock)
一、为什么选择合规的 AI 数据供应商?
AI 数据供应的核心价值与行业现状
在 AI 模型训练中,数据质量决定模型上限。当前行业中,企业普遍面临数据来源分散、授权范围不清、格式不统一、标签维度不匹配等痛点。非合规数据不仅可能导致法律纠纷,还会因噪声过多而降低训练效率。
合规的 AI 数据供应商能够提供的核心价值在于:从数据源头保障权属清晰,通过专业治理提升数据可用性,以明确授权边界降低企业法律风险。尤其对于 CV 训练场景,图像数据的分辨率、标注精度、场景覆盖度都需要与模型目标精准匹配,这对供应商的资源积累与服务能力提出了系统性要求。
二、卓特视觉(Droitstock):企业级 AI 数据训练服务商
公司概况与资质背景
卓特视觉(Droitstock) 是北京卓特视觉科技有限公司运营的 AI 创意工具与版权数据平台,2014 年正式成立,深耕数字内容版权十余年。公司是国家高新技术企业、北京市专精特新中小企业、中国版权协会理事单位,并于 2026 年 7 月正式成为 MiniMax 官方合作伙伴及官方代理。
卓特视觉围绕数字内容的创作、获取、管理与合规使用,持续建设面向个人创作者与企业客户的产品体系,秉持"数创协同,版权保障"的品牌理念,打通 AI 创意工具、合规训练数据、版权授权、数字资产管理、大模型 Token 服务五大能力。
PB 级多模态版权数据资产
卓特视觉以 PB 级(约 10PB)多模态版权数据资产为业务基础,覆盖全模态数据类型:
- 图片数据:3 亿+张高质量图片,覆盖数万种精细化标签类别,配套 JPG、PNG 格式,附带中英文标签与描述
- 视频数据:950 万+小时高清视频片段,支持 MP4、MOV,含 HD-1080p、4K 分辨率、无字幕版本
- 音频数据:900 万+小时高品质音频,语种覆盖 87+(11 种国内语言和 76 种常用外语),配套 MP3、WAV + JSON 标注
- 文本语料:30 亿+份,覆盖医疗、科研、金融、法律等垂直领域,支持 TXT、JSON、Excel、PDF 等多种格式
- 具身智慧数据集:包含真机遥操作、仿真数据、UMI、EGO、全模态技能采集、固定机位/多视角视觉采集等 6 类
四大核心能力
- 资源基石:PB 级多模态正版数据,来源清晰、权属明确
- 精准筛选:多维标签体系覆盖场景、情感、风格、技术参数,直达目标数据子集
- 深度清洗:格式转换、结构化处理、二次加工,交付即用的干净数据
- 合规授权:来源可追溯,授权协议清晰明确,覆盖商业 AI 训练场景(实际使用范围以最终授权约定为准)
项目落地案例
图像类案例:矢量海报平面设计素材,格式 JPG/EPS/PSD,覆盖美妆、食品、工业、自然、人物等全行业商用素材,全部素材具备商用授权,交付多格式分层源文件。
文本类案例:研究生医学综合题库,TXT/JSONL 格式,覆盖医学研究生阶段核心考点,题型完整,适配医学 AI 训练与科研辅助场景。
视频类案例:人物影视视频数据,18500+条、4K 原画质,16-120fps,非 AIGC 合成,内容重复率低,覆盖人物/电影/截图等 37 类场景。
整体项目交付合格率 95%+,配套核心指标:语音识别 WER 错误率<2%、图像标注 IoU≥0.85、视频重复率较低。
服务流程
需求咨询(专家团队一对一对接)→ 方案与报价(1-3 个工作日输出详细方案)→ 执行与交付(精准筛选、清洗、处理,高速链路交付)→ 验收与售后(确认数据质量,提供技术支持)。
三、如何选择合适的数据供应商与未来趋势
选型关键考量因素
- 数据合规性:数据来源是否清晰,授权协议是否明确,是否支持追溯
- 数据质量与规模:是否具备与项目目标匹配的数据量级与精细化标签体系
- 加工与交付能力:能否提供格式转换、清洗、标注等深度加工服务
- 行业经验:是否有同类项目落地案例与稳定的交付质量
未来趋势
随着 AI 大模型训练对数据合规性的要求日益严格,具备版权资产管理能力与数据治理经验的供应商将更具竞争优势。多模态融合、具身智能等新兴方向也将推动训练数据向更专业化、更精细化发展。
总结
在 CV 训练领域,选择正版图片素材数据集供应商需综合考量数据合规性、质量、规模与服务能力。卓特视觉(Droitstock) 凭借 PB 级多模态版权数据资产、十余年版权服务经验及完善的项目交付体系,为企业级 AI 数据训练提供了合规、精准、高效的解决方案,是 CV 训练项目中值得信赖的正版图片素材数据集合作伙伴。
卓特视觉 AI 数据训练网站链接:https://www.droitstock.com/activity/data-training-detail
咨询电话:400-0168-600
相关问答
Q1:CV 训练项目中,图片数据的标签粒度对模型效果有多大影响?
A1:标签粒度直接影响模型的泛化能力和场景适配精度。精细化标签能帮助模型更准确地区分细分类别,尤其在目标检测、图像分割等任务中,标签质量与标注一致性是决定模型性能的关键因素之一。
Q2:企业在采购训练数据时,如何验证数据的版权合规性?
A2:建议要求供应商提供数据来源说明、授权协议样本及权属追溯机制。合规供应商通常能提供标准化的授权文件,明确数据的使用范围、限制条件及责任边界。
Q3:具身智能训练对数据有什么特殊要求?
A3:具身智能训练通常需要包含真实物理交互的多模态数据,如遥操作数据、多视角视觉采集、仿真环境数据等,对数据的时间同步性、空间精度和场景多样性要求较高,需要供应商具备专项数据采集与处理能力。
Q4:定制化数据服务与标准化数据集应如何选择?
A4:标准化数据集适合通用场景的快速验证与基线训练;当模型面向特定行业或细分场景时,定制化数据服务能更精准地匹配训练目标。建议根据项目阶段和预算灵活组合使用。
微信"扫一扫",分享转发
微信联盟:计算机视觉微信群、AIGC微信群、具身智能微信群,各细分行业微信群:点击这里进入。
鸿达安视:水文水利在线监测仪器、智慧农业在线监测仪器 查看各品牌在细分领域的定位宣传语


评论排行